Tecnología · GUÍA PRÁCTICA
¿multiprocessing.Queue de Python se bloquea en join? Mapea feeder y drenaje
Distingue las esperas del proceso, del feeder y de tareas pendientes antes de reordenar el cierre o aceptar pérdida deliberada.
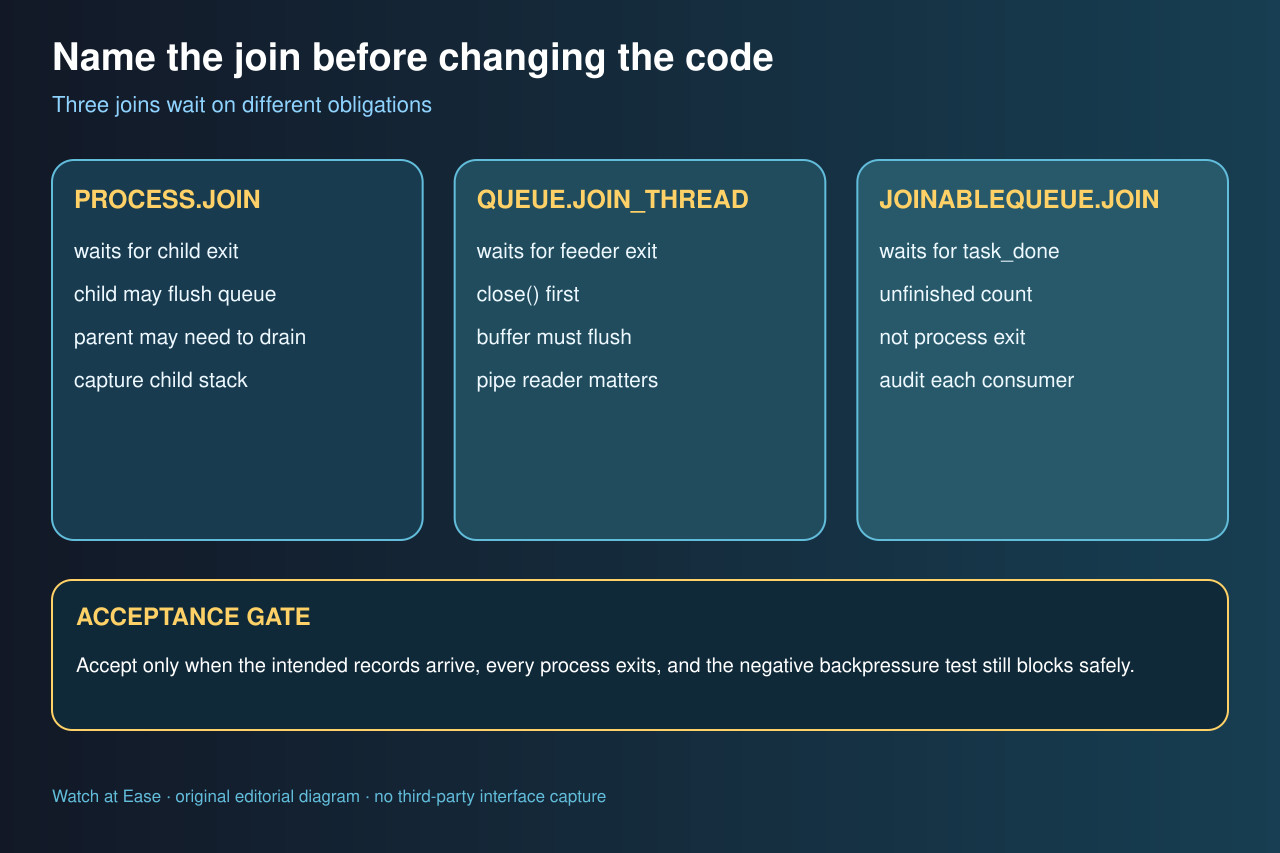
Un hijo puede terminar su función y seguir vivo porque el feeder de Queue intenta vaciar bytes a una tubería que nadie consume. El join visible es el final de la cadena de espera.
Identifica el join exacto, dibuja la propiedad entre writer, feeder, pipe y reader, y solo entonces reordena el drenaje y el cierre.
1. Identifica el join exacto que está bloqueado
Captura pilas antes de terminar nada. Process.join espera la salida del hijo; Queue.join_thread espera al feeder tras close; JoinableQueue.join espera cada task_done. Comparten nombre, no obligación.
Registra método de inicio, versión, sistema, tipo de cola, creador, productores, consumidores y el último put/get/task_done; qsize no es evidencia fiable.
2. Dibuja la espera writer–feeder–pipe–reader
Después de put, un feeder en segundo plano serializa y escribe en la tubería. Si se llena porque nadie lee, el feeder se bloquea y el productor puede seguir vivo esperando el vaciado.
Enumera extremos de lectura y escritura, quién cierra, quién envía sentinelas y quién debe seguir leyendo. La capacidad finita nunca debe ser una hipótesis de corrección.
3. Repara el orden según el contrato de propiedad
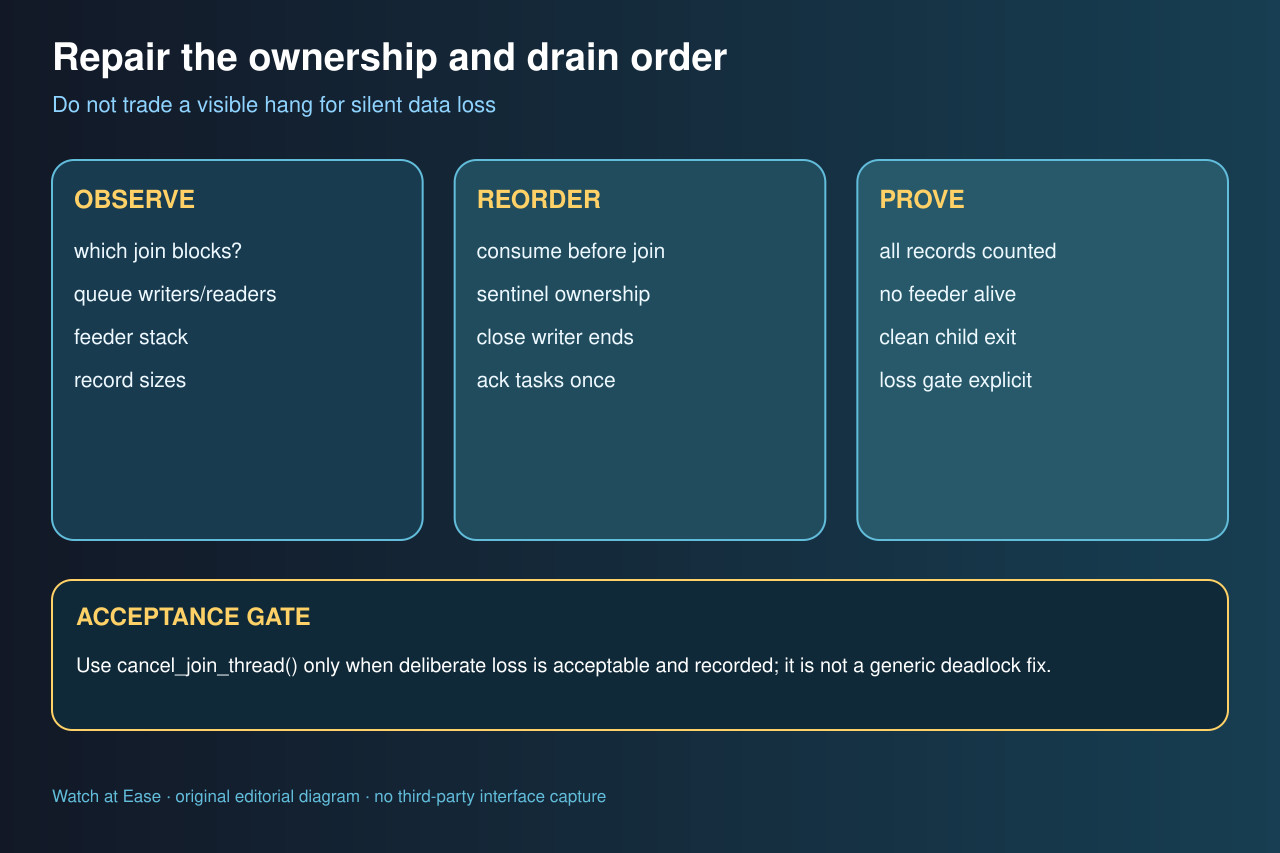
Consume resultados mientras viven los workers; no hagas join de todos los productores antes de drenar. Detén trabajo nuevo, envía sentinelas definidos, drena resultados, cierra escritores y luego une feeder y procesos según el grafo.
En JoinableQueue, cada get exitoso necesita exactamente un task_done, incluso con excepciones; join no debe bloquear al consumidor que reduce el conteo pendiente.
4. Trata cancel_join_thread y terminate como decisiones de pérdida
cancel_join_thread permite salir sin esperar el vaciado y puede perder datos. Úsalo solo con descarte intencional, documentado y probado.
terminate o kill también pueden interrumpir estado interno o bytes en vuelo; define antes qué registros se repiten, deduplican o abandonan.
5. Demuestra salida limpia y entrega completa
Prueba con carga superior a la capacidad normal de tubería, compara IDs producidos y consumidos y usa el mismo método de inicio del despliegue. Éxito exige registros completos, feeders terminados, códigos correctos y sin corrupción.
Pausa al lector como prueba negativa: debe aparecer backpressure limitado o timeout controlado, nunca pérdida silenciosa.