科技 · 實用指南
minidom 不斷增加空行?刪空白前先驗證正文未改變
XML 外觀更整齊,文字卻可能不同。重現儲存循環、核對 Python 版本,再比較語義內容後取代原檔。
不要靠刪除所有空行修復持續變大的 XML。先證明哪些空白可捨棄,並確認目前序列化器是否改變正文;檔案仍能解析,不代表含義未流失。
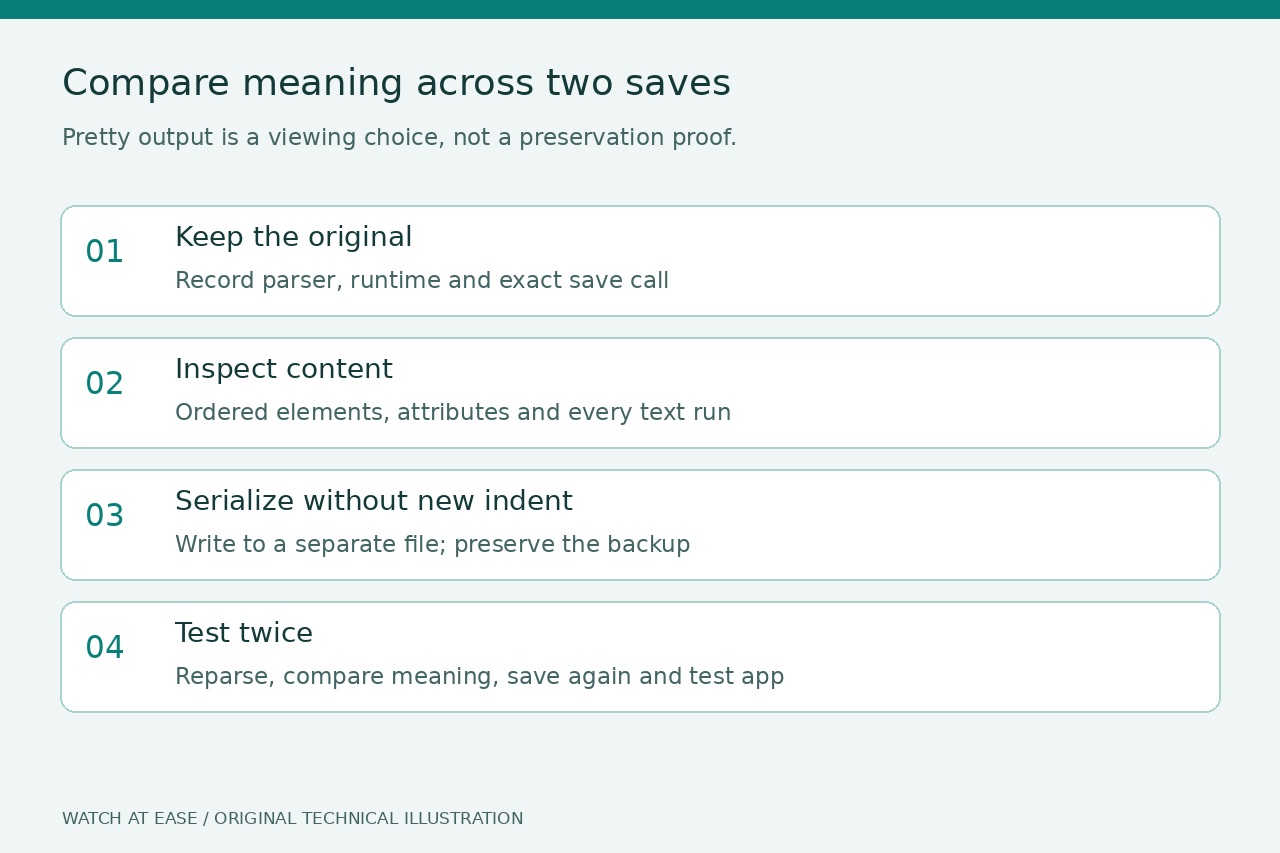
1. 保留儲存循環與執行環境
保留原檔及可丟棄副本。記錄 sys.version、解析器、序列化呼叫、indent/newl 參數,以及輸入是否已有縮排。不進行編輯,重複相同的解析、編輯、序列化流程;若輸出仍增加,問題指向格式化,而非新增元素。
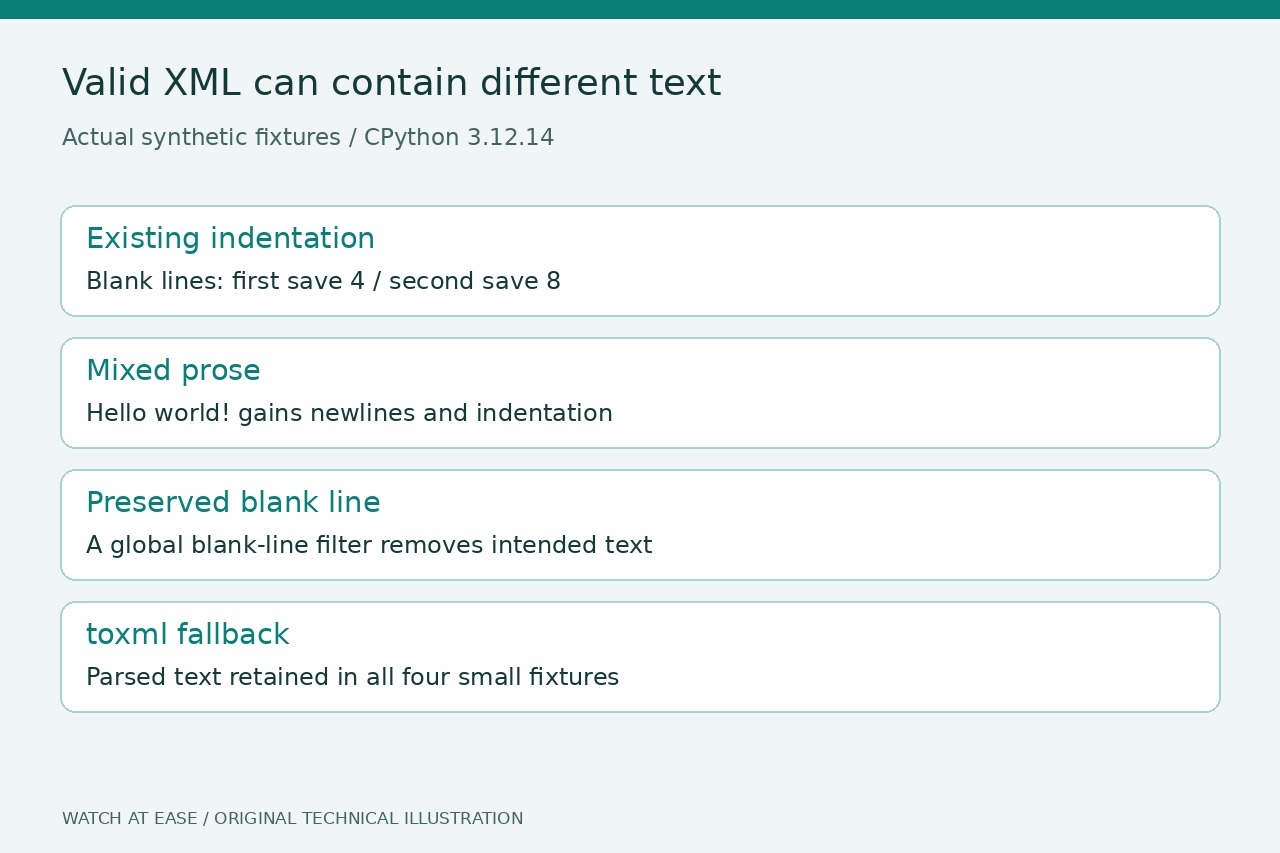
我們的 CPython 3.12.14 樣本含已有縮排的根節點與一個 item。第一次 toprettyxml(indent=' ') 後有 4 個空白行,重新解析並輸出後有 8 個。這些數字只屬於這個小樣本,不適用所有 XML。
2. 把空白視為可能的正文
混合內容樣本 <p>Hello <b>world</b>!</p> 的後代文字從 Hello world! 變成含新增換行與縮排的文字。另一組 <p><b>A</b> <b>B</b></p> 也改變了原本一個空格的分隔。只計算標籤或確認可解析,皆會漏掉這兩種變化。
含刻意空行、帶 xml:space='preserve' 的樣本在 3.12.14 仍被重新排版;以 if line.strip() 篩選美化輸出又刪除了該空行。W3C 將 preserve 定義為向後代繼承、除非被覆寫的保留意圖。這不能證明每個已安裝的美化器都實作了該意圖。
3. 選擇有明確邊界的修復
在已測版本中,若無法確定空白含義,可用 toxml(encoding='utf-8') 序列化編輯後的 DOM,將位元組寫到新檔。它避免新增美化縮排,但不會刪除已有空白,也無法復原先前儲存時改掉的內容。4 組樣本皆保留解析後的後代文字,第二次解析並 toxml 產生相同序列化結果。
將排版閱讀副本與儲存文件分開。只有文件內容模型或應用程式約定證明某些節點的排版可忽略時,才刪除那些節點。lxml FAQ 明確說明,缺乏確定知識時 remove_blank_text 使用啟發式判斷;換函式庫不會自動證明內容保留。
4. 依含義驗收,而非外觀
Python 3.16 開發文件記錄了混合內容與 xml:space='preserve' 處理變更。不要把該說明當成 3.12 的行為,也別以為升級能復原已改變的文字。我們只執行了 3.12.14;預計改用哪個版本,就在該確切版本重跑代表樣本。
取代原檔前,重新解析候選檔,比較有序元素、屬性及每段文字,包含受保護或混合內容裡純空白的文字段;僅允許明確核准的排版例外。再測第二次儲存及實際讀取的應用程式,保留備份。toxml 不保證原位元組不變,也不是正規化或簽章、實體寫法及全部文件特性的保證。這些可信合成樣本並非不可信 XML 的安全處理方案。