科技 · 实用指南
minidom 不断增加空行?删空白前先验证正文没有改变
XML 看起来更整齐,文字却可能不同。复现保存循环、核对 Python 版本,再比较语义内容后替换原文件。
不要用删除所有空行来修复不断变大的 XML。先证明哪些空白可丢弃,并确认当前序列化器是否改变正文;文件仍能解析,不代表含义没有丢失。
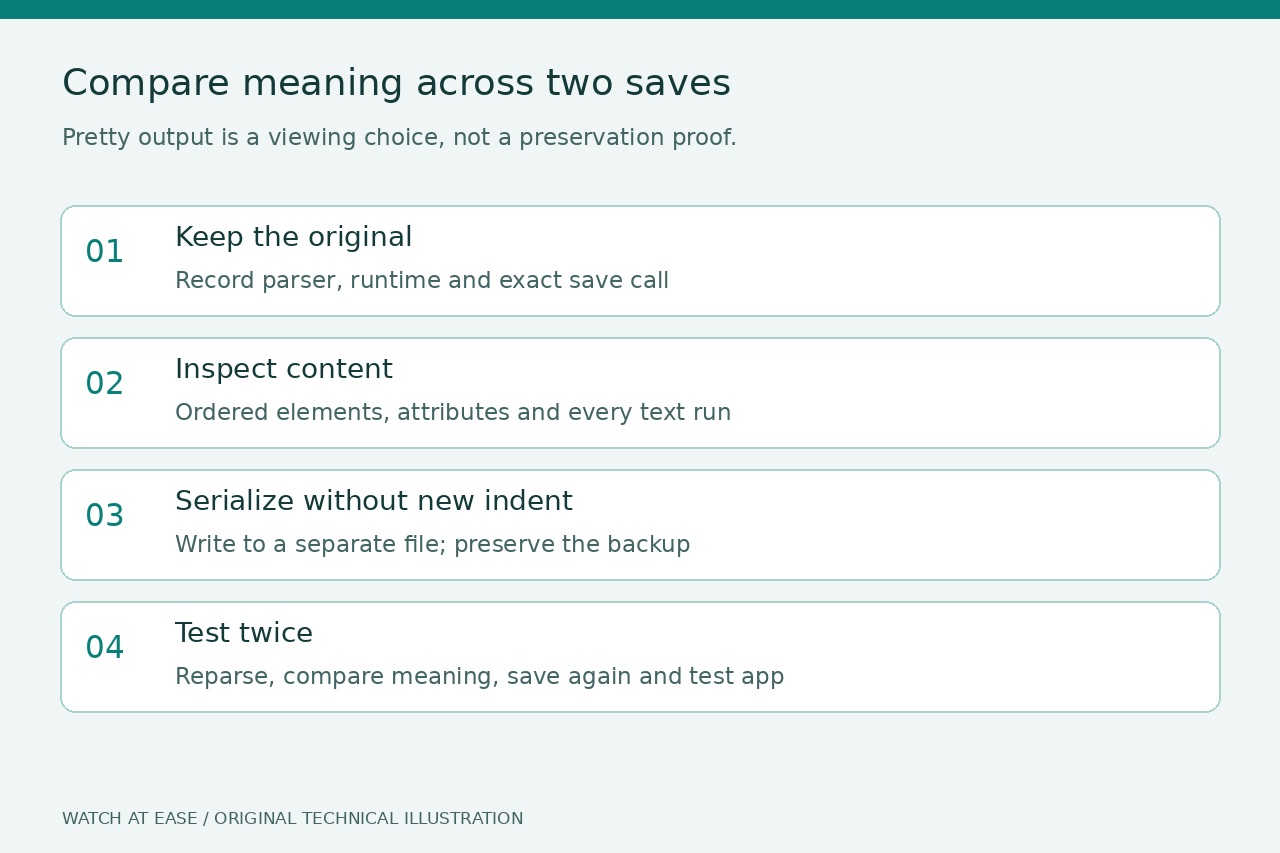
1. 保留保存循环与运行环境
保留原文件和可丢弃副本。记录 sys.version、解析器、序列化调用、indent/newl 参数,以及输入是否已有缩进。不做任何编辑,重复同样的解析、编辑、序列化流程;若输出仍增长,问题指向格式化,而非新增元素。
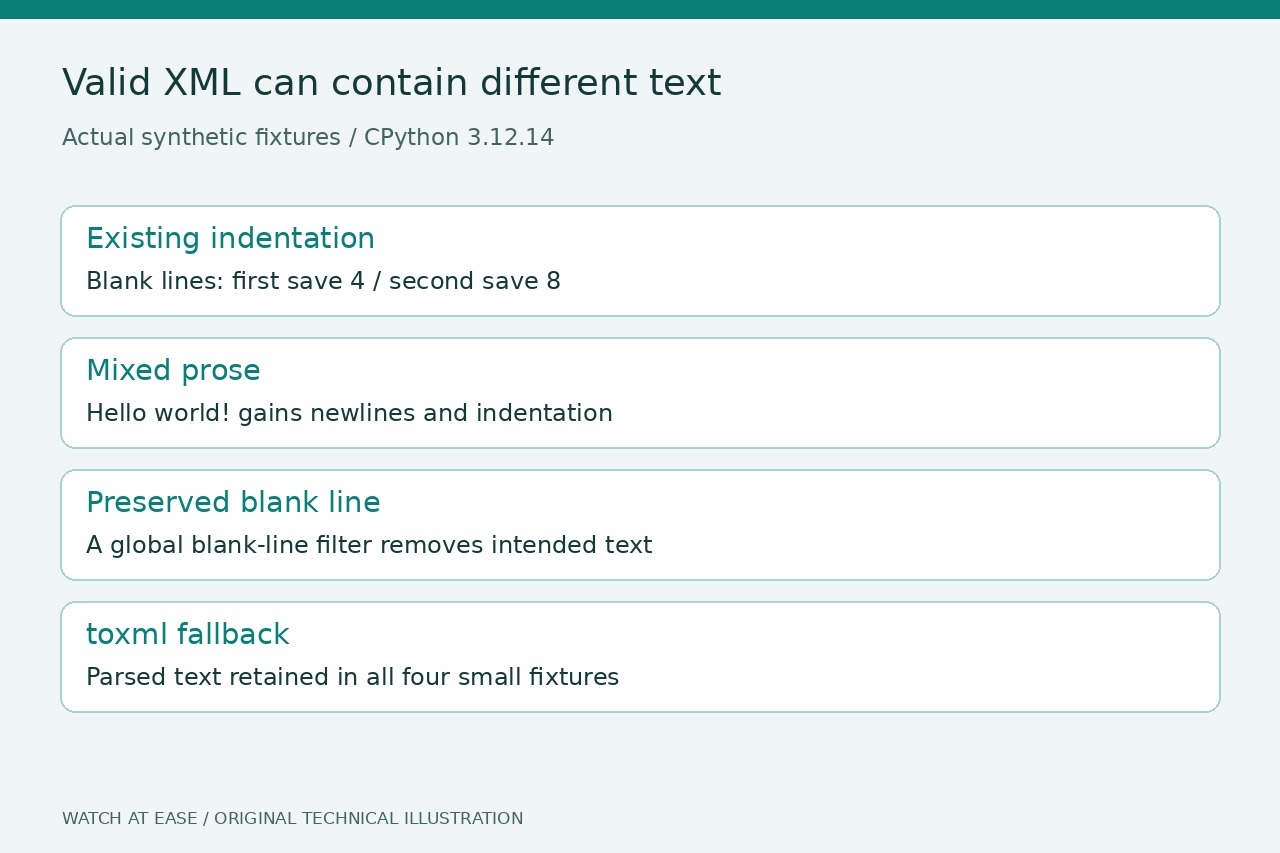
我们的 CPython 3.12.14 样本含已有缩进的根节点和一个 item。第一次 toprettyxml(indent=' ') 后有 4 个空白行,重新解析并打印后为 8 个。这些数字只属于这个小样本,不适用于所有 XML。
2. 将空白视为可能的正文
混合内容样本 <p>Hello <b>world</b>!</p> 的后代文字从 Hello world! 变成含新增换行和缩进的文字。另一组 <p><b>A</b> <b>B</b></p> 也改变了原来一个空格的分隔。只统计标签或检查能否解析,都看不出这两种变化。
含有意空行、带 xml:space='preserve' 的样本在 3.12.14 仍被重新排版;用 if line.strip() 过滤美化输出又删除了那条空行。W3C 将 preserve 定义为向后代继承、除非被覆盖的保留意图。这不能证明每个已安装的美化器都实现了该意图。
3. 选择有明确边界的修复
在已测试版本中,若不确定空白含义,可用 toxml(encoding='utf-8') 序列化编辑后的 DOM,将所得字节写入新文件。它避免新增美化缩进,却不会删除已有空白,也不能恢复之前保存时改掉的内容。4 组样本均保留了解析后的后代文字,第二次解析并 toxml 得到相同序列化结果。
把排版阅读副本与存储文档分开。只有文档内容模型或应用约定证明某些节点的排版可忽略时,才删除这些节点。lxml FAQ 明确说明,缺乏确定知识时 remove_blank_text 使用启发式判断;换库并不自动证明内容得到保留。
4. 按含义验收,而非外观
Python 3.16 开发文档记录了混合内容与 xml:space='preserve' 处理的变化。不要把该说明当成 3.12 的行为,也不要认为升级能修复已经改变的文字。我们只执行了 3.12.14;拟换用哪个版本,就在该确切版本重跑代表样本。
替换原文件前,重新解析候选文件,比较有序元素、属性和每段文字,包括受保护内容或混合内容里的纯空白文字段;只允许明确批准的排版例外。再测试第二次保存和实际消费它的应用,并保留备份。toxml 不保证原字节不变,也不是规范化或签名、实体写法及全部文档特性的保证。这些可信合成样本不是处理不可信 XML 的安全方案。