テクノロジー · 実用ガイド
minidom で空行が増える?削除前に本文の保持を検証
整ったXMLでも文字は変わることがあります。保存の反復とPython版を確認し、意味を比較してから元ファイルを置き換えます。
増え続けるXMLの対策として空行を全部削除しないでください。破棄可能な空白と、使用中のシリアライザーが本文を変えるかを先に確認します。解析できても意味が失われている場合があります。
1. 保存手順と実行環境を固定する
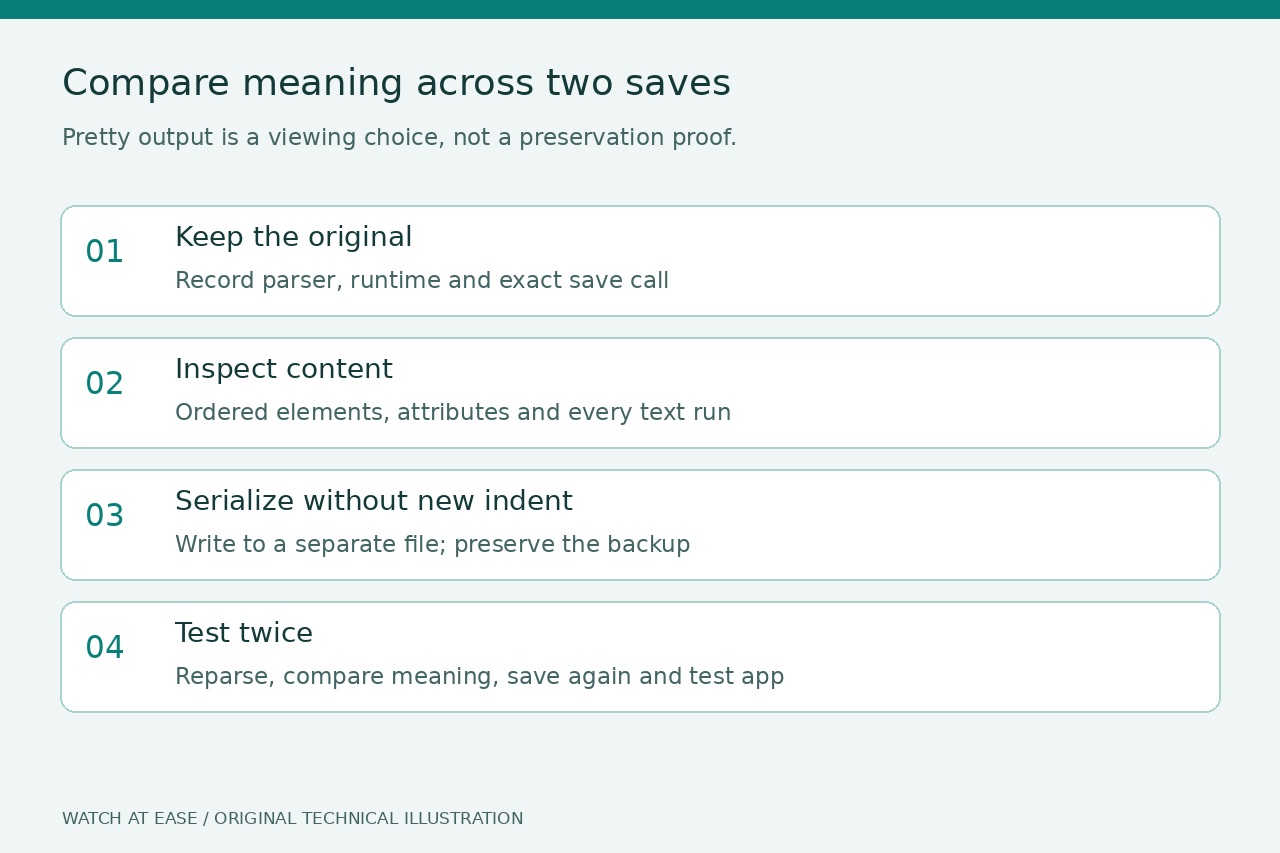
元ファイルと使い捨てコピーを残します。sys.version、パーサー、シリアライズの呼び出し、indent/newl、入力が整形済みかを記録します。変更を加えず同じ解析・編集・保存の周期を繰り返し、それでも増えるなら新要素ではなく整形を調べます。
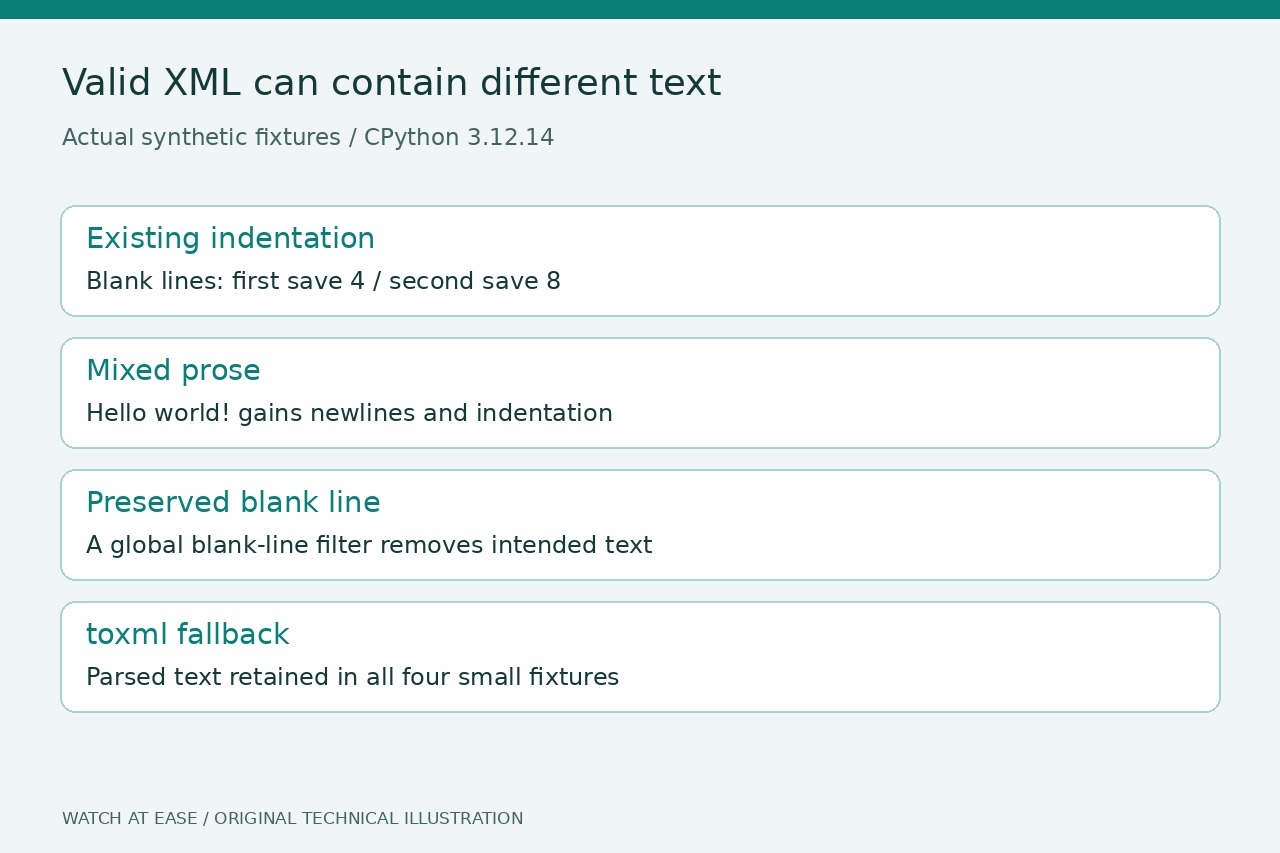
CPython 3.12.14で、字下げ済みのrootと一つのitemを試すと、最初のtoprettyxml(indent=' ')後は空白行が4本、再解析後の再出力では8本でした。この数は小さな検証例の結果で、すべてのXMLに当てはまりません。
2. 空白も本文の可能性がある
<p>Hello <b>world</b>!</p>では、子孫テキストHello world!に改行と字下げが追加されました。別の<p><b>A</b> <b>B</b></p>でも、一つの空白による区切りが変わりました。タグ数や解析の成功だけでは、どちらも検出できません。
意図的な空行を含むxml:space='preserve'付きの例も3.12.14では整形されました。if line.strip()で出力を絞ると、その空行も消えます。W3Cのpreserveは、上書きされない限り子孫へ継承される保持の意図です。全インストール版の整形器が従う証明ではありません。
3. 全行フィルターより範囲を決めた修復を
検証した版で空白の意味が不明なら、編集したDOMをtoxml(encoding='utf-8')で出力し、バイト列を新ファイルへ書きます。新たな字下げは避けますが、既存の空白は消さず、以前の保存で変えた内容も戻しません。4例すべてで解析後の子孫テキストを保持し、二回目の解析・toxmlでも同じ出力でした。
閲覧用の整形コピーと保存文書を分けます。内容モデルかアプリの契約で無視可能と決まった場所だけ配置ノードを削除してください。lxml FAQは、確実な知識がなければremove_blank_textがヒューリスティックを使うと明記しています。ライブラリー変更だけでは保持の証明になりません。
4. 見た目ではなく意味で合格させる
Python 3.16開発版の文書には混在内容とxml:space='preserve'の処理変更があります。3.12の動作だと思わず、更新で既に変わった本文が戻るとも考えないでください。実行したのは3.12.14だけです。候補の実際の版で代表例を再検証します。
置換前に候補を再解析し、要素の順序、属性、すべてのテキスト区間を比較します。保護領域や混在内容の空白だけの区間も含め、承認済みの配置例外だけを認めます。二度目の保存と利用アプリも試し、バックアップを残します。toxmlは元バイトの完全保持、正規化、署名や実体表記、全機能の保証ではありません。信頼できる合成例であり、信頼できないXMLの安全処理レシピでもありません。