기술 · 실용 가이드
Python JSONDecodeError: Extra data? 파싱 전에 레코드 경계를 확인하세요
첫 JSON 값은 유효해도 뒤에 다른 내용이 남을 수 있습니다. 원본 바이트를 보존하고 단일 문서, JSON Lines, 연속 값을 구분한 뒤 전체 입력을 검증하세요.
Extra data는 Python이 완전한 JSON 값 하나를 디코딩한 뒤 공백이 아닌 내용을 만났다는 뜻입니다. 이 오류만으로 파일이 JSON Lines이거나 2행이 안전한 레코드라고 단정할 수 없습니다. 파서를 선택하거나 파일을 고치기 전에 원본 바이트와 생성자의 프레이밍 계약을 확인해야 합니다.
증거를 보존하고 뒤쪽 형식을 분류하세요
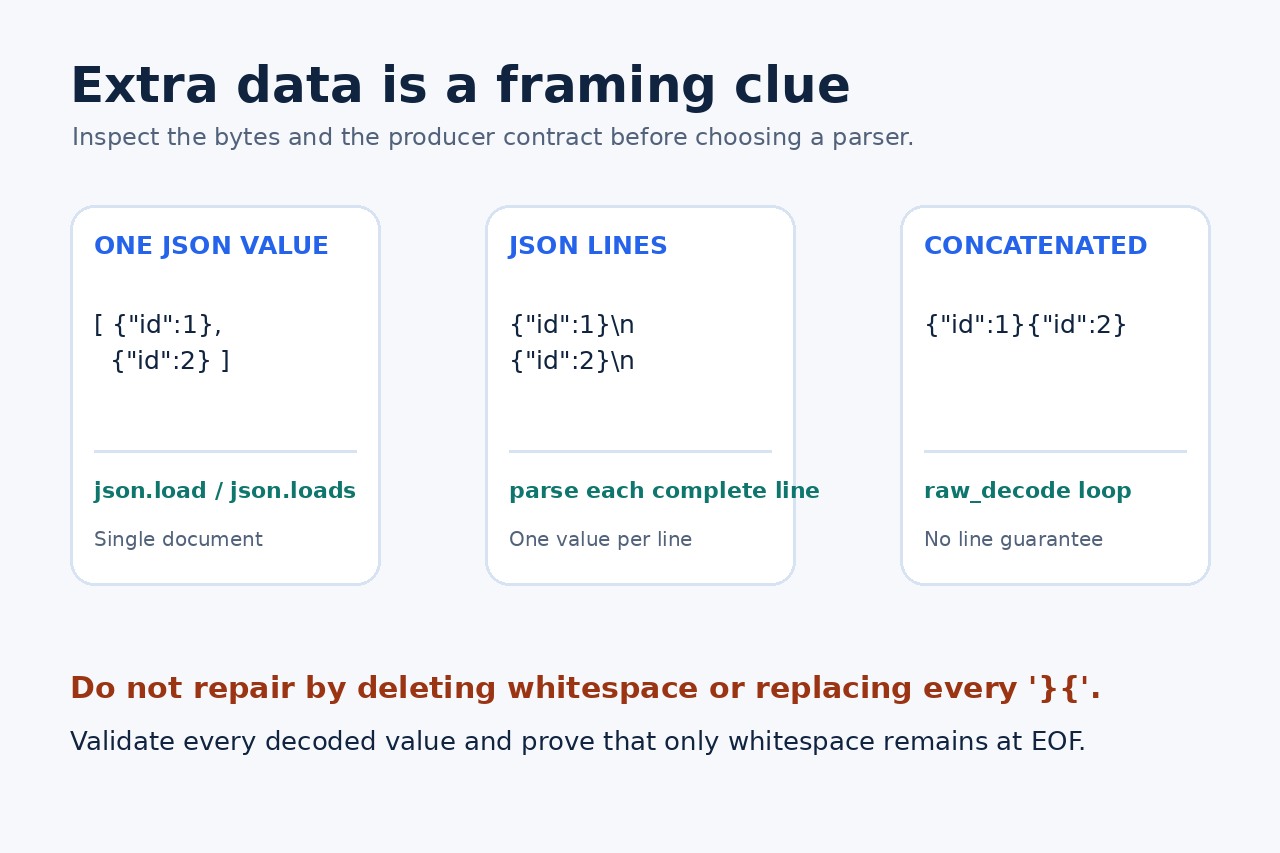
실험 전에 원본 파일을 복사하거나 해시하세요. 입력 인코딩, BOM 여부, 예외 메시지, pos, lineno, colno와 실패 지점 주변의 이스케이프된 미리보기를 기록합니다. 공백을 삭제하거나 모든 }{를 바꾸거나 원문에 대괄호를 씌우면 문자열을 바꾸고 손상을 숨길 수 있습니다.
디코딩된 텍스트에서 JSONDecoder.raw_decode로 첫 값이 끝나는 위치를 찾고 나머지만 검사하세요. 공백만 남으면 단일 문서입니다. 다른 값이 시작되면 생성자가 줄마다 하나의 완전한 값, 구분자 없는 연속 값, 또는 실수로 붙은 바이트 중 무엇을 약속하는지 확인하세요. 오류 행만으로 파서를 결정하지 않습니다.
레코드 계약에 맞는 파서를 고르세요
단일 JSON 문서는 json.load 또는 json.loads로 엄격히 검사합니다. 최상위 객체, 배열, 문자열, 숫자, 불리언, null은 모두 하나의 값이며 설명되지 않는 뒤쪽 데이터는 오류로 남겨야 합니다. 컬렉션 생성자를 제어한다면 단일 최상위 배열이 가장 이식성 높은 JSON 표현입니다.
JSON Lines는 모든 물리적 줄이 완전한 JSON 값일 때만 UTF-8로 한 줄씩 파싱합니다. 객체, 배열과 스칼라는 가능하지만 빈 줄은 허용되지 않습니다. 여러 줄로 보기 좋게 출력한 객체는 한 JSON Lines 레코드가 아니므로 줄별 파싱에 실패합니다.
구분자를 추측하지 말고 연속 값을 소비하세요
생성자가 줄 경계 없이 JSON 값을 연속 출력하는 계약이라면 공백을 건너뛰는 raw_decode 루프로 각 값과 끝 문자 인덱스를 얻을 수 있습니다. 모든 레코드의 예상 타입이나 스키마를 검증하고 실패 시 레코드 번호와 시작 인덱스를 남기며, 마지막에는 공백 뒤 정확한 EOF를 요구합니다.
raw_decode는 JSON 문서로 시작하는 문자열을 받지만 자동으로 제한된 스트리밍 리더가 되지는 않습니다. 큰 파일에는 설계된 버퍼링이나 검토된 스트리밍 파서가 필요합니다. }{를 전역 치환하면 문자열 내부도 바뀔 수 있으므로 사용하지 마세요.
문자 위치를 바이트로 매핑하고 변환 전에 검증하세요
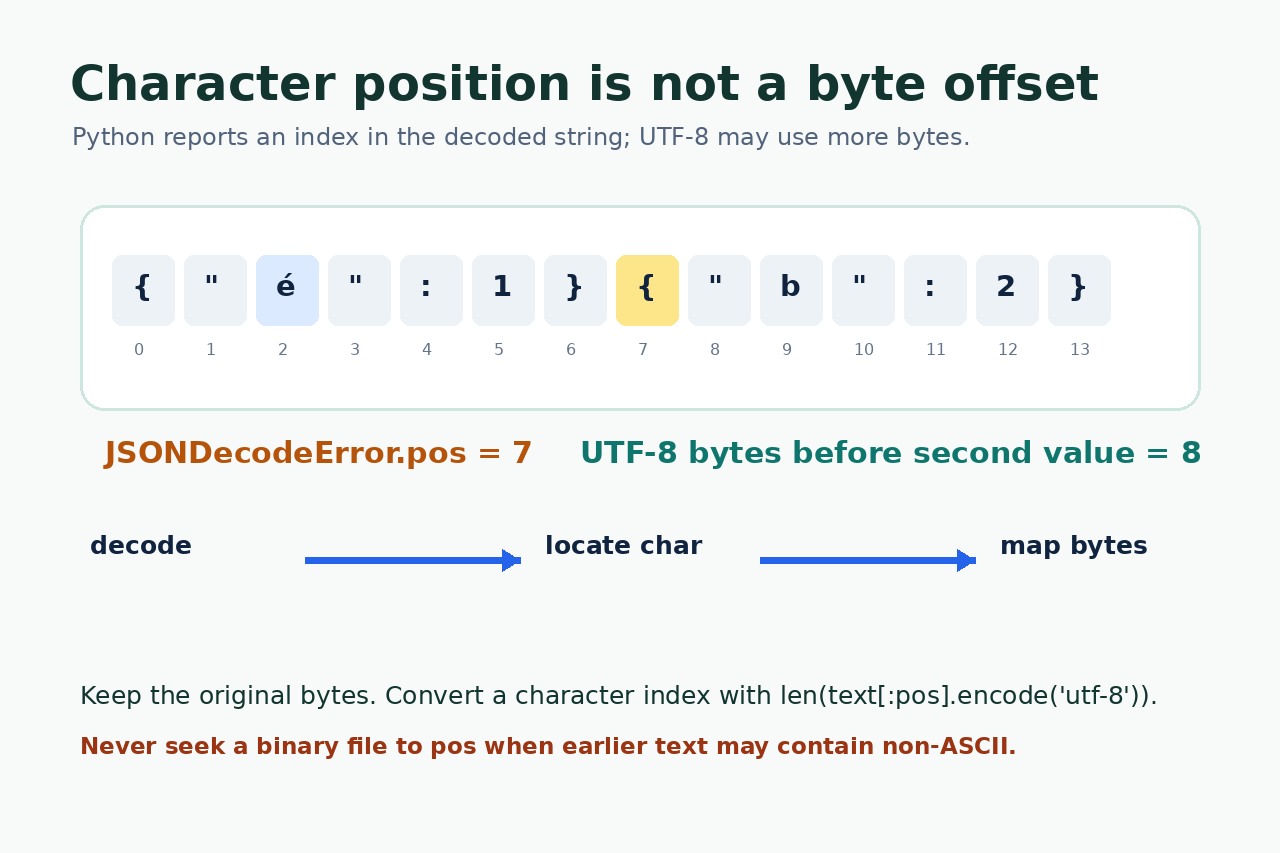
Python 문서에서 JSONDecodeError.pos는 doc의 시작 인덱스이고 lineno와 colno는 디코딩된 문자열에서 계산됩니다. Python 3.12.14 시험에서 {"é":1}{"b":2}는 pos 7이었지만 두 번째 값 전에는 UTF-8 바이트가 8개였습니다. len(text[:pos].encode("utf-8"))로 변환하고 앞부분에 비ASCII 문자가 있으면 pos로 바이너리 파일을 직접 seek하지 마세요.
같은 시험에서 실제 JSON Lines는 2행 1열, 붙어 있는 값은 1행 8열, 보기 좋게 출력한 두 객체는 4행 1열에서 Extra data가 났습니다. raw_decode는 세 시퀀스를 모두 소비했지만 줄별 방식은 JSON Lines에만 성공했습니다. 모든 값의 문법과 업무 검증, 완전한 끝 소비, 레코드 수 일치를 확인한 뒤 새 임시 배열이나 JSON Lines로 직렬화하고 원본을 보존하세요.