技术 · 实用指南
Python CSV分不清None和空字符串?先查运行版本与交换约定
有这个引号选项,不代表读取端已经实现其行为。20项本地测试区分可解决的解析问题、不可逆的导出丢失,以及仅适用于文本或缺失值的替代约定。
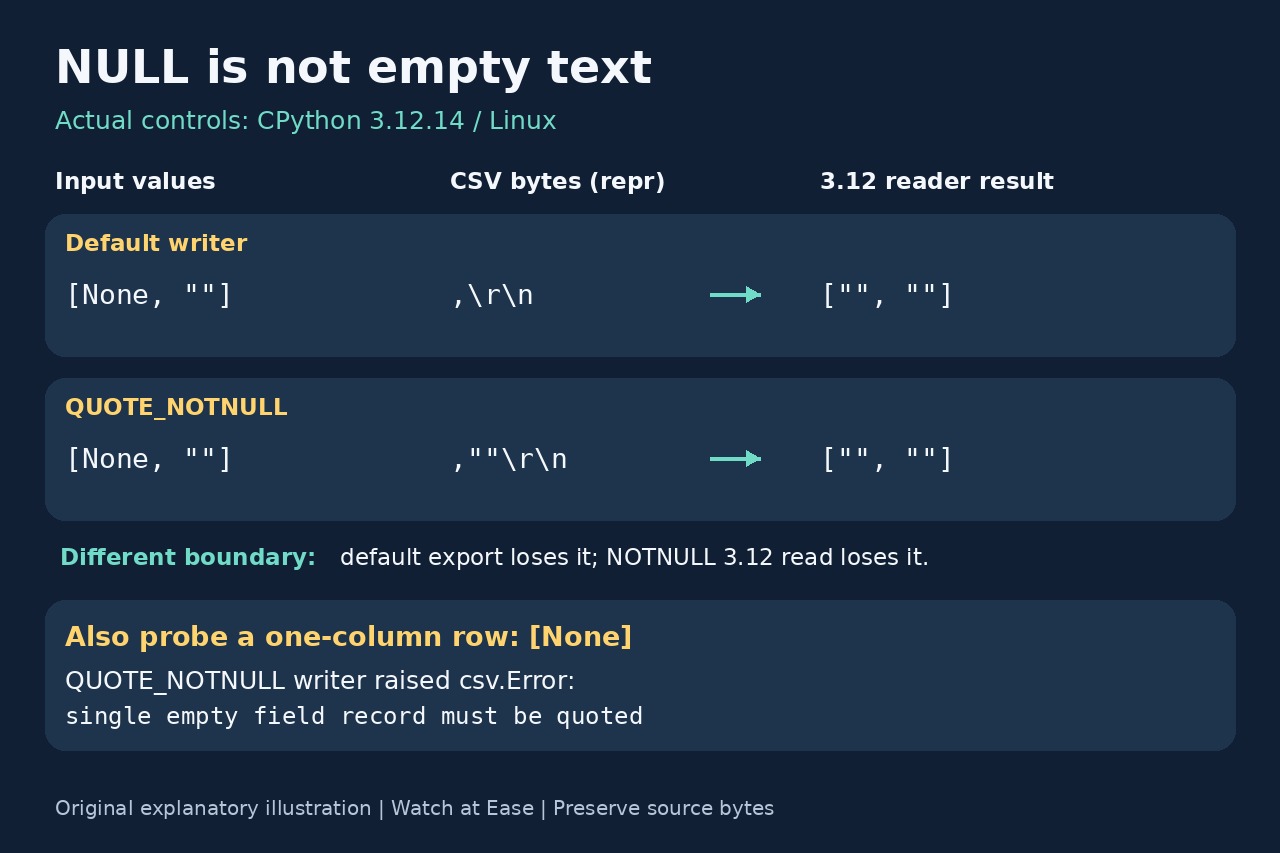
在CPython3.12.14中,使用csv.QUOTE_NOTNULL写入[None, ""],得到一个未加引号的空字段和一个带引号的空字段。但用相同选项读回时,两者都变成空字符串。常量存在,不代表部署中的读取器能保留这一区别。
先保留原始字节,确认生成方约定如何表示缺失值。如果旧导出已把缺失值和有意留空的文本写成相同形式,更换读取选项也无法还原来源。需要这一区别时,应保留文件并从原始数据重新导出。
1. 找出信息在哪一环丢失
不要改动源文件。用repr()查看一份不含敏感信息的小样本,让逗号、引号和记录结尾清晰可见。我们的默认csv.writer往返测试把[None, ""]变成["", ""],信息在导出时丢失。NOTNULL写入器保留了两种不同字段,但3.12读取器又把它们合并,这是解析器兼容性边界。
不要把所有解析后的空字符串改成None来“修复”。双字段样本会因此变成两个None,抹掉有意留空的值。没有转义规则的替代标记也会冲突:若用<NULL>表示None,原本就是<NULL>的文本便无法区分。
2. 同时测试写入、读取和单列记录
输出sys.version,再用生产环境相同的选项写入、读取包含None、空字符串和"001"的样本。Python3.12参考文档明确提示,QUOTE_NOTNULL和QUOTE_STRINGS不会影响读取器行为;相关读取变化记录于3.13。我们实际执行的只有3.12.14。
还要测试仅含None的一行。我们的QUOTE_NOTNULL写入器抛出csv.Error: single empty field record must be quoted。仅含一个空字符串的行读回为[""],空白记录则读回为[]。在依靠引号区分缺失值的约定下,为消除报错而给缺失值加引号,会把它写成空文本。
3. 转换之前先约定格式
在兼容的现代读取端,文档中的QUOTE_NOTNULL规则把未加引号的空字段读为None,其余字段保留为字符串。它不会恢复整数或任意Python对象。QUOTE_STRINGS还有自己的数值转换规则,也不是通用对象序列化器。采用任何规则之前,都应在两端实际环境测试支持的行结构。
PostgreSQL COPY CSV说明了接收约定的重要性:默认情况下,未加引号的空字段表示NULL,带引号的空字段表示空文本;FORCE_NULL和FORCE_NOT_NULL可以改变解释。这是PostgreSQL的文档规则,并非所有CSV通用的保证。我们没有执行数据库或Python3.13集成测试。
4. 两端都由你控制时的有限替代方案
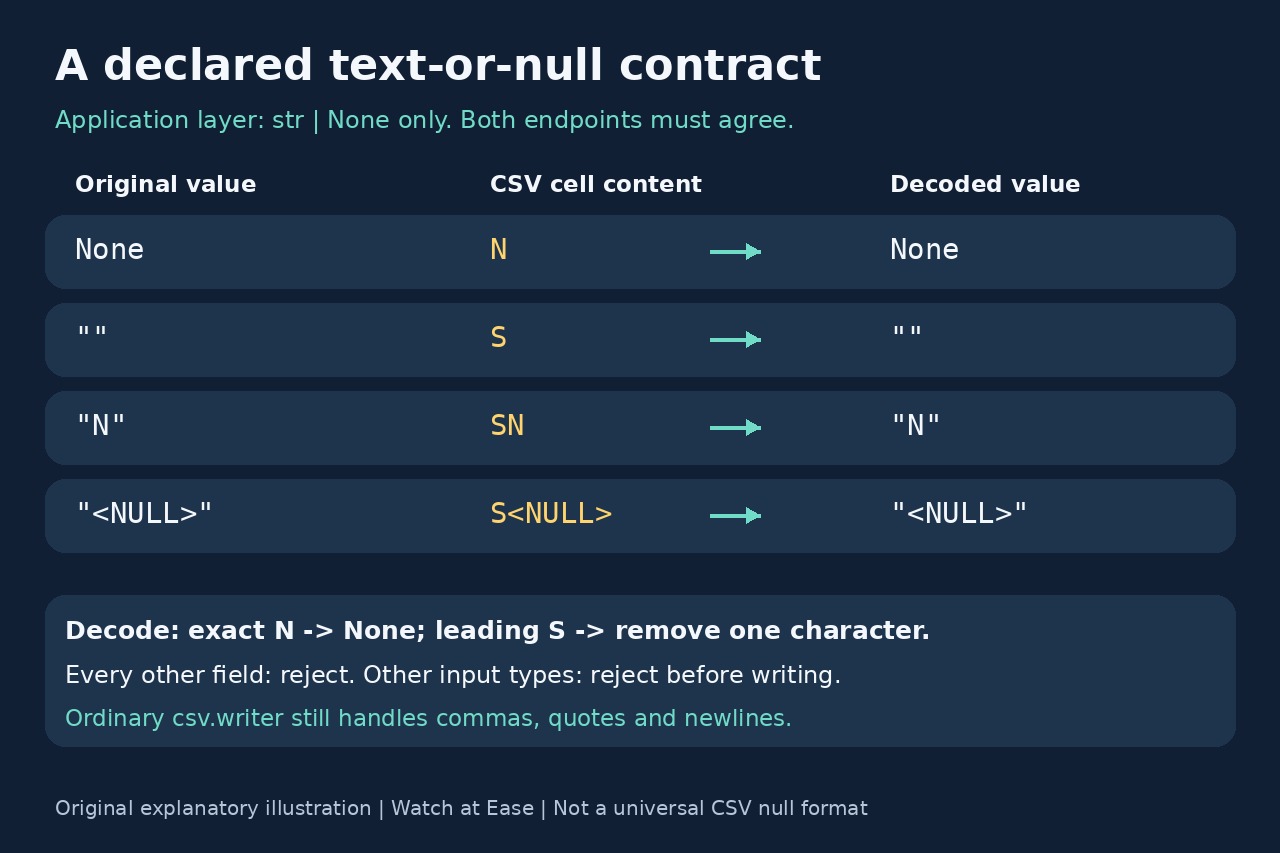
如果旧环境交换只允许str或None,我们测试的应用层约定把None编码为字面字段N,把每个字符串编码为S加上完整原文。因此空文本变为S,文本N变为SN,真实文本<NULL>变为S<NULL>。再交给普通csv.writer处理,逗号、引号和嵌入换行仍由CSV层负责。
解码时,只有完全等于N的字段变为None;以S开头的字段只去掉首个字符,其他字段全部作为错误标记拒绝。写入前拒绝非字符串且非None的输入。这是必须明确协商的新应用格式,不能直接套在已有普通CSV上,也不能假定COPY、pandas或电子表格认识这些标记。
5. 用值、类型和行结构判定完成
20项断言测试覆盖两处信息丢失、单列缺失值写入异常、空白记录与单个空字段、空值转换和替代标记冲突,以及13种值的标记往返。矩阵含None、空文本、"001"、"0"、看似缺失值或标记的文本、逗号、引号、嵌入换行和Unicode;读回后的值与类型均一致。
其余测试验证单个缺失值、单个空文本和两个缺失值的记录,拒绝整数、布尔值、错误标记及未编码的空字段。这只证明所述文本或缺失值约定在CPython3.12.14/Linux中的表现,不能认证其他运行环境或下游软件。每个边界都应保留代表性样本,原始区别已经丢失时重新导出,不要猜测。