科技 · 实用指南
Python 提示“field larger than field limit”?提高上限前先诊断 CSV 记录
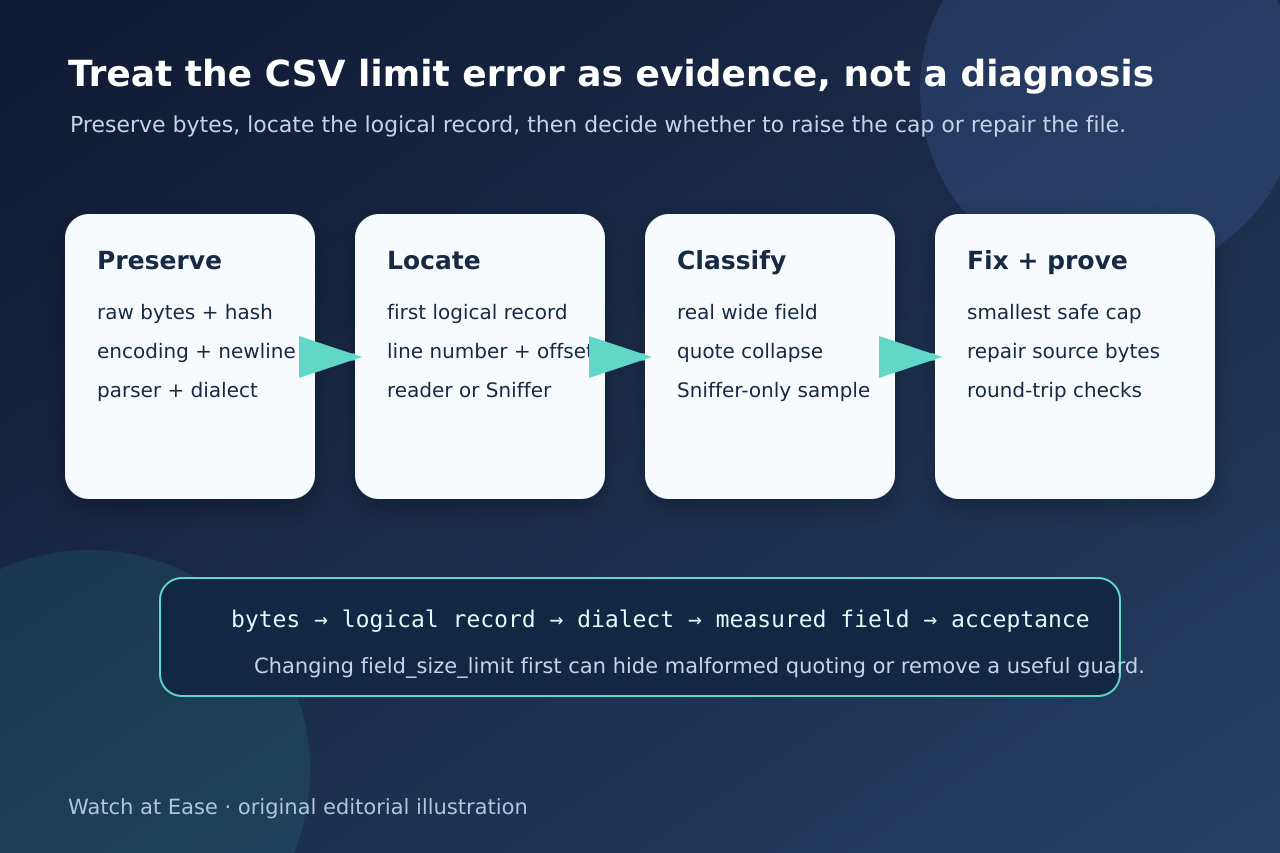
先保全原始字节,分离 Sniffer 与 reader,并证明记录是真正超宽、引号损坏还是仅检测失败,再调整 csv.field_size_limit。
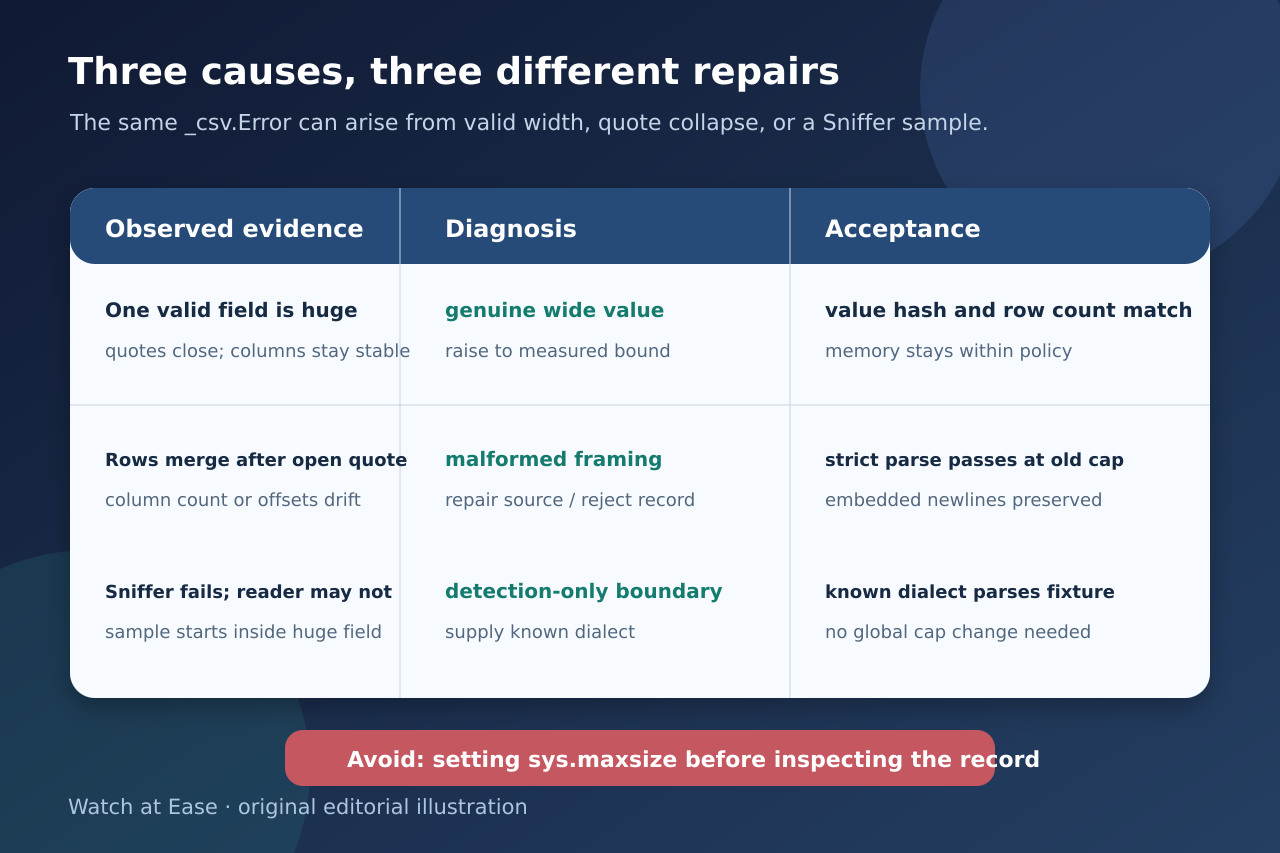
_csv.Error 并不是根因判定。同一句错误既可能来自合法的大字段,也可能是未闭合引号吞并后续记录,或 Sniffer 在正常读取前就被样本卡住。
保全字节与解析契约,定位首个失败逻辑记录,只做针对性修复,并同时验证数据语义与内存边界。
1. 保全失败字节与解析契约
在电子表格或换行规范化前复制原文件,记录哈希、字节数、编码、BOM、解析器和引擎;以 newline="" 打开。
记录 delimiter、quotechar、doublequote、escapechar、quoting、strict 与当前 field_size_limit;测试后恢复旧值。
2. 分开复现 reader 与 Sniffer
应用已知 dialect 时先绕过 Sniffer,用明确设置解析小型复现样本。Sniffer 可能仅因首字段过大而失败。
把自动检测和读取分别判定;只有同一字节在明确 dialect 下成功,才能称为 Sniffer-only。
3. 定位首个失败逻辑记录
从新文件句柄流式读取,记录每个成功记录后的 reader.line_num,并保存下一个候选附近的有界原始偏移窗口。
物理行不等于 CSV 记录;检查引号是否闭合,以及预期后续记录的列数是否突然漂移。
4. 区分真实宽度、引号吞并或检测边界
真正超宽字段应有平衡引号、稳定结构和符合生产契约的实测大小;仅把上限提高到有依据且受内存预算约束的值。
引号未闭合时修复或拒绝源记录;仅 Sniffer 失败时提供已知 dialect 或从完整记录开始取有界样本。
5. 处理平台整数边界并验收
C 实现把 Python 整数转换为平台 C long;溢出时逐步降低候选值,不能把 sys.maxsize 当通用安全值。
用原样本和坏引号样本验收,核对行列、代表值哈希、嵌入字符、内存并恢复旧上限;仅“能解析”还不够。