Tecnología · GUÍA PRÁCTICA
¿Python dice “field larger than field limit”? Diagnostica el registro CSV antes de subir el límite
Conserva los bytes, separa Sniffer de reader y demuestra si el registro es realmente ancho, está mal citado o solo falla la detección antes de cambiar field_size_limit.
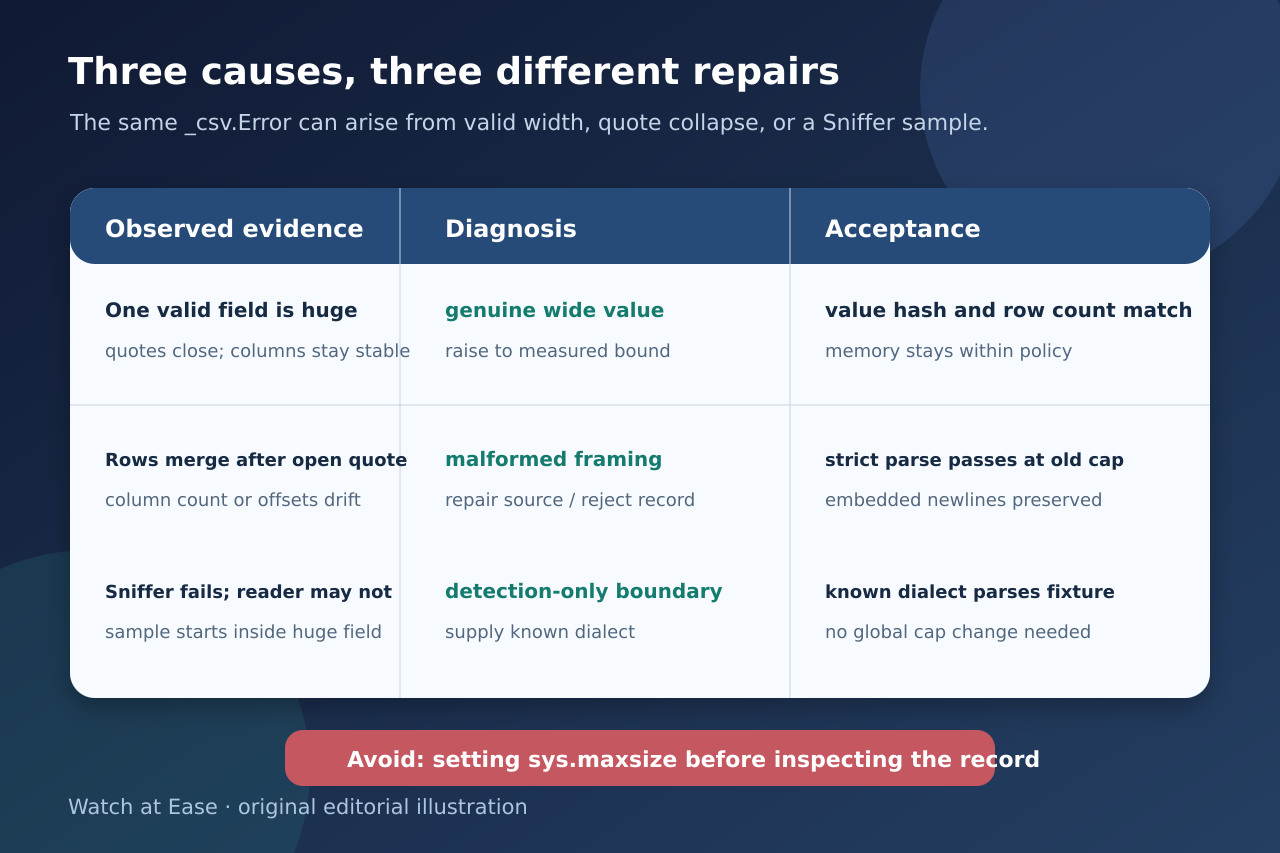
_csv.Error señala un límite, no una causa. Puede ser un valor ancho válido, una comilla sin cerrar que absorbe registros o un sample que hace fallar a Sniffer.
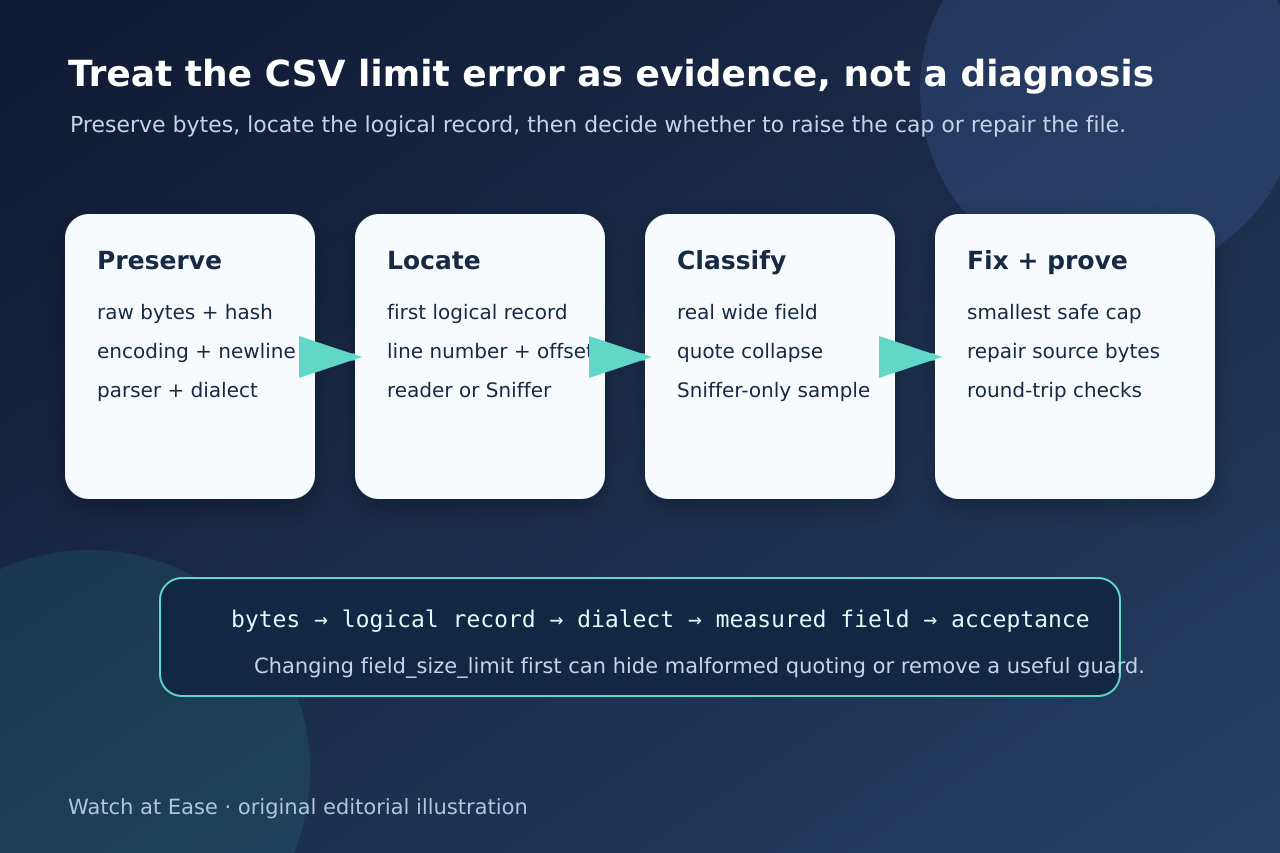
Conserva bytes y contrato del parser, localiza el primer registro lógico y valida semántica y memoria después de la corrección mínima.
1. Conserva bytes y contrato del parser
Registra hash, tamaño, encoding, BOM y engine antes de transformar el archivo; ábrelo con newline="".
Guarda dialect y límite actual, y restaura el valor tras la prueba.
2. Reproduce reader y Sniffer por separado
Si conoces el dialect, evita Sniffer y lee los mismos bytes con opciones explícitas.
Solo es Sniffer-only si la lectura explícita funciona.
3. Localiza el primer registro lógico
Lee desde un handle nuevo y guarda reader.line_num y una ventana acotada de offsets.
Una línea física no siempre es un registro; revisa cierre de comillas y deriva de columnas.
4. Clasifica anchura, colapso de comillas o detección
Un campo ancho válido conserva framing y estructura, y coincide con el contrato; eleva solo a un cap medido y acotado.
Si la comilla queda abierta, repara o rechaza el origen; si solo falla Sniffer, aporta el dialect.
5. Maneja límites de plataforma y valida
La implementación convierte a C long; reduce el candidato si desborda y no uses sys.maxsize como constante universal.
Comprueba filas, columnas, hashes, caracteres incrustados, memoria y restauración del límite.