Tecnología · GUÍA PRÁCTICA
¿Python no puede programar nuevos futures tras shutdown? Demuestra qué ciclo terminó primero
Distingue el cierre de una instancia Executor, la salida del intérprete y el pool predeterminado de asyncio antes de reintentar.
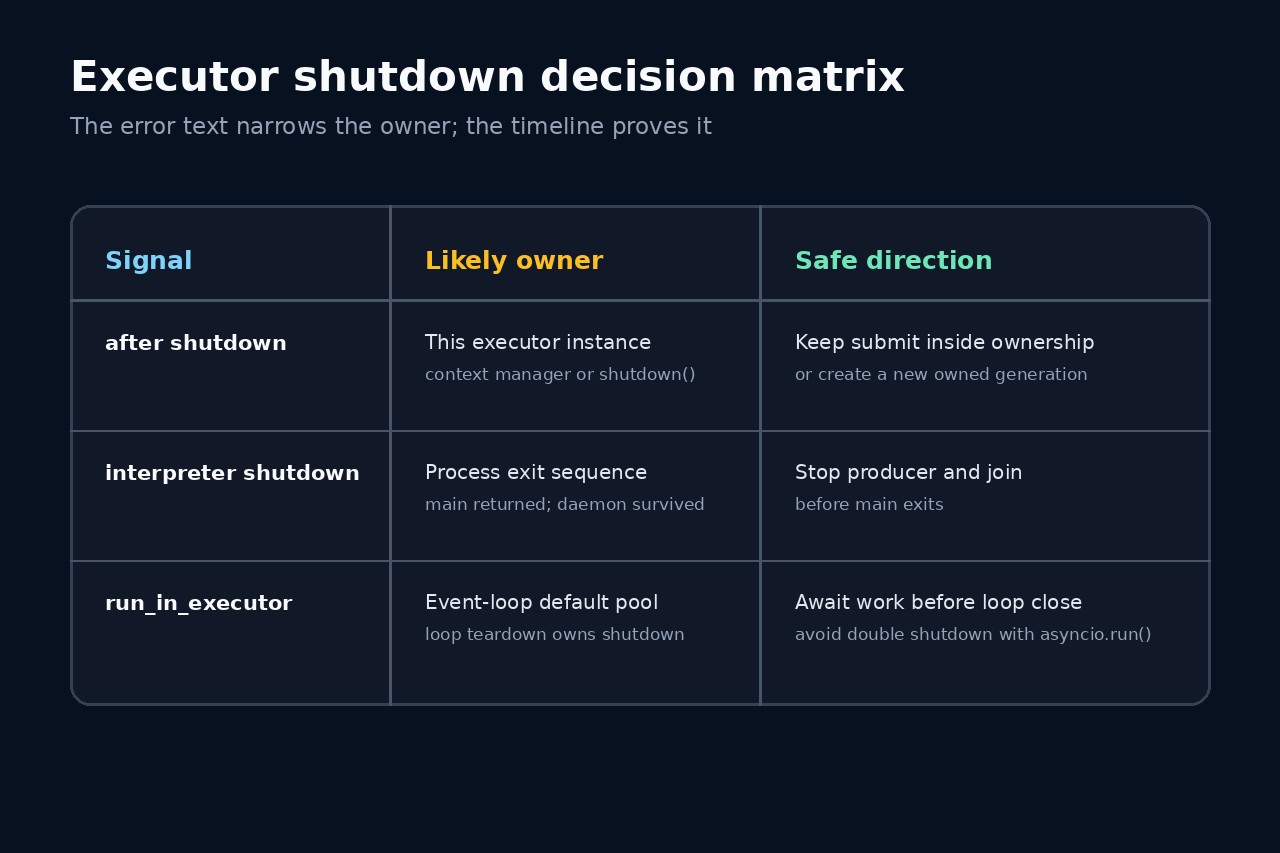
RuntimeError: cannot schedule new futures after shutdown no pide un pool más grande. Es evidencia de que un productor cruzó un límite de ciclo de vida: se cerró un Executor concreto, terminó el ejecutor predeterminado de asyncio o el intérprete ya estaba saliendo. El sufijo exacto y toda la pila de submit indican qué propietario investigar.
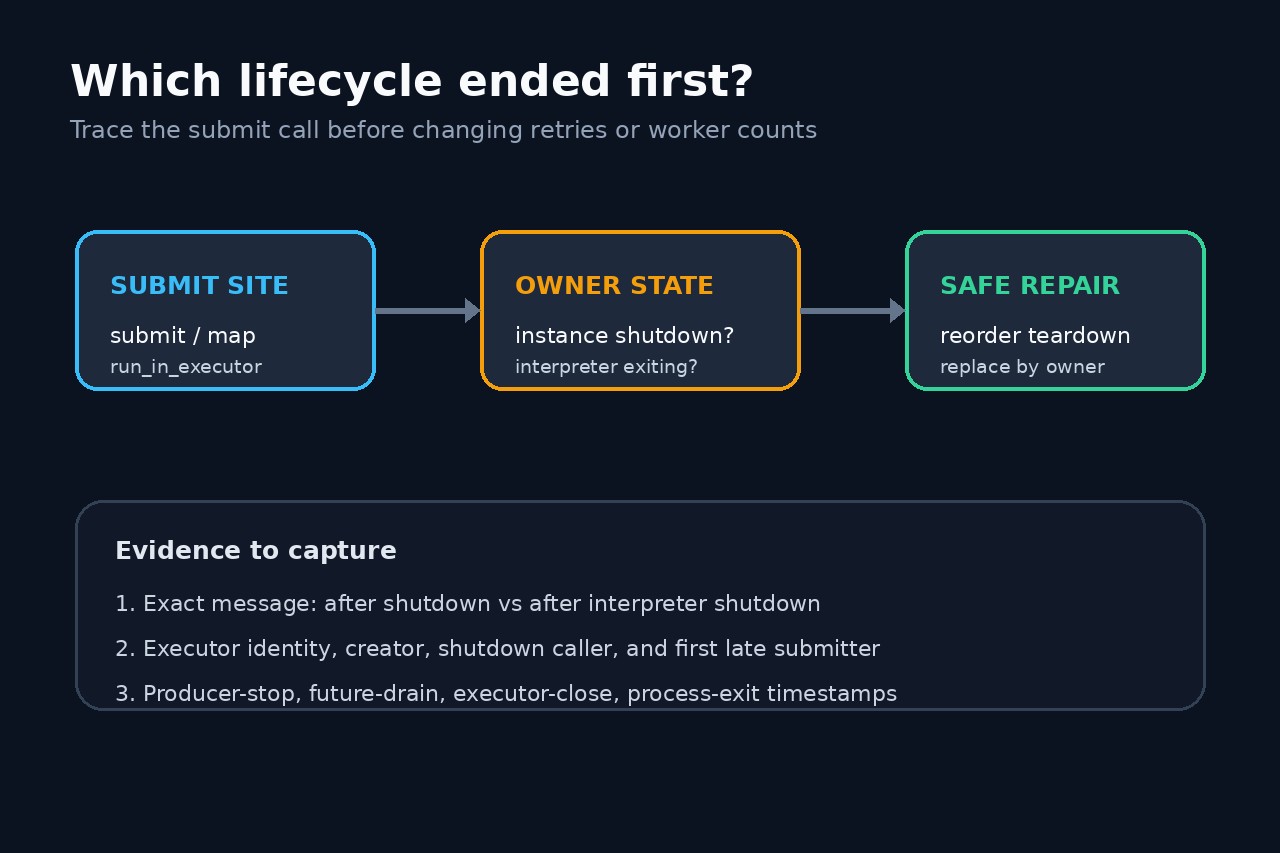
Conserva esa evidencia antes de añadir reintentos. Una reparación segura asigna un propietario a cada generación, detiene primero a los productores nuevos, completa o cancela deliberadamente el trabajo aceptado y llama a shutdown una sola vez. Si asyncio.run posee el bucle, deja que también cierre el ejecutor predeterminado.
1. Clasifica la señal exacta de cierre
Guarda el traceback completo y separa after shutdown de after interpreter shutdown. Anota si llega por submit, map, un programador, una biblioteca o run_in_executor; cada ruta apunta a otro propietario.
Registra una generación estable al crear, aceptar, iniciar y terminar el cierre, y al primer rechazo, junto con PID, hilo o tarea y tiempo monotónico. La reparación debe basarse en contratos públicos.
2. Corrige la reutilización tras cerrar una instancia
El gestor de contexto cierra el ejecutor al salir. Si un objeto persistente conserva esa instancia, la primera ejecución puede funcionar y la segunda fallar. Crea una instancia por ejecución independiente o mueve el with al propietario de toda la vida útil.
No permitas que cada llamador capture RuntimeError y cree otro pool. El propietario debe publicar una sola generación bajo bloqueo o máquina de estados, rechazar envíos al drenar y reemplazarla solo cuando la anterior esté contabilizada.
3. Corrige la carrera de salida y hilos daemon
interpreter shutdown significa que la vida del proceso ya termina. Suele ocurrir cuando main retorna mientras un controlador daemon, programador, callback o ayudante aún enviará trabajo, o cuando una excepción principal queda sin capturar.
Usa una señal de parada: detén productores, bloquea nuevos envíos, une el controlador, resuelve futures, cierra el ejecutor y entonces retorna de main. El trabajo obligatorio no debe depender solo de un daemon ni de atexit para revivir el pool.
4. Respeta la propiedad del ejecutor de asyncio
run_in_executor(None, ...) usa el ejecutor predeterminado del bucle. Después de shutdown_default_executor() falla. Con asyncio.run, el runner ya gestiona generadores, ejecutor y cierre del bucle; no lo cierres dos veces.
Con un bucle manual, detén servidores y callbacks que producen trabajo, espera sus tareas, ejecuta shutdown_default_executor() y por último cierra el bucle. Los callbacks de otros hilos deben rechazarse o drenarse antes.
5. Demuestra la reparación con reinicio y salida
Prueba dos ejecuciones normales seguidas, cierre con cola, reinicio con productor activo y fallo del hilo principal. Cada trabajo aceptado debe tener un único estado terminal, no debe haber submit después de draining y los hilos deben volver a la base.
Define si el trabajo pendiente termina o se cancela y compruébalo. La evidencia final es una cronología donde el productor se detiene antes del cierre, sin efectos duplicados, hilos huérfanos, excepciones ocultas ni envíos tardíos.