Tecnología · GUÍA PRÁCTICA
¿Python muestra “BrokenProcessPool”? Identifica el worker muerto antes de reintentar el lote
La excepción del padre solo prueba que un worker terminó mal. Conserva PID y task markers, separa spawn, crash nativo y OOM, y solo entonces reconstruye el pool.
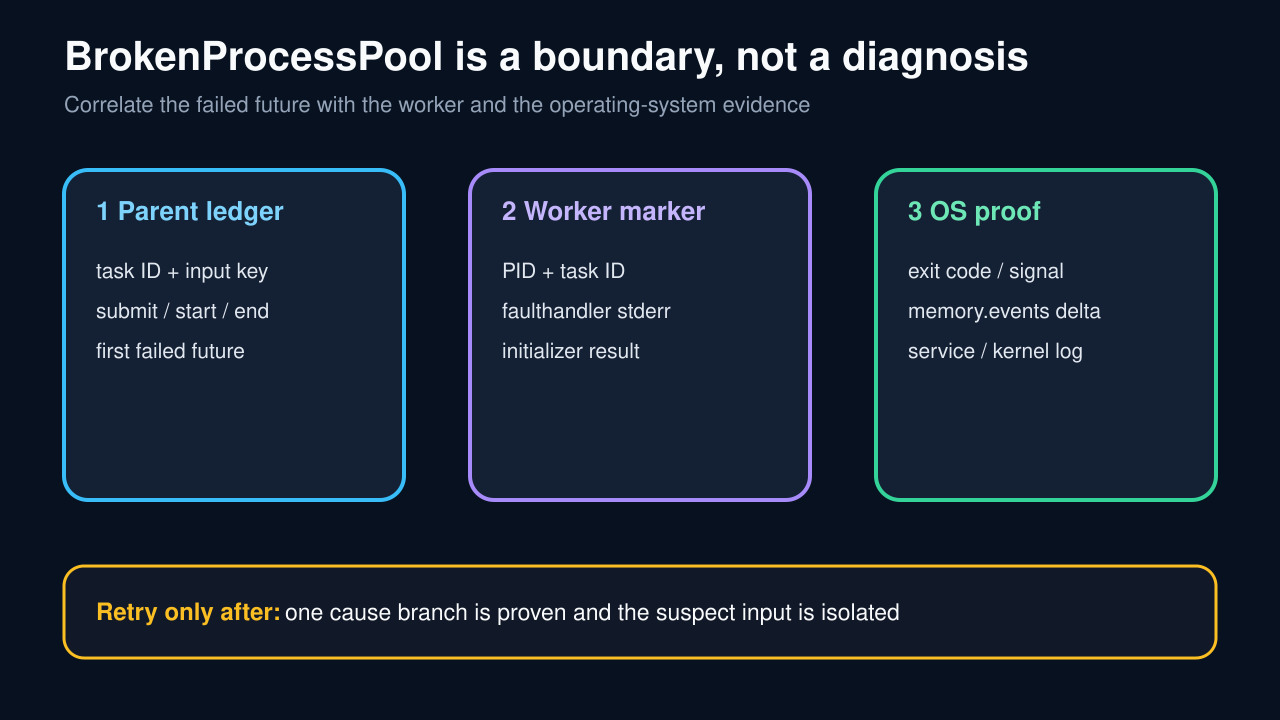
BrokenProcessPool significa que al menos un worker de ProcessPoolExecutor terminó de forma no limpia. No demuestra por sí solo una excepción normal, OOM, segfault o error de importación. Al desaparecer un worker, varios Future pendientes pueden recibir la misma excepción del pool.
Une el ledger de tareas del padre, los marcadores PID del worker y la evidencia del sistema operativo. No reenvíes todo el lote hasta aislar una rama causal y un input sospechoso.
Congela el ledger del padre antes de reintentar
Da a cada submission un task ID e input key y registra tiempo, Future y límite de side effects. Al romperse el pool, detén el bulk retry y conserva stderr y service logs.
Varios Future con BrokenProcessPool no prueban que cada input mató un worker.
Marca inicio y fase del worker
En task entry, flush PID, task ID, input key, versión, start method y fase. Mantén el initializer pequeño y determinista y registra entrada y éxito.
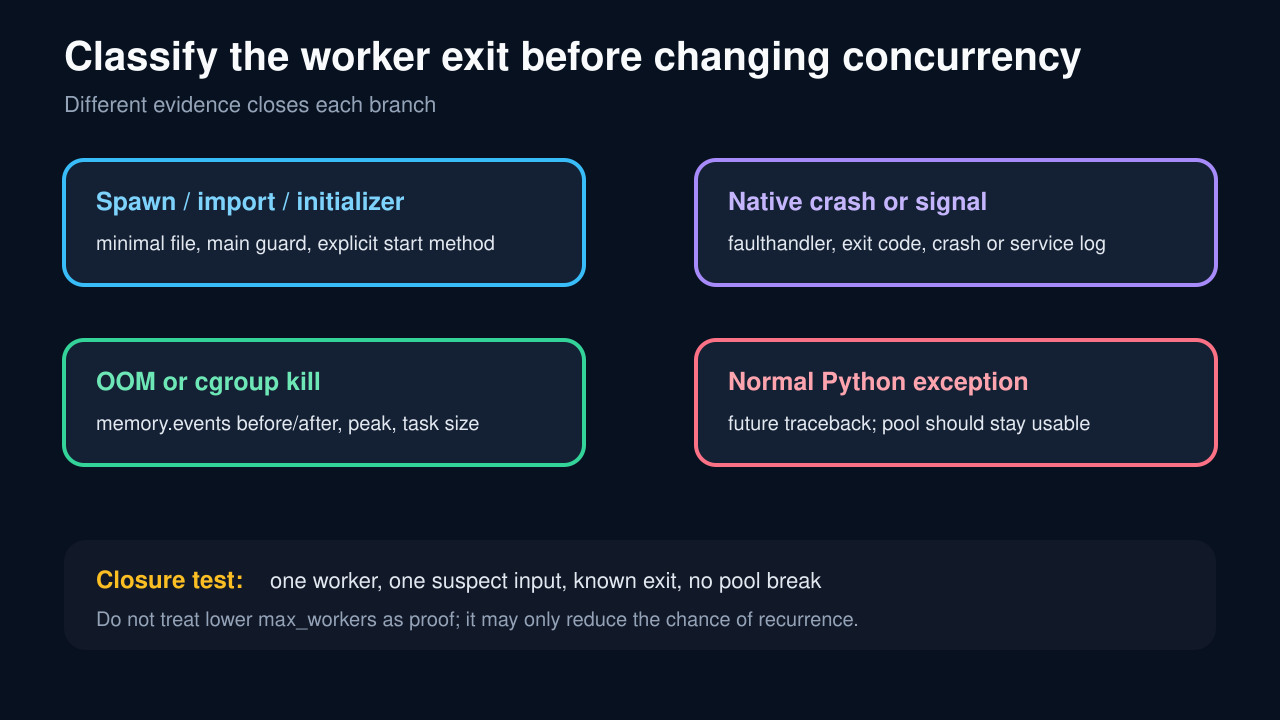
Si no aparece el marker, prueba un .py real con main importable, main guard cuando corresponda, callable de nivel de módulo y argumentos serializables. No cambies a fork a ciegas.
Conserva crash nativo y señal
Activa faulthandler antes del código nativo sospechoso y usa stderr duradero. Conserva crash report, estado del servicio, razón del contenedor y exit code disponible.
Un exit status negativo puede ser señal, pero otros workers pueden terminar después de declararse roto el pool. Correlaciona el primer PID muerto.
Demuestra o descarta OOM
En Linux cgroup v2 compara memory.events o memory.events.local antes y después. Un delta de oom_kill prueba una muerte por OOM; high, max y oom significan eventos distintos.
Registra cgroup path, memory.current, memory.peak cuando exista, workers, input size y copias por proceso. Bajar max_workers es experimento, no prueba.
Reduce a un worker y un input
Ejecuta el callable en serie y después en executor de un worker desde archivo real. Mantén task/PID markers y añade inputs por búsqueda binaria.
Si un worker funciona y varios fallan, compara memoria total, file descriptors, native thread pools y start method. Usa un executor nuevo para el experimento.
Cierra con prueba causal
El cierre exige una tarea registrada, un PID conocido, resultado normal o excepción ordinaria, oom_kill sin cambios y ningún crash fatal. Repite con poca concurrencia y cada input una vez.
Solo entonces cambia workers, memory limit, start method, dependencia, initializer o retry policy y documenta causa, versión, ventana e idempotencia.