科技 · 实用指南
Python 的 validate=True 仍接受两种 Base64 写法?这样强制规范填充位
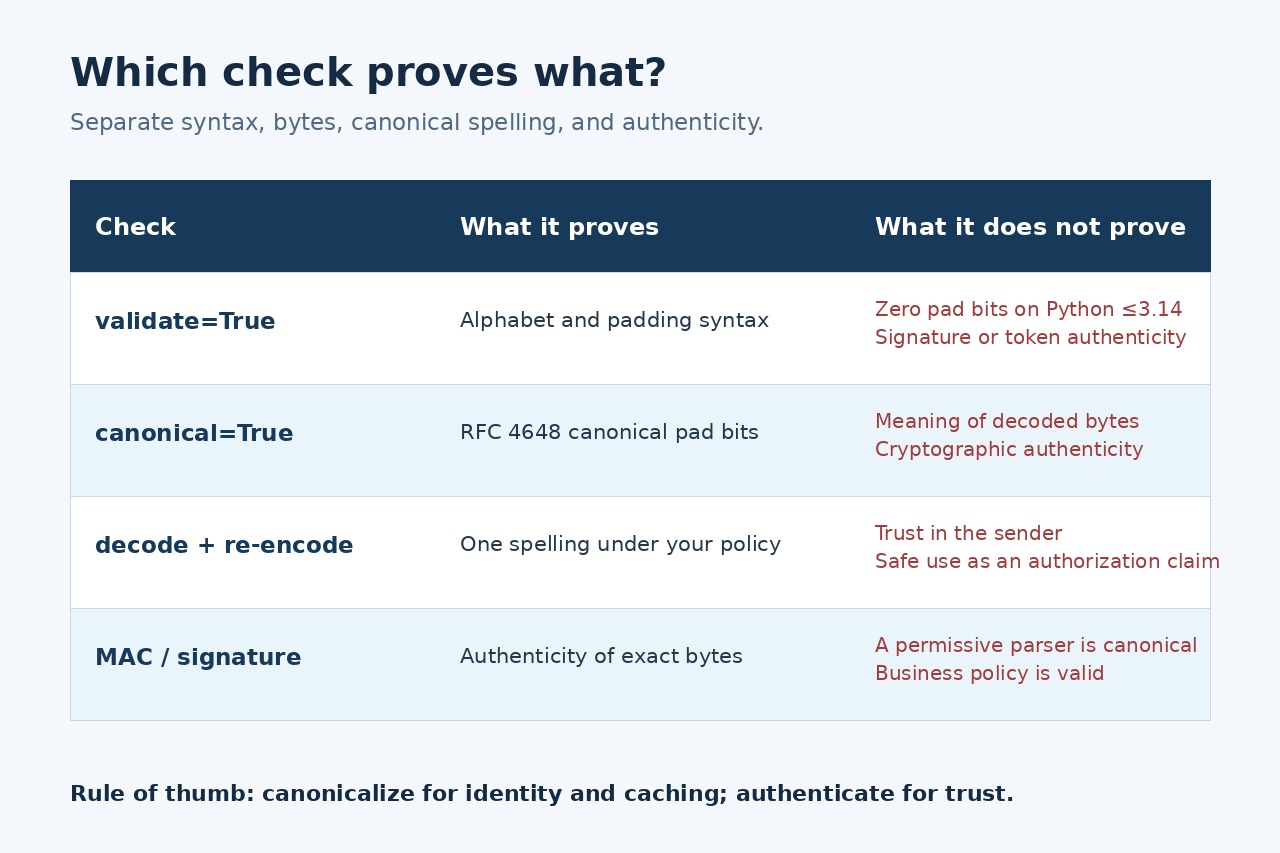
严格字母表检查不等于 RFC 4648 规范编码。Python 3.15+ 使用 canonical=True;旧版本先严格解码,再按同一策略重编码并精确比较。
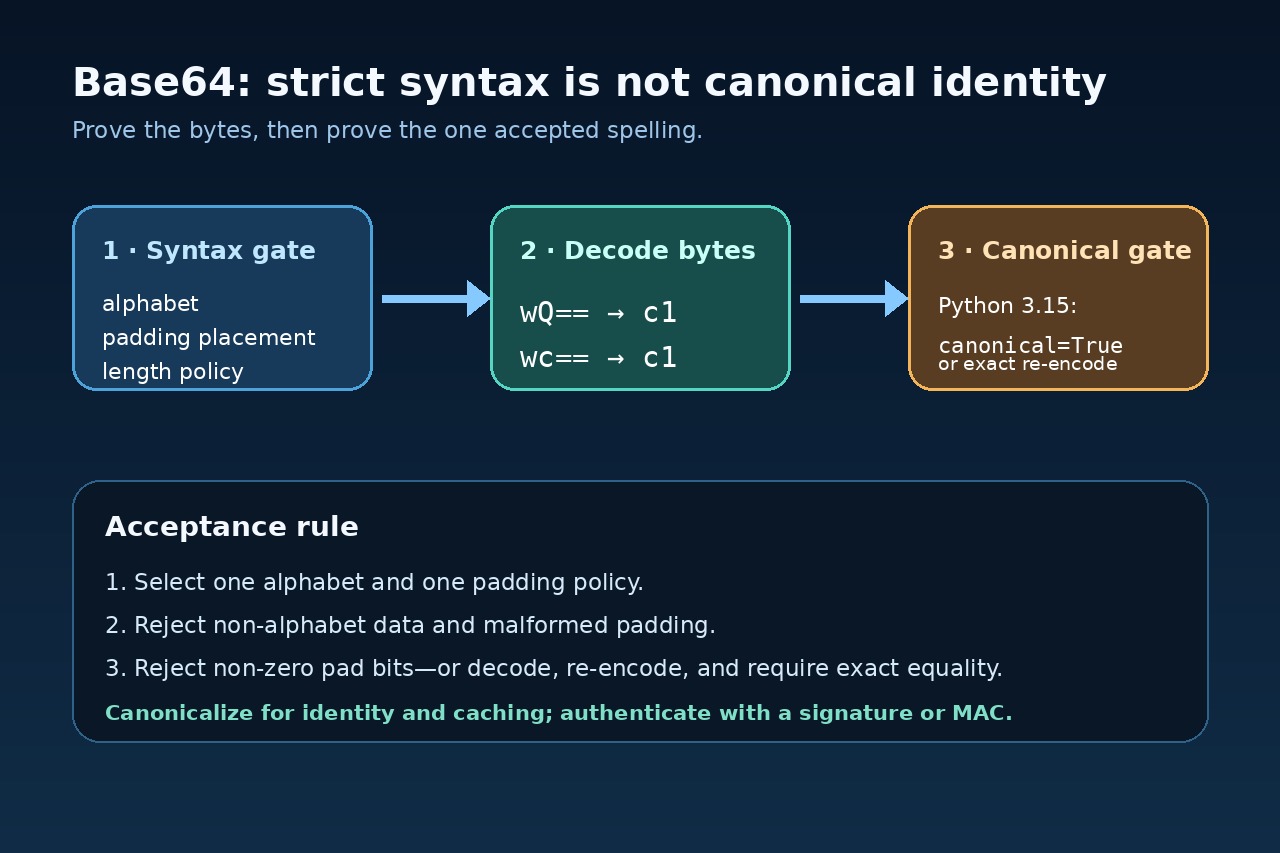
validate=True 会严格检查字母表与填充结构,但在 Python 3.14 及更早版本中,它仍可能接受未使用填充位非零的 Base64 别名。不同字符串可解码成同一字节。
Python 3.15 使用 canonical=True;旧版本应严格解码后按同一协议重编码并精确比较。先确定字母表和填充策略,也不要把规范写法误当成身份认证。
1. 这不是错觉
在 CPython 3.12.14 上,wQ==、wR==、wc== 无论 validate=False 还是 True 都得到 c1。validate=True 检查非法字符和填充结构,却不证明旧版本的未使用位为零。
合规编码器只有一个规范输出;多对一发生在宽容解码器忽略双等号前第二字符的低四位。
2. 填充位为何产生别名
一个输入字节只用到首个 Base64 字符的六位和第二字符的高两位;第二字符余下四位是填充位。RFC 4648 要求编码器把它们设为零。
标准允许解码器选择是否拒绝非零填充位,因此“语法可解码”“字节正确”“文本规范”是三件事。
3. Python 3.15 的做法
用 base64.b64decode(value, validate=True, canonical=True)。非规范别名会抛出 binascii.Error。
仍需保留 validate=True,并明确协议是否允许缺省填充、空白或 URL-safe 字母表。
4. 旧版本的兼容做法
对标准带填充 Base64,先 validate=True 解码,再用 base64.b64encode 重编码,并要求与原输入逐字节相等。先明确转为 ASCII,拒绝非 ASCII。
不要靠随意补多个等号“修复”输入。URL-safe 或无填充协议要先定义自己的唯一规范化策略,再用对应编码器比较。
5. 何时必须规范化
当 Base64 文本本身用于数据库键、缓存键、去重、白名单、签名输入或审计标识时,别名会让文本比较与字节比较得出不同结论。
能存字节就优先存字节;必须存文本时,在边界强制唯一写法。
6. 规范化不等于认证
攻击者也能构造完全规范但恶意的字节。信任仍要靠协议定义的签名或 MAC。
迁移测试应覆盖规范值、非零填充位别名、非法字符、错误填充,以及所有允许的协议变体。