技术 · 实用指南
Python的Base64严格解码仍接受不同写法?核查填充位与运行版本
严格解码与只有一种规范写法是两项检查。17项本地对照区分填充位、版本参数、大小限制和解码字节的含义。
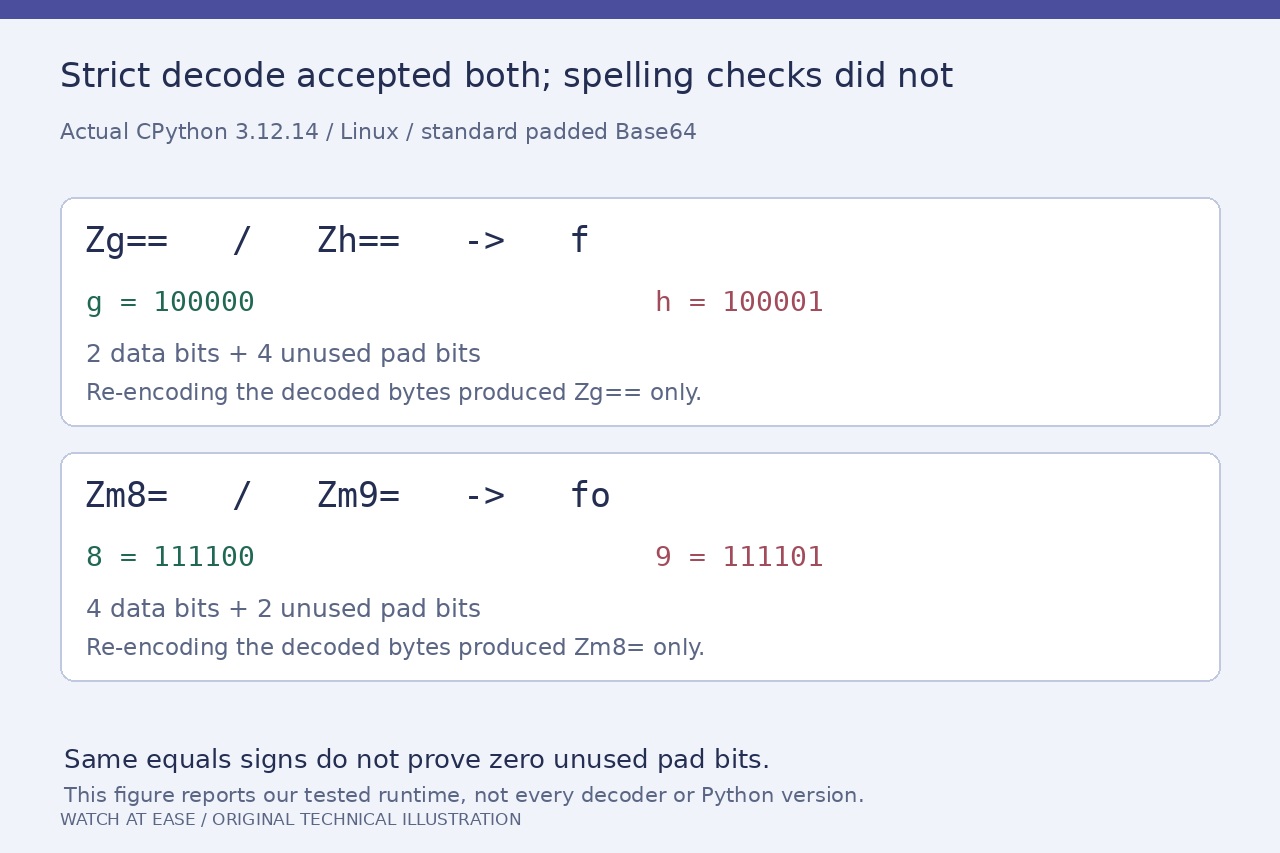
在本刊的CPython3.12.14环境中,base64.b64decode(value,validate=True)把Zg==和Zh==都解码为字节f,也把Zm8=和Zm9=都解码为fo。严格解码成功,并不能证明编码文本采用了规范写法。
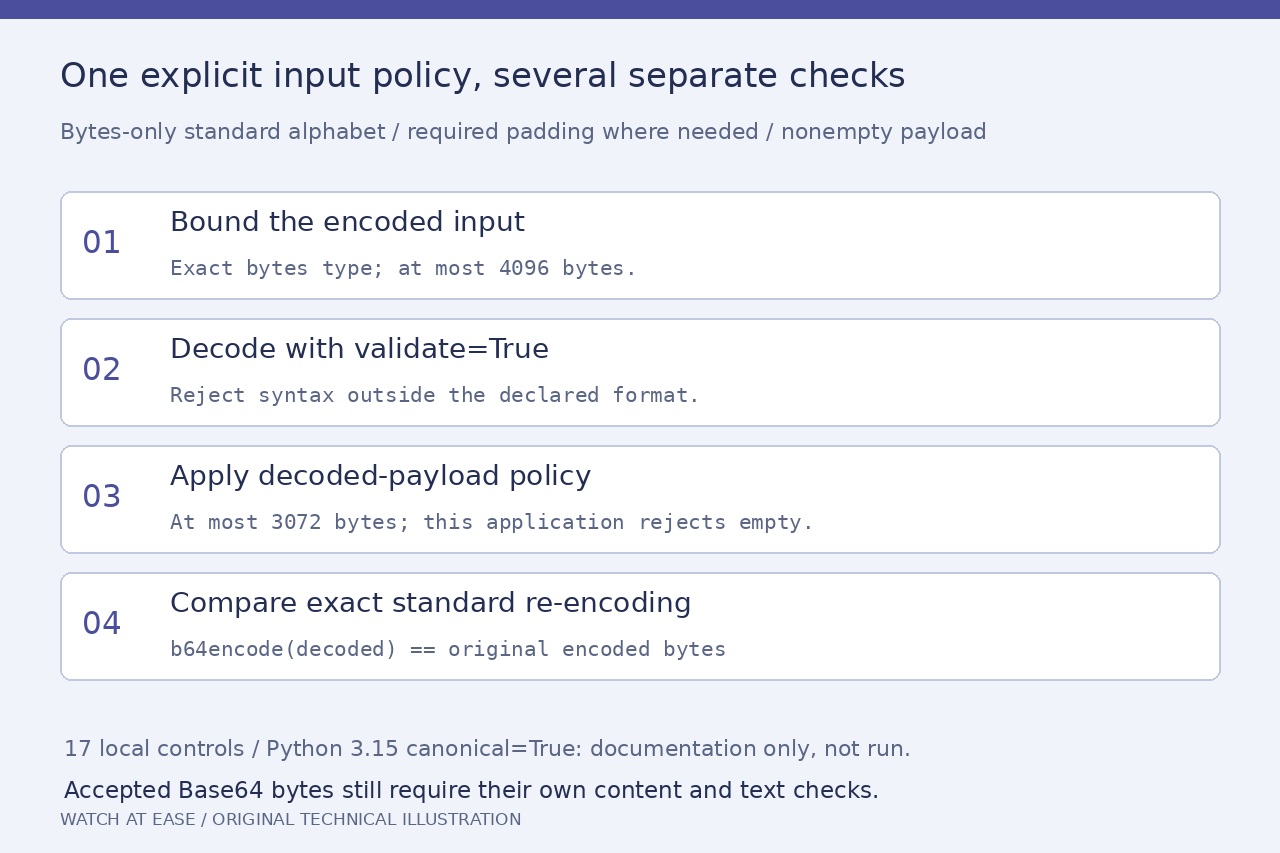
先明确真正需要的协议。本篇只测试一种窄范围策略:非空bytes输入、标准Base64字母表、具备必要填充、长度有界,并且重新编码必须与原文完全一致。它不验证JWT、签名或MIME消息。
1. 区分填充字符和未使用的填充位
实测的Zg==和Zh==有同样数量的等号,差别在最后一个字母表字符的未使用位。严格解码都接受,但将返回字节重新编码只得到Zg==,所以第二种写法未通过相等检查。Zm8=和Zm9=也出现同样对照结果。
RFC4648要求合规编码器把未使用的填充位置零;解码器可以拒绝非零填充位,引用该标准的具体协议也可规定更严格要求。因此,仅凭解码器接受,不能判定输入符合应用的单一写法规则。
2. 使用新参数前先检查运行版本
Python3.15文档新增canonical=True,用于拒绝非零填充位。字母表验证仍应明确设置validate=True,并保留协议要求的填充和大小规则。本刊读了该文档,但没有运行Python3.15。
在实际CPython3.12.14解释器中传入canonical=True,会因未知关键字触发TypeError。在该环境中,本篇的标准填充策略采用validate=True解码,再要求base64.b64encode(decoded)==encoded。这个比较检查表示形式,不验证MAC或签名。
3. 执行完整的有界策略
本刊辅助函数先要求输入类型恰为bytes,并拒绝超过4096字节的编码输入;严格解码后拒绝超过3072字节的输出,应用非空规则,再比较标准重新编码与原输入。全部通过才返回字节。
17项对照包括f、fo、foo的有效编码,两种填充位变体,冗余或过量填充、换行、缺少必需填充、URL安全字符、填充后的额外数据及空值。其他对照验证解码前长度上限、输出上限、未知关键字与独立的UTF-8失败。
4. 格式通过与载荷含义仍需分开
完整三个字节foo的规范编码是Zm9v,没有等号。要求必要填充,不意味着每个输入都应追加=;实测严格解码器拒绝Zm9v=。空Base64能成功解码,但本应用主动拒绝空载荷,这是不同的事实与策略。
规范输入/w==解码为字节0xff,并通过表示形式检查;将该字节按UTF-8解码则失败。因此,格式有效不证明文本、文件有效或来源真实。应保留失败原输入用于诊断;当协议要求精确形式时,不要悄悄删除字符或追加填充。