科技 · 实用指南
PostgreSQL 报“could not resize shared memory segment”?先证明究竟哪个文件系统耗尽
ENOSPC 不等于数据库数据盘已满。先保存准确分配错误,从 PostgreSQL 所在运行命名空间检查挂载,把峰值与失败工作负载对应,再只修改一个已证明的边界并复跑同一操作。
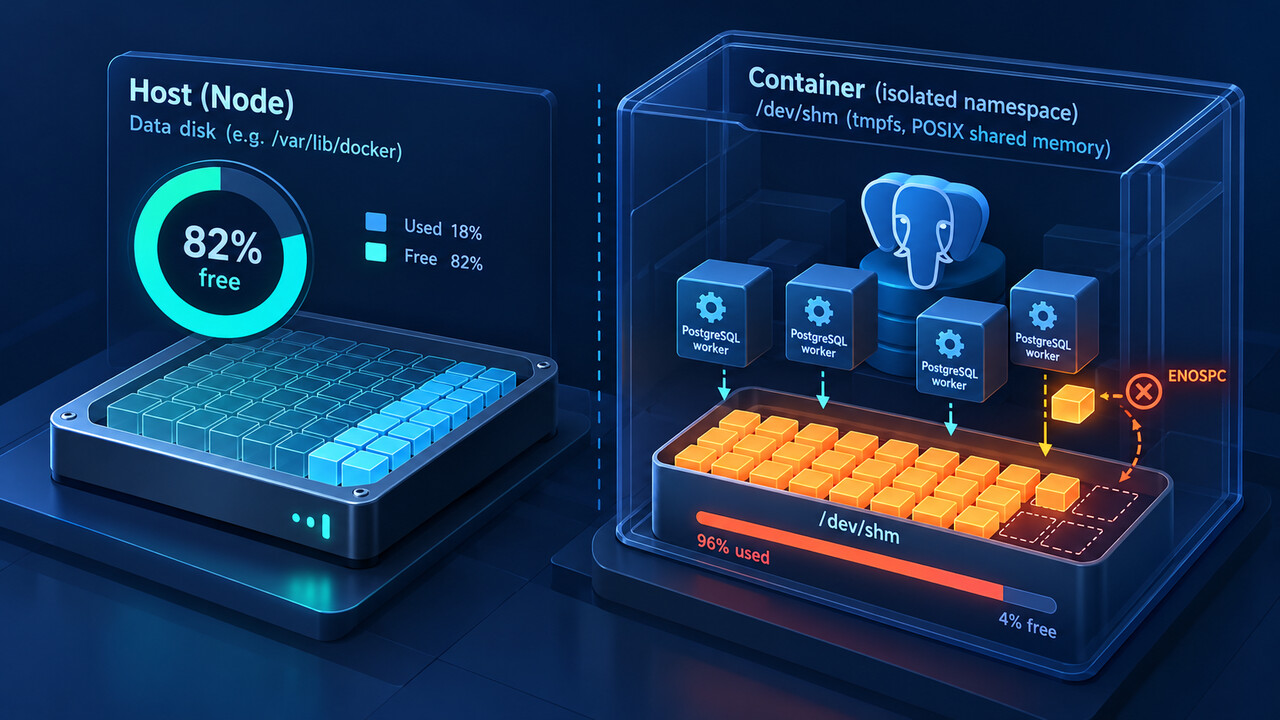
ENOSPC 不等于数据库数据盘已满。先保存准确分配错误,从 PostgreSQL 所在运行命名空间检查挂载,把峰值与失败工作负载对应,再只修改一个已证明的边界并复跑同一操作。
PostgreSQL 的并行操作可以使用动态共享内存。Linux 的 POSIX 共享内存通常由挂载在 /dev/shm 的 tmpfs 承载;容器即使宿主机和数据卷空间充足,也可能只有很小的私有挂载。
1. 冻结准确分配错误与运行身份
保存完整 PostgreSQL 错误、请求扩容字节数、SQL 或维护操作、backend PID、时间戳、数据库和应用请求 ID,同时记录承载该进程的容器 ID、pod UID 或 service task。
不要先看宿主机数据卷曲线。ENOSPC 只表示分配碰到边界;路径或 DSM 实现加上进程命名空间,才指向应该检查的资源。
2. 从 PostgreSQL 的命名空间检查挂载
在同一容器或 pod 内执行 df -h /dev/shm、df -i /dev/shm 和 findmnt -T /dev/shm,保存大小、已用、可用、inode、文件系统类型和挂载参数;与宿主机对比只用于证明命名空间是否不同。
在 PostgreSQL 中记录 SHOW dynamic_shared_memory_type 和相关并行设置。Linux 上的 posix DSM 指向 /dev/shm;若采用其他 DSM 类型,应沿其文档中的承载方式排查。
3. 把峰值对应到失败工作负载
必要时用不执行语句的 EXPLAIN 查看计划并行 worker,记录 max_parallel_workers_per_gather、同查询并发数以及重叠的 VACUUM 或维护任务,并在受控复现前、中、后测量 /dev/shm。
不要把 shared_buffers 或 work_mem 当作通用修复。正确比较是请求增量加并发 DSM 占用,与当前挂载实际剩余空间之间的关系。
4. 只修改一个已证明的边界
Docker 应为服务设置明确的共享内存大小并重建容器;只改配置但不替换运行容器,不会改变现有挂载。Kubernetes 可把 memory-backed emptyDir 挂到 /dev/shm,但必须纳入 pod 内存预算。
若无法安全增容,就通过限制受影响工作负载的并行 worker 或并发来降低已证明的峰值。服务器运行时不要擅自删除 /dev/shm 中看似属于 PostgreSQL 的文件。
5. 用同一负载设置退出门槛
重启或发布后重新进入实际运行环境,保存新的 findmnt 与 df 证据;用相同 SQL 或维护操作、相同相关并行度和代表性并发复跑,同时观察 /dev/shm 峰值。
只有原操作完成、挂载仍有可测余量、没有新的 DSM 分配错误且内存压力处于预算内才验收。若错误只是转移或 pod 发生内存压力,应回滚并重算容量。