実用ガイド · 実用ガイド
Obsidian Syncの競合コピー:重複ノートを削除する前にバイト台帳を作る
編集を止めたローカル保管庫のコピーを調べ、公式に記載された競合ファイル名だけを対応づけてMarkdownの生バイトを比較する。読み取り専用ツールは元ファイルの欠落や未対応の名前を示す。ハッシュが同じでも削除は承認しない。
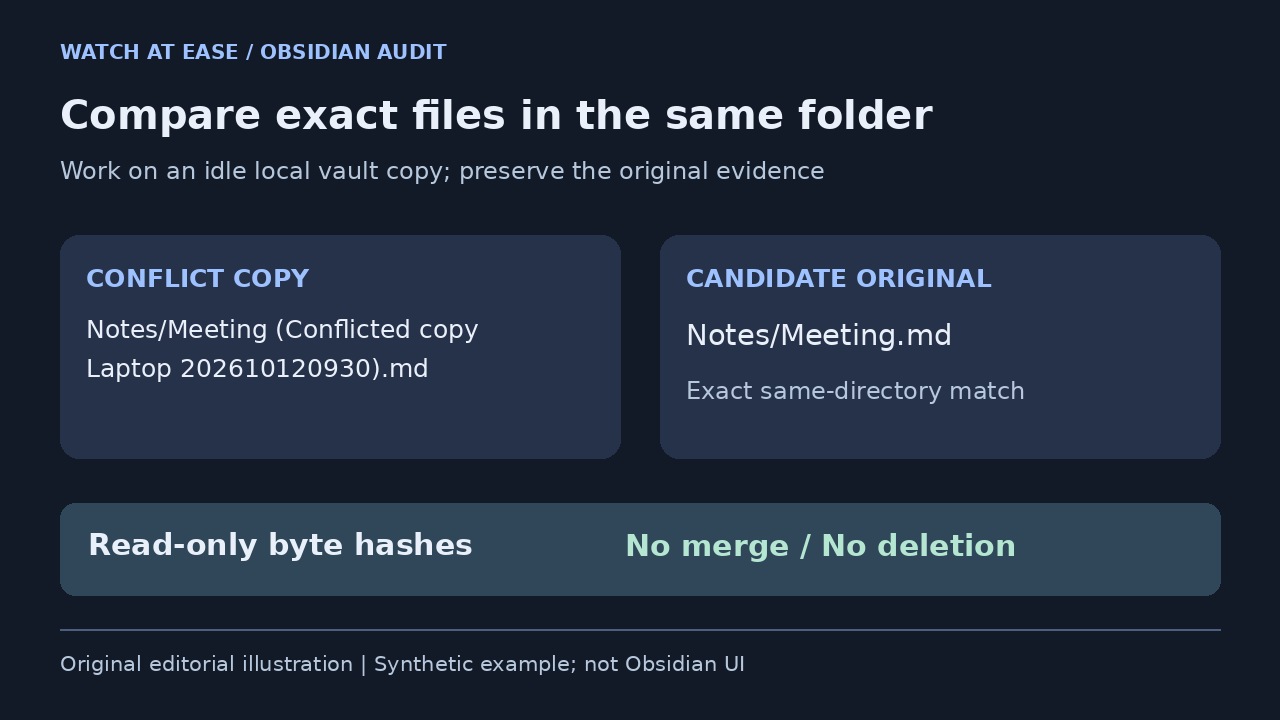
競合コピーは確認すべき第2の版であり、不要な重複として捨ててよいファイルではない。削除前にローカル保管庫のコピーを保存し、その生バイトを元ファイル候補と比較する。同名のノートや大半の文章が同じノートにも、それぞれ異なる編集が残っている場合がある。
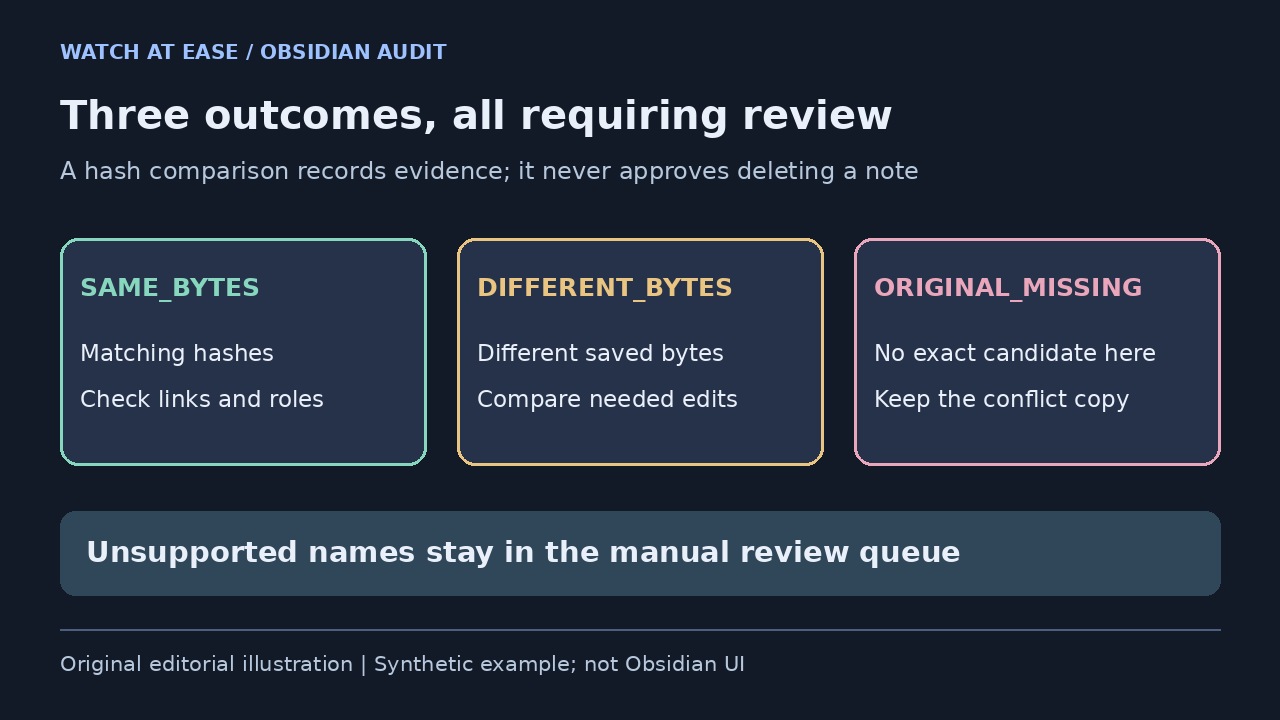
このガイドのオフラインMarkdown一覧は、バイトが同じ、バイトが異なる、元ファイル候補がない、という3つの結果を分ける。未対応の競合名と、その他の完全に同じバイトのファイル群も記録する。Syncへの接続、リンクの書き換え、ノートの結合、正しい版の選択は行わない。
1. 整理する前に証拠を固定する
通常のバックアップ方法で各端末のローカルコピーを保存する間、保管庫を閉じ、関係する端末での編集を止める。コピーは同期中のディレクトリの外に置く。端末間にすでに差があるなら、調査中に一方を他方で上書きせず、それぞれを保存する。
現在の公式ヘルプでは、Obsidian 1.9.7以降、競合時に自動結合するか競合ファイルを作るかを選べる。設定は端末ごとに必要だ。2024年のフォーラムでSyncは競合ファイルを作らないとした回答は、この機能より前のもので、現在の規則ではない。数字付きの一般的なファイル名も、特定の同期原因を証明しない。
2. ツールが認識する対応関係を知る
公式の形式に合う競合名については、競合を示す接尾部分を除き、.mdを残して、同じディレクトリの元ファイル候補を求める。端末名には空白を含められる。12桁の時刻部分は有効な暦の日付と時刻でなければならないが、どの版が新しい、または優れているかの証拠にはならない。
桁数が異なる名前、不正な日付、入れ子の競合部分はunsupportedNamesに入る。保管庫の別の場所にある代替パスを推測しない。同じバイトの一般的なファイルは別に一覧化し、Syncが作ったとは判断しない。添付、リンク、遠隔の版、1つのノート内の重複段落は対象外だ。
3. 完全な読み取り専用スクリプトを保存して実行する
以下の完全なコードを、保管庫外のobsidian_conflict_audit.pyとして保存する。この版は6292バイト、SHA-256は79d0b961fe288a39e93f10af21200db69b6d163eb261137b80596c113571c2a2。信頼できるPythonを使う。模擬テストの環境はLinux・Python 3.12.14だった。インデントを保ち、UTF-8のプレーンテキストでコピーする。
```python #!/usr/bin/env python3 """Inventory an idle local vault copy; stdout only, never merge or delete.""" import argparse import hashlib import json import os import re import stat import sys import unicodedata from datetime import datetime from pathlib import Path MAX_FILES = 5000 MAX_ENTRIES = 20000 MAX_FILE = 2 * 1024 * 1024 MAX_TOTAL = 64 * 1024 * 1024 SKIP = {'.obsidian', '.git', '.trash'} MARKER = '(Conflicted copy' PATTERN = re.compile(r'^(.+) \(Conflicted copy (.+) ([0-9]{12})\)\.md$') def signature(s): return (s.st_dev, s.st_ino, s.st_size, s.st_mtime_ns) def read_record(path, root, remaining): before = path.lstat() if not stat.S_ISREG(before.st_mode): raise ValueError('Markdown input is not a regular file: ' + str(path)) if before.st_size > MAX_FILE or before.st_size > remaining: raise ValueError('file or total byte limit exceeded') flags = os.O_RDONLY | getattr(os, 'O_NOFOLLOW', 0) descriptor = os.open(path, flags) with os.fdopen(descriptor, 'rb') as stream: opened = os.fstat(stream.fileno()) if signature(before) != signature(opened): raise ValueError('input changed before reading') data = stream.read(min(MAX_FILE, remaining) + 1) after = os.fstat(stream.fileno()) current = path.lstat() if len(data) > MAX_FILE or len(data) > remaining: raise ValueError('file or total byte limit exceeded') if len(data) != before.st_size or not ( signature(before) == signature(after) == signature(current) ): raise ValueError('input changed while reading') return {'path': path.relative_to(root).as_posix(), 'bytes': len(data), 'sha256': hashlib.sha256(data).hexdigest()} def audit(root): root = Path(os.path.abspath(root)) if root.is_symlink() or not root.is_dir(): raise ValueError('vault root must be an existing directory, not a symlink') paths = [] entries_seen = 0 def walk_error(error): raise error for folder, dirs, files in os.walk(root, followlinks=False, onerror=walk_error): dirs[:] = sorted(d for d in dirs if d not in SKIP) entries_seen += len(dirs) + len(files) if entries_seen > MAX_ENTRIES: raise ValueError('scanned directory-entry limit exceeded') for name in dirs + files: child = Path(folder) / name if child.is_symlink(): raise ValueError('symlink in scanned tree: ' + str(child)) for name in sorted(files): if name.lower().endswith('.md'): paths.append(Path(folder) / name) if len(paths) > MAX_FILES: raise ValueError('Markdown file count limit exceeded') paths.sort(key=lambda p: p.relative_to(root).as_posix()) folded = {} for path in paths: relative = path.relative_to(root).as_posix() key = unicodedata.normalize('NFC', relative).casefold() if key in folded: raise ValueError('case/Unicode path collision: ' + relative) folded[key] = relative records = [] total = 0 for path in paths: item = read_record(path, root, MAX_TOTAL - total) records.append(item) total += item['bytes'] indexed = {item['path']: item for item in records} groups = [] unsupported = [] for item in records: path = Path(item['path']) if MARKER.casefold() not in path.name.casefold(): continue match = PATTERN.fullmatch(path.name) if not match: unsupported.append({'path': item['path'], 'reason': 'unsupported name'}) continue original_name, device, stamp = match.groups() try: datetime.strptime(stamp, '%Y%m%d%H%M') except ValueError: unsupported.append({'path': item['path'], 'reason': 'invalid timestamp'}) continue if MARKER.casefold() in original_name.casefold(): unsupported.append({'path': item['path'], 'reason': 'nested conflict name'}) continue original_path = (path.parent / (original_name + '.md')).as_posix() original = indexed.get(original_path) relation = ('ORIGINAL_MISSING' if original is None else 'SAME_BYTES' if original['sha256'] == item['sha256'] else 'DIFFERENT_BYTES') groups.append({'copy': item, 'candidateOriginalPath': original_path, 'candidateOriginal': original, 'deviceLabel': device, 'filenameTimestamp': stamp, 'relation': relation, 'deleteApproved': False}) hashes = {} for item in records: hashes.setdefault(item['sha256'], []).append(item['path']) identical = [{'sha256': digest, 'paths': names} for digest, names in sorted(hashes.items()) if len(names) > 1] return {'status': 'INVENTORY_ONLY', 'writesPerformed': False, 'deleteApproved': False, 'mergeApproved': False, 'scope': 'Markdown files in an idle local vault copy', 'skippedDirectoryNames': sorted(SKIP), 'fileCount': len(records), 'bytesHashed': total, 'files': records, 'conflictCandidates': groups, 'unsupportedNames': unsupported, 'identicalByteGroups': identical, 'limits': {'maxFiles': MAX_FILES, 'maxEntries': MAX_ENTRIES, 'maxFileBytes': MAX_FILE, 'maxTotalBytes': MAX_TOTAL}, 'notVerified': ['remote Sync state', 'note meaning or completeness', 'attachments and links', 'concurrent changes', 'parent-path races or hostile filesystems']} def main(): parser = argparse.ArgumentParser(description=__doc__) parser.add_argument('vault', type=Path, help='idle local vault copy') args = parser.parse_args() try: result = audit(args.vault) except (OSError, ValueError) as error: print(json.dumps({'status': 'INCONCLUSIVE', 'writesPerformed': False, 'deleteApproved': False, 'reason': str(error)})) return 2 print(json.dumps(result, ensure_ascii=False, indent=2, sort_keys=True)) return 0 if __name__ == '__main__': raise SystemExit(main()) ```
次のコマンドに、編集を止めた保管庫コピーの絶対パスを指定する。報告はそのコピーの外に、新しいファイル名で保存する。シェルのリダイレクトが報告を作る一方、Pythonプログラム自体は読み取りと標準出力へのJSON表示だけを行う。エラーと終了コードを残す。
```sh python3 obsidian_conflict_audit.py '/path/to/idle-vault-copy' > '/path/outside-vault/audit-01.json' printf '%s\n' "$?" ```
終了コード0は、差異や元ファイル不在があっても一覧の作成が終わったことを表す。2は入力を拒否しINCONCLUSIVEとなったことを表す。どちらも削除許可ではない。報告内のパスや端末名には個人情報が含まれ得るので、共有前に伏せる。
4. 3つの結果を確認作業として読む
SAME_BYTESは、この実行で元ファイル候補と競合コピーのSHA-256が同じだったことを示す。リンク、遠隔の履歴、意味上の役割を交換できる証明ではない。手作業で整理する前に、バックリンクと最終的に残すファイル名を確認する。
DIFFERENT_BYTESは保存されたバイトが異なるという結果だ。テキスト差分で両方を比較し、残すべき編集を記録する。改行形式の違いでもハッシュは変わる。短いファイルや遅い時刻だけでは、内容の正しさを決められない。
ORIGINAL_MISSINGは、走査したMarkdownの中に、同じディレクトリの正確な候補がなかったという結果だ。競合コピーは保存する。元ファイルの移動・改名、大文字の拡張子、別の命名規則でも起こり得るため、内容が失われたと判断する前に履歴とディレクトリの状況を調べる。
各候補について、パス、サイズ、ハッシュ、関係、人の判断、保存済みコピーの場所を残す。各記録にはdeleteApproved:falseが付く。台帳は確認のための証拠を示し、削除や結合のコマンドは意図的に含めない。
5. 拒否や対象範囲の不足があれば立ち止まる
シンボリックリンクのルート、走査対象の木にあるシンボリックリンク、通常ファイルではないMarkdown入力、NFC正規化と大文字小文字の折り畳みで衝突するパスは拒否する。.obsidian、.git、.trashというディレクトリは除外し、Markdownだけをハッシュする。除外は対象範囲の制限であり、保管庫全体の健全性の証明ではない。
指定したファイル数、項目数、バイト数の上限を適用し、読み取りの前後でファイルの識別情報、サイズ、更新時刻を比較する。変化を検出した場合は拒否する。ただし原子的なファイルシステムのスナップショットでも、悪意ある親パス変更や不正なファイルシステムに対するサンドボックスでもない。変化し続ける実際の保管庫には使わない。
上限、権限エラー、未対応名のために必要な範囲を調べられない場合は、拒否結果を残す。別に保存した小さいコピーか、検討済みの専用ツールを使う。検査を外したり、部分一覧を全体と扱ったりしない。一般的な重複フォルダーには、ディレクトリとアプリ側の確認も必要だ。
6. 公式の確認手順で内容を復旧する
Syncログの競合フィルターと、ファイルごとの版の履歴でノートを調べる。復元は現在のノートを置き換えるため、先に内容をプレビューする。削除・改名したファイルにはSync設定内の別の履歴経路がある。保持期間はプランとファイル種類で異なるので、無期限に戻せると考えず現在の方針を確認する。
必要な文章を新しい確認用コピーへ結合し、重要なリンクと添付がObsidianで開けることを確かめる。選んだ結果をバックアップしてから原本を整理する。復元、改名、削除は別途人が行う操作であり、このスクリプトは行わない。
7. テストが示す範囲を理解する
20件の模擬テストは、同じ・異なるバイト、別フォルダーを推測しない元ファイル不在、未対応の秒付き名、不正日付、入れ子名、一般的な同一ファイル群、除外を検証した。ルート・ファイル・ディレクトリのリンク拒否、大小文字とUnicodeの衝突、各ファイル・件数・項目数・合計の上限、lstatからopenの間の変化、CLI終了コード0/2、元のバイトが変わらないことも確認した。
結果が検証するのは一覧作成ツールの実装であり、Obsidianの同期エンジンではない。Windows、macOS、遠隔状態、モバイル端末、画面表示、実際の競合復旧は試していない。自分の内容確認と保存コピーの確認を終えてから調査を閉じ、未検証のファイルや端末を記録する。
よくある質問
SAME_BYTESのコピーをすべて削除してよい? いいえ。ハッシュは走査時のバイト一致を示すだけで、ファイル名の役割、バックリンク、遠隔履歴を示さない。
ノート内の重複段落を見つけられる? いいえ。Markdownファイル全体の一覧であり、内部の重複には内容差分や版の履歴の確認が必要だ。
14桁の競合名が未対応なのはなぜ? この版は現在の公式12桁形式だけを認識する。他の競合印付き名は推測せず、人の確認に残す。
ORIGINAL_MISSINGは元ファイルの削除を証明する? いいえ。移動、改名、拡張子の大小文字、除外ディレクトリでも正確な一致が得られなくなる。
終了コード0ならSyncは直った? いいえ。ローカル一覧が完成しただけであり、結合、復元、削除を報告が承認することはない。