Tecnología · GUÍA PRÁCTICA
Nginx dice “upstream prematurely closed connection”: alinea la cronología antes de subir timeouts
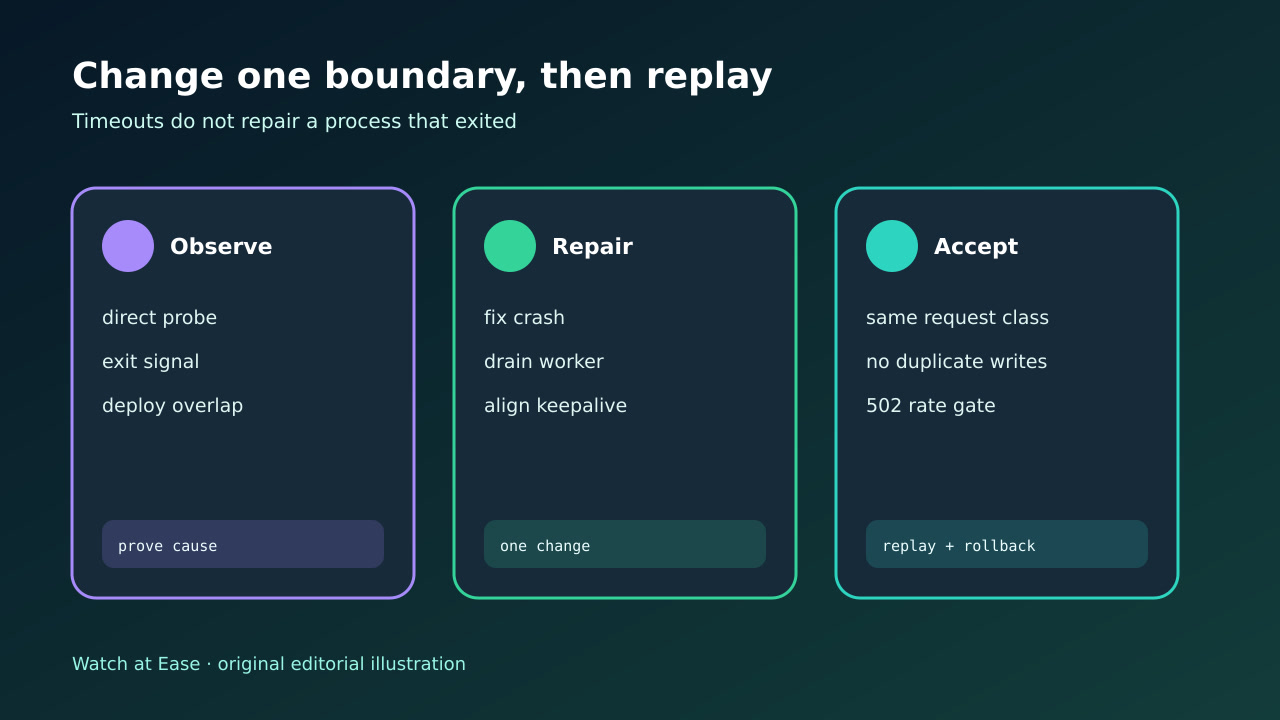
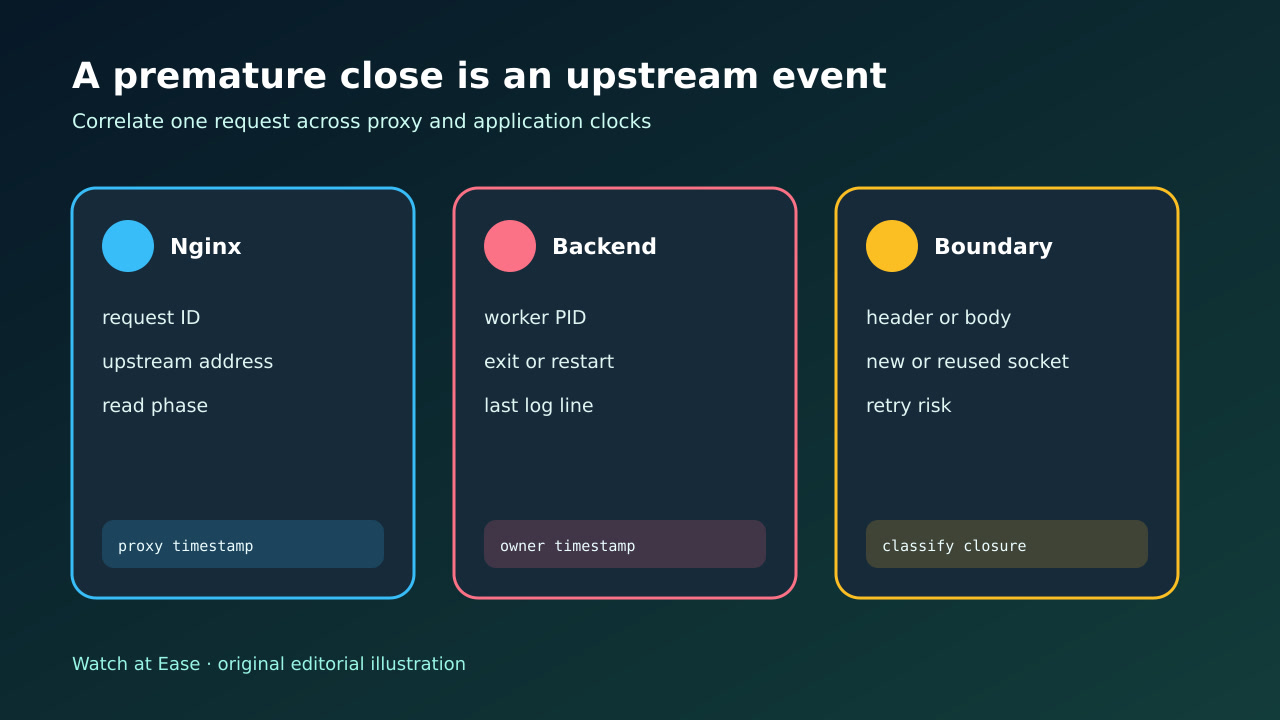
Nginx llegó al upstream, pero el peer terminó el intercambio antes de completar la respuesta esperada. Conserva fase y dirección, correlaciona la misma petición con salidas o reinicios y cambia un solo límite antes de repetir.
Nginx llegó al upstream, pero el peer terminó el intercambio antes de completar la respuesta esperada. Conserva fase y dirección, correlaciona la misma petición con salidas o reinicios y cambia un solo límite antes de repetir.
La variante response header indica que Nginx aún leía cabeceras upstream cuando terminó la conexión. proxy_read_timeout mide inactividad entre lecturas, no la duración total.
1. Conserva un fallo en ambos relojes
Guarda error completo, request ID, método, URI, estado, dirección upstream, servidor, tiempos de conexión/cabecera/respuesta y si falló leyendo cabecera o cuerpo. Conserva access log antes de rotar.
En backend guarda el mismo trace, PID, contenedor, primer y último log, código o señal, reinicios, despliegue y OOM. Corrige diferencias de reloj.
2. Separa cierre, timeout de lectura y conexión
Connection refused ocurre antes de HTTP; read timeout significa ausencia de bytes entre lecturas; premature close significa que el peer terminó mientras NGINX esperaba datos. Subir timeout no revive un proceso muerto.
Prueba el upstream exacto desde la red de NGINX con el mismo esquema, Host y petición. Un éxito no descarta reciclado, socket viejo o un miembro malo.
3. Identifica el proceso o socket upstream
Agrupa por dirección y correlaciona timeout, crash, OOM, drain, recycle, límite de tamaño, protocolo o keepalive. En sockets reutilizados compara connect time casi cero con cierre por inactividad.
No llames buffer a todo 502. NGINX muestra la fase; solo gestor y logs de aplicación explican por qué cerró el peer. Conserva ambos lados antes de reiniciar.
4. Cambia solo el límite demostrado
Corrige crash, memoria o excepción; drena workers; alinea keepalive; corrige HTTP/HTTPS; o mueve trabajo bloqueante solo cuando la cronología sostenga esa rama.
Aumenta proxy_read_timeout solo si backend sigue vivo y pausa legítimamente. Mide capacidad antes de cambiar worker timeout y no reintentes POST/PATCH sin controlar duplicados.
5. Repite con seguridad y exige una salida
Repite contra un backend y luego por NGINX: ruta normal, lenta, despliegue/recycle y conexión reutilizada. Verifica estado, cuerpo y efectos exactamente una vez.
Bajo carga exige 502 acotado, sin salidas correlacionadas, latencia estable y retry seguro. Si solo retrasa fallos o duplica escrituras, revierte.