기술 · 뉴스 해설
Nebius, Inferize 인수로 AI 추론 콜드 스타트와 유휴 GPU 비용 절감 추진
Inferize 팀과 기술은 Nebius Token Factory에 합류한다. 모델 준비 시간을 줄이고 유휴 가속기 용량을 낮추는 것이 목표지만 출시 일정, 재현 가능한 벤치마크, 고객 요금 변경은 발표되지 않았다.
Nebius는 프로덕션 AI 추론의 응답성을 높이고 사용되지 않는 가속기 용량을 줄이는 데 초점을 맞춘 이스라엘 스타트업 Inferize를 인수했다. 10월 1일 발표에 따르면 Inferize 팀과 기술은 관리형 모델 서빙 플랫폼 Token Factory에 합류한다. 거래 조건은 공개되지 않았다.
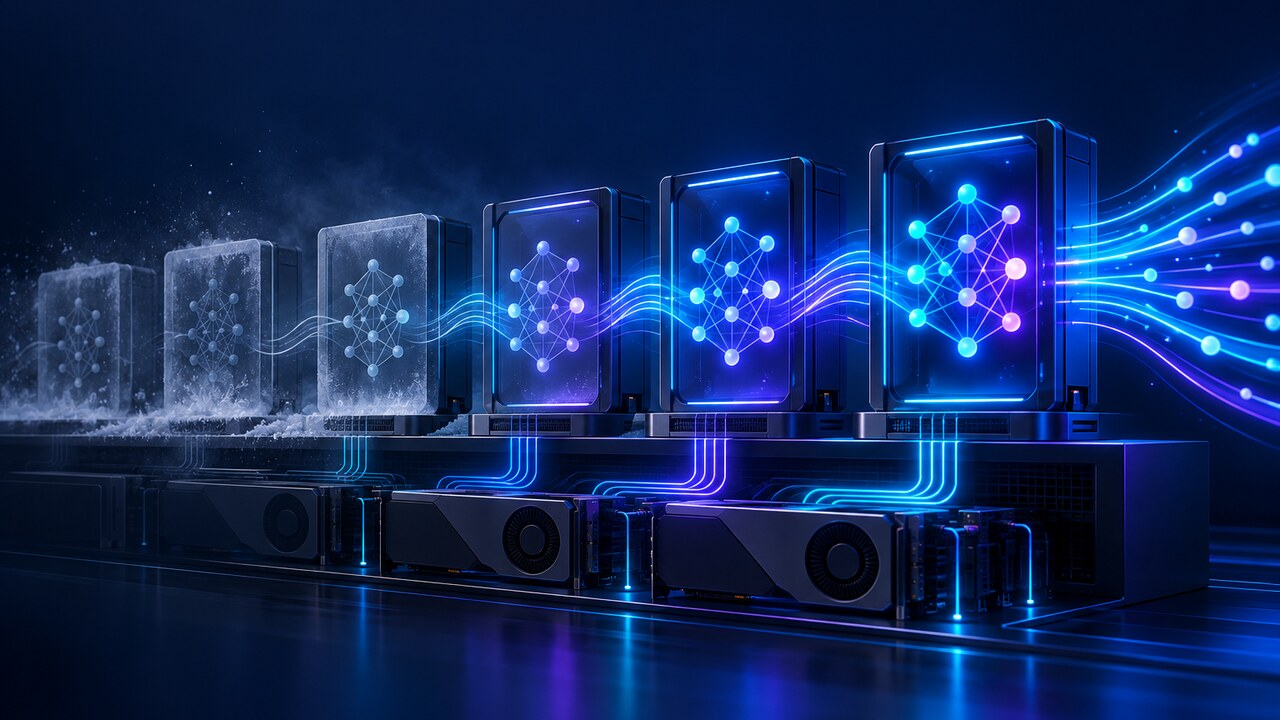
핵심은 콜드 스타트와 유휴 GPU 사이의 상충 관계다. 모델이 적절한 하드웨어에 올라가 있지 않으면 응답 전에 용량 할당, 가중치 로딩, 서빙 환경 초기화가 필요할 수 있다. 모든 모델을 계속 준비해 두면 대기 시간은 줄지만 요청이 없는 동안 값비싼 가속기가 놀 수 있다.
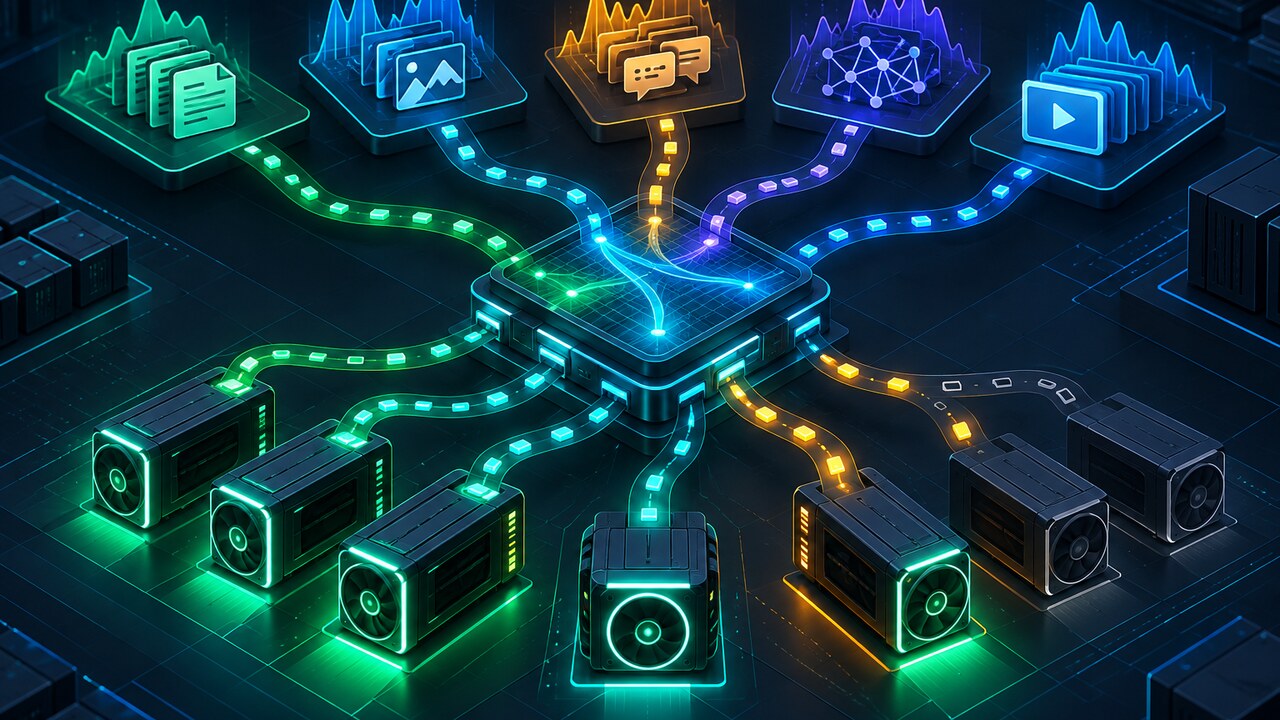
Nebius는 동적 워크로드 프로비저닝, GPU 오케스트레이션, 저지연 모델 가용성을 강화하는 인프라 통합이라고 설명한다. 이는 엔지니어링 방향이지 즉시 실현된 절감의 증거가 아니다. 공개 출시일, 재현 가능한 성능 비교, Token Factory의 새 요금은 제시되지 않았다.
Token Factory에 추가되는 역량
Token Factory는 모델 배포와 확장에 필요한 운영 작업을 대신 처리하도록 설계됐다. Nebius에 따르면 Inferize는 동적 프로비저닝, 가속기 오케스트레이션, 저지연 모델 준비를 위한 소프트웨어와 엔지니어링 역량을 보탠다.
따라서 이번 거래의 대상은 모델 서빙 계층이며 새로운 기반 모델이 아니다. Inferize는 소비자용 챗봇이나 별도로 발표된 소매 앱이 아니다. 가치는 기술이 관리형 추론 플랫폼에 어떻게 통합되는지에 달려 있다.
Nebius는 Inferize가 2026년 1월 설립돼 3개월 안에 작동하는 프로토타입을 만들었다고 밝혔다. CTech는 17명 팀이며 창업자들이 과거 인프라 최적화 회사 Granulate를 세웠고 이 회사는 이후 Intel에 인수됐다고 보도했다.
콜드 스타트와 유휴 GPU가 반대 방향으로 작용하는 이유
요청이 적절한 가속기에 상주하지 않은 모델로 들어오면 플랫폼은 용량을 찾고 모델 가중치를 옮기며 서빙 프로세스를 초기화해야 할 수 있다. 이 과정은 첫 토큰이 나오기 전 지연을 늘린다.
더 많은 용량을 계속 준비해 두면 일부 지연을 피할 수 있지만 요청이 불규칙할 때 비용이 생긴다. 갑작스러운 수요를 대비해 대기하는 하드웨어는 사용되지 않는 동안에도 자본, 전력, 운영 예산을 소모한다.
Inferize가 밝힌 목표는 수요가 나타날 때 용량을 빠르게 켜고 수요가 줄면 해제해 이 상충 관계를 좁히는 것이다. 그러나 발표는 특정 모델, 지역, 워크로드에서 얼마나 개선되는지 수치로 제시하지 않았다.
고객이 지금 말할 수 있는 것과 없는 것
인수는 Nebius가 프로덕션 추론 스택을 강화하려는 계획을 뒷받침하지만 콜드 스타트가 사라졌거나 모든 고객이 이미 Inferize 기술을 쓰고 있거나 서비스 수준이 바뀌었다는 뜻은 아니다.
지원 모델, 지역, 통합 단계, 기존 고객의 마이그레이션 조치는 공개되지 않았다. 사용자는 자신의 배포에서 기능이 제공된다고 판단하기 전에 제품 문서와 릴리스 노트를 확인해야 한다.
고객 요금 변경도 발표되지 않았다. 활용도 개선은 플랫폼 경제성에 영향을 줄 수 있지만 내부 비용 감소가 자동으로 청구액 감소로 이어지는 것은 아니며 현재 공개 근거도 그런 결론을 지지하지 않는다.
가치 추정치와 아직 없는 증거
CTech는 거래 가치를 1억~1억5천만 달러로 추정한다. 독립 매체의 맥락이지만 Nebius는 조건이 비공개라고 했고 이 수치를 확인하지 않았으므로 확정 인수가로 보도해서는 안 된다.
가장 중요한 공백은 같은 워크로드에서 첫 토큰 지연, 모델 로딩 시간, 가속기 활용도, 비용을 비교하는 재현 가능한 전후 측정이다. 공개 발표에는 이런 수치가 없다.
전략적 논리는 분명하다. Nebius는 모델 서빙을 더 빠르고 덜 낭비되게 만들려 한다. 실제 고객 영향은 통합 세부사항, 벤치마크, 제공 범위, 가격 정보가 나올 때까지 열려 있다.