科技 · 新聞解讀
Muse Spark Open 能在桌面執行,但一台 Mac Studio 裝不下
Meta 於 10 月 15 日釋出 8160 億參數開放權重模型。Apple 完整實測顯示關鍵門檻:量化版至少需要兩台最高記憶體配置的 M5 Ultra Mac Studio。
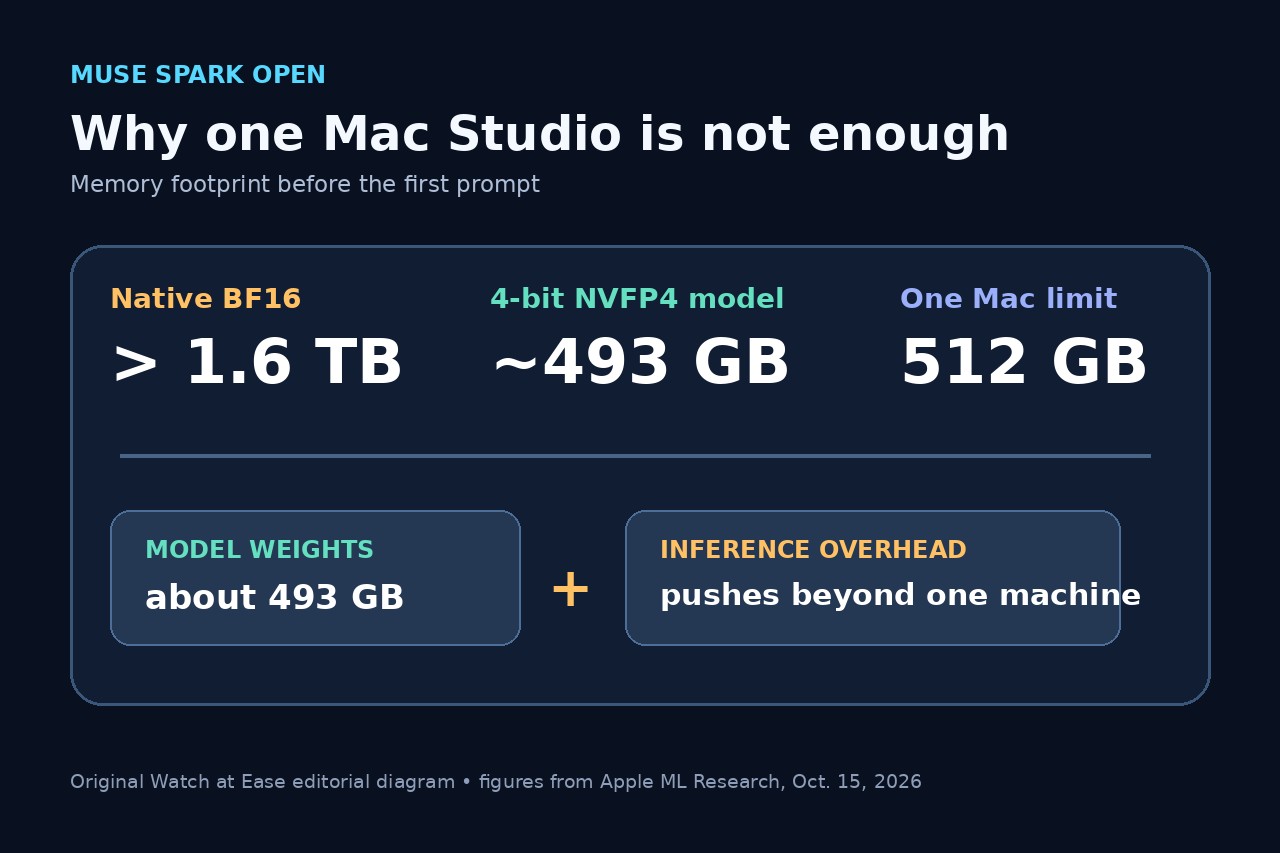
Meta 於 10 月 15 日釋出 Muse Spark Open 權重,並稱它是適合程式開發與代理工作的桌面開放權重模型。「在桌面執行」技術上正確,但 Apple 的完整基準明確寫出硬體界線:即使量化到 4 位元,8160 億參數模型仍放不進一台 512GB Mac Studio。
Meta 實際釋出了什麼
Muse Spark Open 是原生多模態混合專家模型,總計 8160 億參數、420 億啟用參數,官方宣稱有 100 萬 token 上下文。Meta 將它定位於長時程程式開發、複雜軟體工程與多步驟代理任務。權重可從 Hugging Face 等模型目錄下載,也有多家平台提供託管推論。
開放權重不等於公有領域或無限制開源。Meta 表示模型採用含有限商業條款的 Muse Model License。開發者必須依自身用途閱讀授權,不能把「可下載」視為所有商業部署都已獲准。
為何一台 512GB Mac Studio 還是不夠
Apple 報告指出,原生 BF16 精度下光是模型參數就需要超過 1.6TB 記憶體。實測的 NVFP4 版本把模型本體降到約 493GB,但推論還需要中間計算記憶體,因此工作集超過單台 Mac Studio 的 512GB 統一記憶體上限。
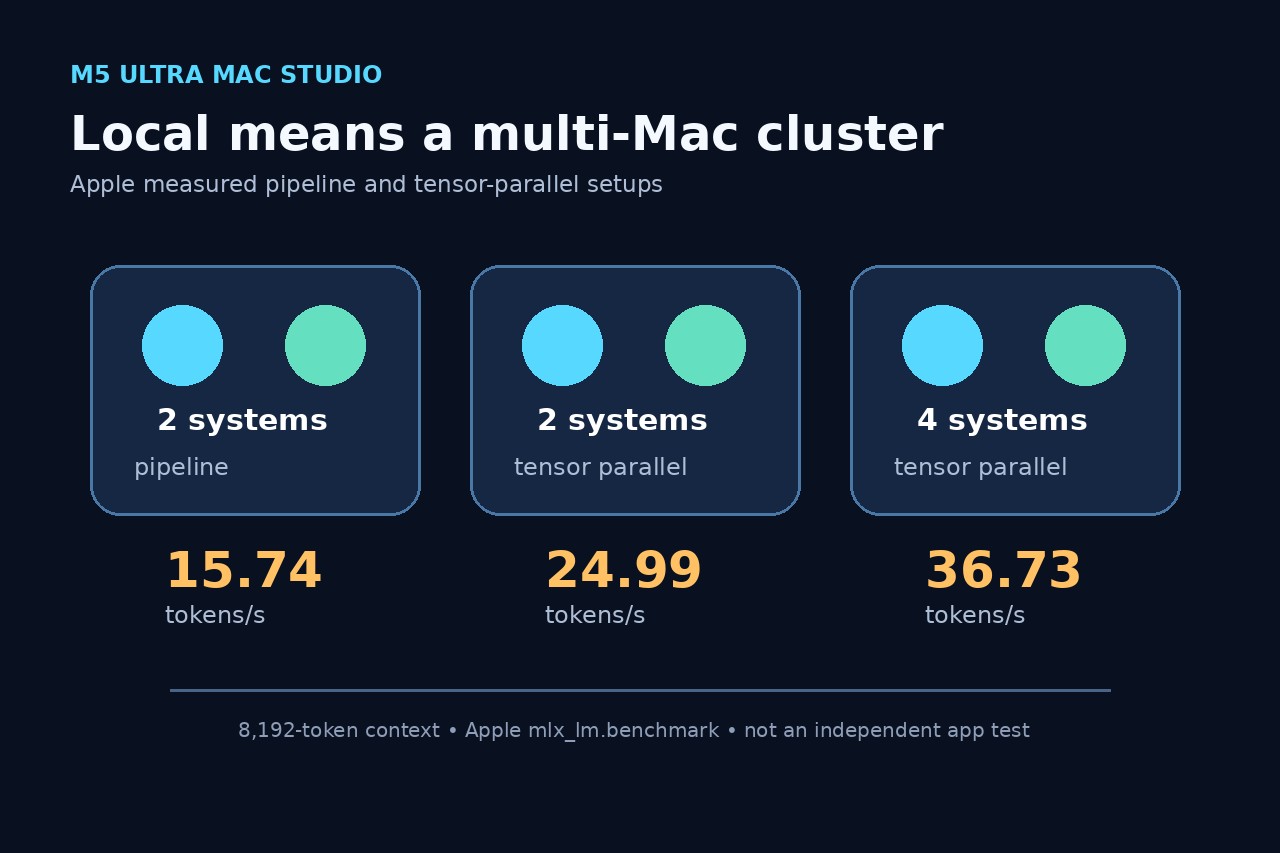
兩家公司描述的最低桌面配置使用兩台 M5 Ultra Mac Studio,讓模型各放一半並以流水線執行。Apple 也測試兩台及四台機器的張量平行,以 Thunderbolt 網狀連接。這是多電腦本地叢集,不是一般筆電或單機工作站。
Apple 的速度數據說明與未說明之處
在 8192-token 上下文下,Apple 測得兩機流水線首 token 為 8.4 秒、解碼每秒 15.74 token;兩機張量平行為 8.2 秒及每秒 24.99 token;四機則達 4.8 秒及每秒 36.73 token。這是 Apple 以 mlx_lm.benchmark 得到的結果,不是獨立應用實測,也不保證所有提示都相同。
上下文拉長時,運算與通訊的平衡會改變。Apple 說在 65536-token 上下文下,兩機張量平行的預填充可能慢於流水線,因為專家輸出正規化帶來通訊開銷。增加機器可提高解碼吞吐,但也增加成本、纜線與設定複雜度。
誰適合下載,誰適合先用 API
已擁有高記憶體 Mac Studio 且需要本地控制的實驗室,可評估兩機 MLX 路線。Apple 提供 mlx.launch 範例,Meta 也連結 MLX 轉接器。團隊仍須準備數百 GB 下載、模型儲存、兩台相容機器、高頻寬連線與營運測試。
只有一台 Mac、使用筆電或沒有維護叢集理由的開發者,更實際的方式是先用 Meta 的託管合作夥伴。較小的開放權重模型也更適合單台 Mac Studio:Apple 指出 1280 億參數的 Mistral Medium 3.5 與 270 億參數的 Qwen 3.8 都能放進一台 512GB 系統。Muse Spark Open 擴大了本地模型選擇,但此處的「本地」是桌邊叢集,不是消費裝置上的便攜執行。兩份技術來源沒有確立精確配置價格,因此本文不計算購置成本。