科技 · 新闻解读
Muse Spark Open 能在桌面运行,但一台 Mac Studio 装不下
Meta 于 10 月 15 日发布 8160 亿参数开放权重模型。Apple 的完整实测揭示关键门槛:量化版至少需要两台最高内存配置的 M5 Ultra Mac Studio。
Meta 于 10 月 15 日发布 Muse Spark Open 权重,并把它描述为适合编程与智能体工作的桌面开放权重模型。“在桌面运行”在技术上没错,但 Apple 的完整基准测试写明了硬件边界:即使压缩到 4 位,8160 亿参数模型也无法装进一台 512GB Mac Studio。
Meta 实际发布了什么
Muse Spark Open 是原生多模态混合专家模型,共 8160 亿参数、420 亿活跃参数,官方宣称上下文窗口为 100 万 token。Meta 将其定位为长周期编程、复杂软件工程和多步骤智能体任务模型。权重已可从 Hugging Face 等模型目录下载,多家平台也提供托管推理。
开放权重不等于公有领域或无条件开源。Meta 表示模型采用 Muse Model License,并带有限商业条款。开发者应针对自己的用途查看许可证,不能把“可下载”理解为所有商业部署都自动获准。
为什么一台 512GB Mac Studio 仍然不够
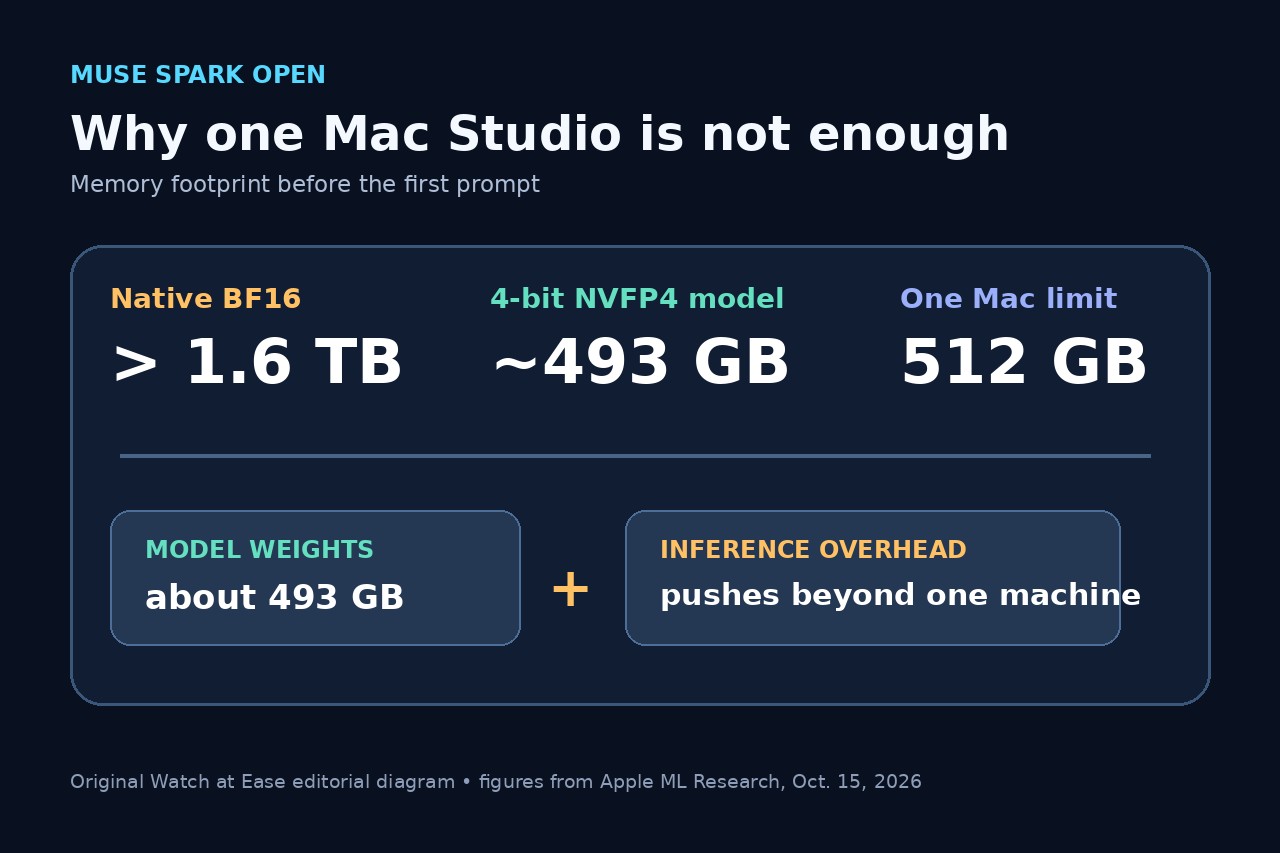
Apple 报告称,原生 BF16 精度下仅模型参数就需要超过 1.6TB 内存。其测试的 NVFP4 版本把模型本体降到约 493GB,但推理还需要中间计算内存,因此工作集会超过单台 Mac Studio 的 512GB 统一内存上限。
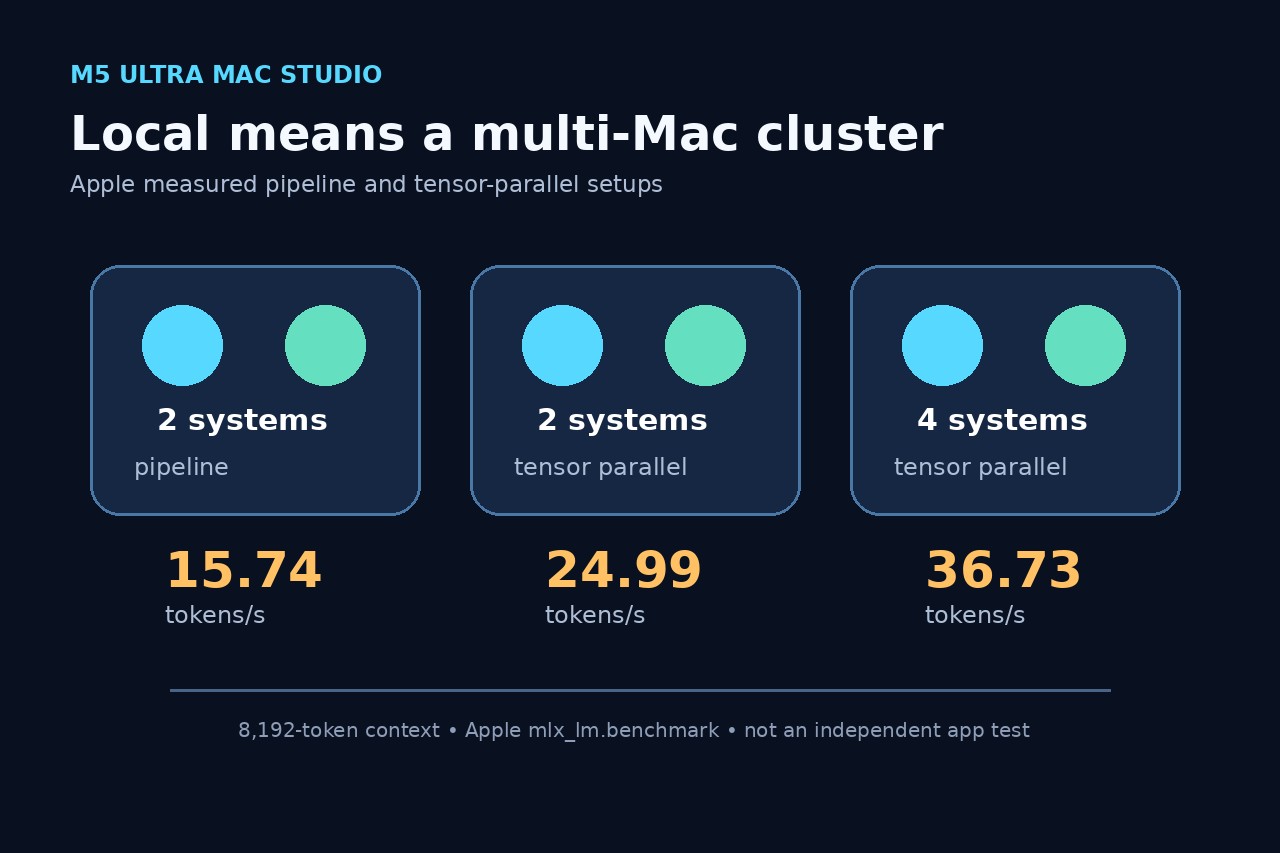
两家公司描述的最低桌面方案使用两台 M5 Ultra Mac Studio,把模型各放一半并通过流水线运行。Apple 还测试了两台和四台机器的张量并行,并用 Thunderbolt 网状连接。这是多电脑本地集群,不是普通笔记本或单机工作站。
Apple 的速度数据说明什么、不说明什么
在 8192-token 上下文下,Apple 测得两机流水线首 token 时间为 8.4 秒,解码速度为 15.74 token/秒;两机张量并行为 8.2 秒和 24.99 token/秒;四机达到 4.8 秒和 36.73 token/秒。这些是 Apple 用 mlx_lm.benchmark 得出的结果,不是独立应用实测,也不保证所有提示词都相同。
上下文增长后,计算与通信的平衡会变化。Apple 表示,在 65536-token 上下文下,两机张量并行的预填充可能慢于流水线,因为专家输出归一化增加通信开销。增加机器能提高解码吞吐,但也会增加成本、线缆和配置复杂度。
谁适合下载,谁更适合用 API
已经拥有高内存 Mac Studio、并且需要本地控制的实验室,可以评估两机 MLX 路线。Apple 给出了 mlx.launch 示例,Meta 也链接了 MLX 适配器。团队仍需为数百 GB 下载、模型存储、两台兼容机器、高带宽连接和运行测试预留资源。
只有一台 Mac、使用笔记本或没有维护集群理由的开发者,更适合先使用 Meta 的托管合作方。更小的开放权重模型也更适合单台 Mac Studio:Apple 报告 1280 亿参数的 Mistral Medium 3.5 和 270 亿参数的 Qwen 3.8 都能装进一台 512GB 系统。Muse Spark Open 扩大了本地模型选择,但这里的“本地”是桌边集群,不是消费设备便携运行。两份技术来源没有确立精确配置价格,因此本文不计算购置成本。