テクノロジー · 実用ガイド
Linuxの「Read-only file system」:再マウント前に原因を調べる
意図したマウント規則、ファイルシステムの保護状態、ストレージ経路の故障を区別する。正確なマウントを特定し、証拠を保存してから書き込みの復旧を考える。
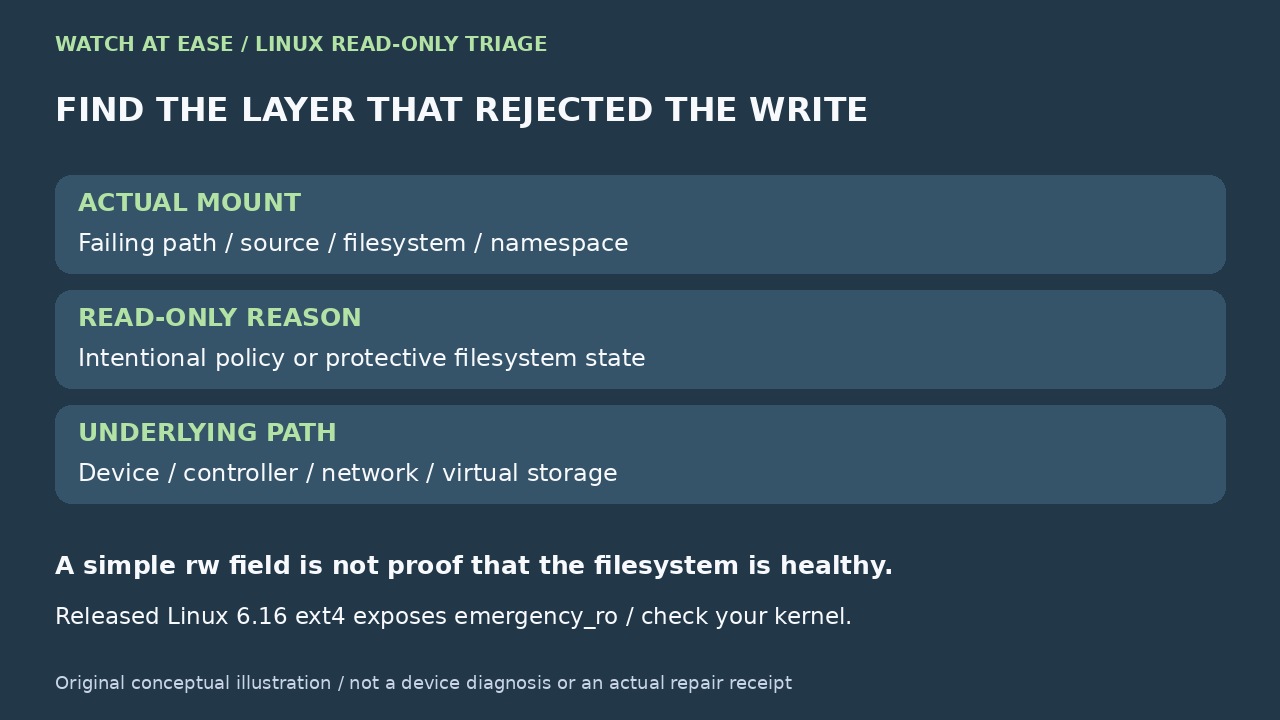
Linuxの「Read-only file system」は通常の権限エラーではない。chmod、chown、sudoで読み取り専用マウントを書き込み可能にはできない。実際に到達したマウント、エラー後のファイルシステム、下層のブロック・ネットワークストレージのどこが書き込みを拒んだのかを調べる。
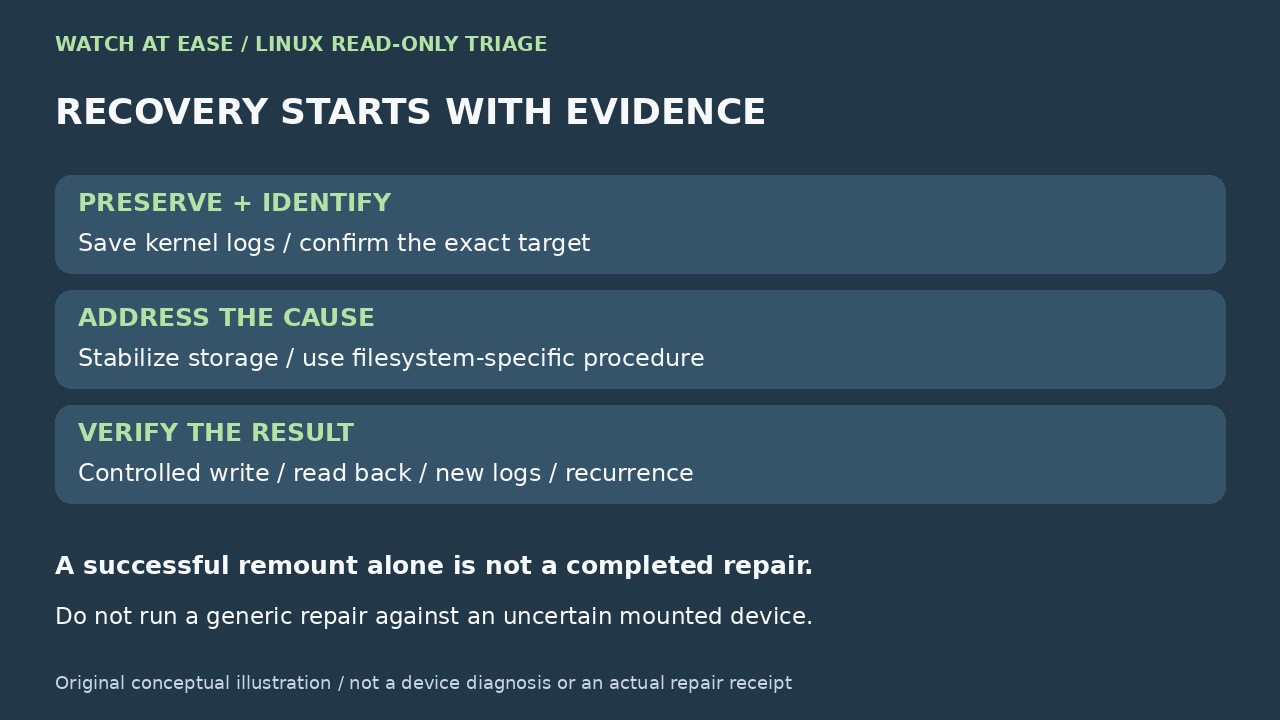
最初に強制再マウントしない。読み取り専用化は追加の破損を抑えるカーネルの保護措置かもしれず、再起動で有用なログの文脈を失う場合もある。失敗したパスを実際のマウントに対応付け、証拠を保存してから、種類と原因に合う復旧を選ぶ。
1. 失敗パスのファイルシステムを特定
EROFSが出たパスで `findmnt --target /path/that/failed -o TARGET,SOURCE,FSTYPE,OPTIONS` を使い、ディスク名を推測しない。util-linuxの手引きでは--targetはファイルまたはディレクトリを受け取り、そのファイルシステムを表示する。各欄を正確に記録する。失敗した場合や対象が不明なら、同じ名前空間で存在する親パスを確認し、マウントを確定してから修復デバイスを選ぶ。
元のパスは書けても読み取り専用bind側は書けない場合や、別のマウント名前空間のコンテナー、ネットワークファイルシステム、読み取り専用スナップショットの場合がある。コンテナーやサービス内の失敗なら、正当な管理権限の下で同じ名前空間から調べる。ホスト側の表示は拒否した環境と一致しないことがある。
SOURCEがリモート共有、loopデバイス、device-mapperボリューム、スナップショットなら、その識別を保持する。名前が似ているだけの別の物理パーティションを修復すると、問題を悪化させかねない。
2. 状態変更前に証拠を保存
障害が残っている間にマウント記録と最近のカーネルメッセージを保存する。読み取り用の例は上記findmnt、`journalctl -k -b --no-pager`、権限があれば `dmesg`。共有前にホスト名、シリアル番号、機密パスを伏せる。systemdがなければ利用可能なカーネルログ機能を使う。dmesg -Tの時刻はサスペンド復帰後に不正確な場合があり、正確な実時刻の順序を作らず元の出力を保存する。
後続の読み取り専用メッセージだけでなく、最初の関連エラーを探す。I/O error、journal abort、EXT4-fs error、device reset、link down、multipath failure、write-protectedは原因が異なる。Red Hatの実例では全ストレージ経路の喪失後にジャーナルが中止され、ファイルシステムが読み取り専用になった。
重要データを提供中なら、不要な書き込みを止め、バックアップやフェイルオーバーを準備してから試す。再マウントを何度も行っても、下層経路が正常だという証拠にはならない。
3. どの層が読み取り専用かを分類
意図した方針:OPTIONSのro、変更不可の媒体やスナップショット、/etc/fstabのro、読み取り専用bind、リモート側の読み取り専用共有など。方針を管理する層で直す。ローカルの再マウントは一時的なだけ、拒否される、または不適切な場合がある。
保護状態:ファイルシステムやジャーナルのエラーがある。ext4文書はerrors=remount-roをエラー後の読み取り専用化と説明する。リリース済みLinux 6.16では通常のSB_RDONLYを設定せず緊急読み取り専用フラグを立て、ext4オプションにemergency_roを表示する。インストールしたカーネルの動作を確認する。rwの一欄や新しい表示の不在だけでは安全な書き込みを証明できず、ログと実際の失敗を重視する。
下層の保護・故障:再マウント時のwrite-protectedや、デバイス、バス、コントローラー、ケーブル、multipath、媒体のエラー。先に経路を修復・交換する。ファイルシステム検査はメタデータ損傷を直せる場合があっても、消えるSAN経路、悪いケーブル、コントローラーリセットを直せない。
リモート・仮想層:NFS、CIFS、FUSE、クラウドボリューム、コンテナーマウント、変更不可のイメージはローカルディスク以外の理由でEROFSを返し得る。その層の方針と正常性を調べ、ext4向け手順を一律に適用しない。
4. 種類に合うツールでオフライン修復
破損が疑われるなら、停止、フェイルオーバー、救援環境の起動などで対象をアンマウントできる状態にする。その後デバイスを再確認する。e2fsckの手引きでは、マウント中のext2/ext3/ext4の検査は一般に安全ではなく、読み取りだけの検査でも結果が有効でない場合がある。
「fsckを使う」を「それらしいデバイスでfsck -yを実行する」と読み替えない。汎用フロントエンドは種類別のツールに処理を渡し、復旧モデルは異なる。Btrfsはアンマウントを推奨し、経験ある開発者・ユーザーに助言されなければ--repairを使わないよう警告する。記録したFSTYPEの現在の手引きを読み、可能ならバックアップし、メタデータを変更する操作か把握する。
ストレージ経路のエラーがある場合は、その経路を安定させてからメタデータを修復する。そうしないと書き込み再開後にまた破損しかねない。
5. 原因解消後に再マウントし検証
意図しない読み取り専用状態の原因を解消してから、記録した正確なTARGETでファイルシステムやプラットフォームの手順に従う。通常のローカル例は `mount -o remount,rw /exact/mountpoint` だが、万能な修復ではない。リモート、bind、コンテナー、スナップショット、管理ボリュームでは誤った手順になり得る。
同じ失敗パスでfindmntを再確認する。指定した安全なディレクトリで制御した書き込みを一度行い、読み戻して削除する。新しいファイルシステム・I/Oエラーをカーネルログで確認し、通常負荷を観察して再発を調べる。
対象が書け、syncやアプリケーションの往復後もテストが成功し、新たなストレージ・ファイルシステムエラーがなく、読み取り専用に戻らないことを確認して完了とする。再発するなら再マウントを修復と扱わず、保存した証拠でデバイス、コントローラー、ネットワーク経路やプラットフォームを調査する。