Tecnología · GUÍA PRÁCTICA
Linux muestra «Read-only file system»: investiga antes de remontar
Distingue una política de montaje, la protección del sistema de archivos y un fallo de almacenamiento. Identifica el montaje exacto y conserva las pruebas antes de intentar recuperar la escritura.
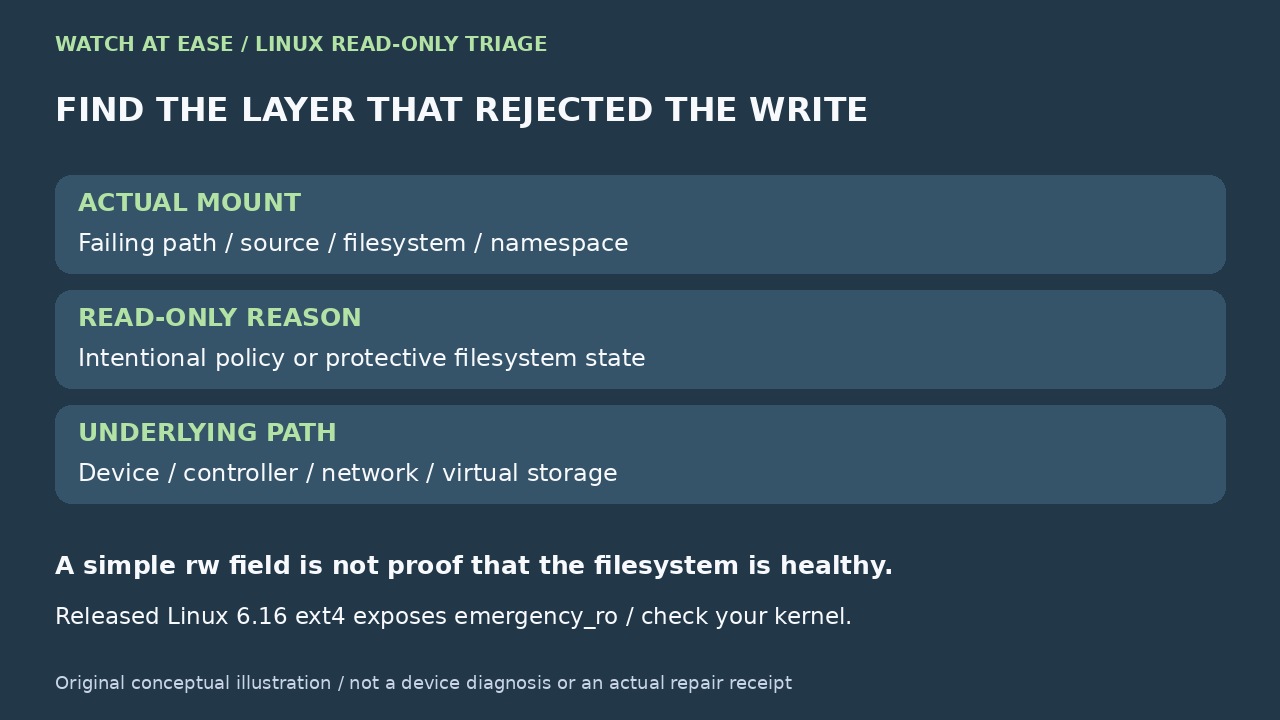
«Read-only file system» en Linux no es un error ordinario de permisos. chmod, chown y sudo no convierten un montaje de solo lectura en escribible. Hay que identificar qué capa rechazó la escritura: el montaje alcanzado, el sistema de archivos tras un error o el almacenamiento de bloques o de red inferior.
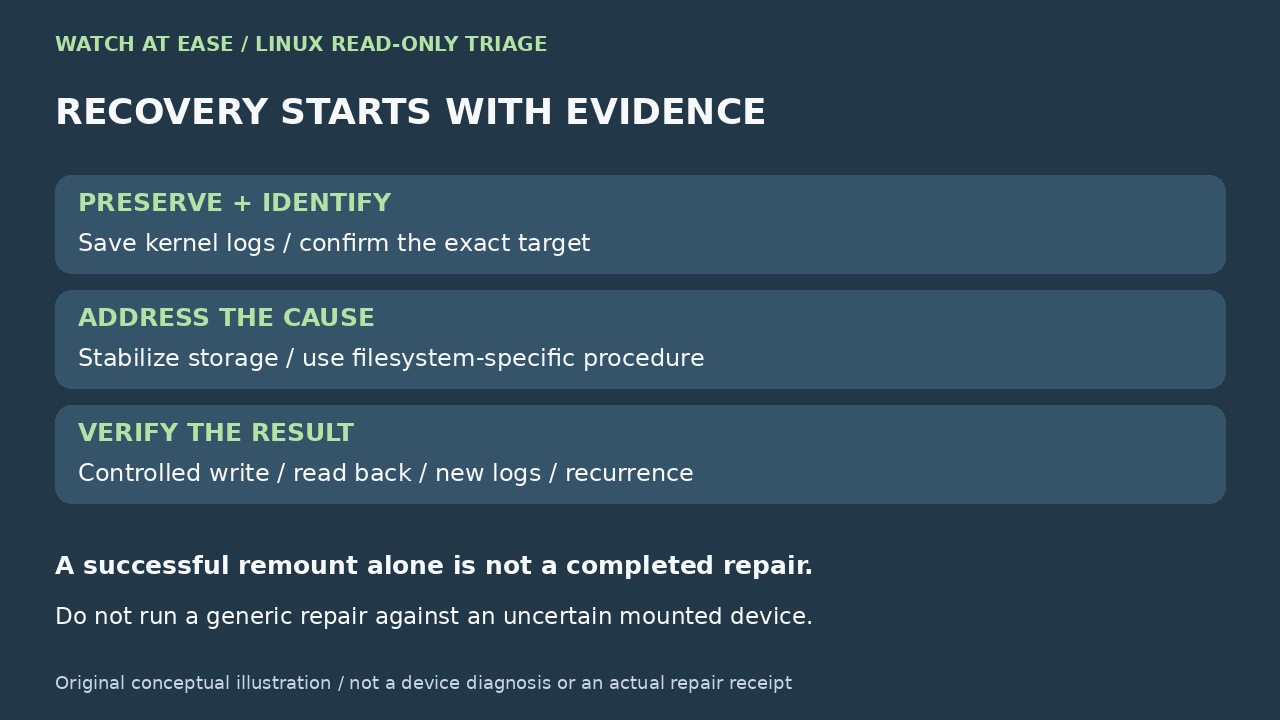
No empieces con un remontaje forzado. La transición puede ser una medida del núcleo para limitar daños, y reiniciar puede borrar el contexto más útil del registro. Relaciona la ruta afectada con su montaje real, conserva las pruebas y elige la recuperación correspondiente al sistema de archivos y a la causa.
1. Identifica el sistema de archivos de la ruta
Utiliza la ruta que produjo EROFS con `findmnt --target /path/that/failed -o TARGET,SOURCE,FSTYPE,OPTIONS`, no un disco supuesto. El manual de util-linux indica que --target acepta un archivo o directorio y muestra su sistema de archivos. Registra las cuatro columnas exactamente. Si falla o el destino es incierto, identifica un padre existente en el mismo espacio de nombres y confirma el montaje antes de elegir un dispositivo para reparar.
La ruta puede estar en un bind de solo lectura aunque el lugar original permita escritura, en un contenedor con otro espacio de nombres, en un sistema de red o una instantánea inmutable. Si falló dentro de un contenedor o servicio, inspecciona ese mismo espacio con acceso administrativo legítimo. La vista del anfitrión puede no ser la que rechazó la escritura.
Si SOURCE corresponde a una exportación remota, dispositivo loop, volumen device-mapper o instantánea, conserva esa identidad. Reparar otra partición física porque su nombre se parece puede empeorar el incidente.
2. Conserva las pruebas antes de cambiar el estado
Captura el montaje y los mensajes recientes del núcleo mientras persiste el fallo. Entre las consultas están findmnt, `journalctl -k -b --no-pager` y, si tienes permiso, `dmesg`. Oculta nombres de equipo, números de serie y rutas sensibles antes de compartirlos. Sin systemd, usa el registro disponible del sistema. Las horas de dmesg -T pueden ser imprecisas tras suspensión y reanudación: conserva la salida original, sin inventar una secuencia exacta de reloj.
Busca el primer error pertinente, no solo la cascada posterior de mensajes de solo lectura. I/O error, journal abort, EXT4-fs error, device reset, link down, multipath failure y write-protected apuntan a causas distintas. Red Hat documenta un caso en que se perdieron todas las rutas de almacenamiento, se abortó el diario y el sistema pasó a solo lectura.
Si sigue sirviendo datos importantes, detén escrituras innecesarias y prepara respaldo o conmutación por error antes de experimentar. Repetir remontajes no demuestra que la ruta inferior esté sana.
3. Clasifica la capa que está en solo lectura
Política intencionada: OPTIONS contiene ro, el medio o la instantánea son inmutables, /etc/fstab solicita ro, el bind es de solo lectura o el servidor exporta así el recurso. Corrige la política en la capa responsable. Un remontaje local puede ser temporal, rechazado o inadecuado.
Estado protector: hay errores del sistema o del diario. ext4 documenta errors=remount-ro como paso a solo lectura ante un error. El código publicado de Linux 6.16 establece una bandera de emergencia sin establecer SB_RDONLY y muestra emergency_ro en las opciones ext4. Consulta el comportamiento del núcleo instalado: un campo rw sencillo, o la ausencia de la marca nueva, no prueban que sea seguro escribir. Considera el registro y el fallo real.
Protección o fallo inferior: aparece write-protected al remontar, o errores de dispositivo, bus, controlador, cable, multipath o medio. Repara o sustituye primero la ruta averiada. Un comprobador puede corregir daños de metadatos, pero no una ruta SAN que desaparece, un cable defectuoso o un controlador que se reinicia.
Capa remota o virtual: NFS, CIFS, FUSE, un volumen en la nube, contenedor o imagen inmutable pueden devolver EROFS por causas ajenas al disco local. Sigue las pruebas de salud y política de esa capa, sin aplicar una receta ext4 a todas.
4. Repara sin montar con el comprobador adecuado
Si hay indicios de daño, organiza una parada, conmutación o arranque de rescate para desmontar el objetivo. Confirma otra vez el dispositivo después. El manual de e2fsck advierte que generalmente no es seguro comprobar ext2/ext3/ext4 montados; incluso una comprobación nominalmente de solo lectura puede producir resultados inválidos mientras estén montados.
No traduzcas «ejecutar fsck» como «fsck -y sobre un dispositivo que parece correcto». El programa genérico delega en herramientas específicas y sus modelos difieren. Btrfs recomienda desmontar primero y no usar --repair salvo consejo de un desarrollador o usuario experimentado. Consulta el manual actual del FSTYPE registrado, respalda si es posible y entiende si la operación modifica metadatos.
Si hay un fallo de la ruta de almacenamiento, estabilízala antes de reparar metadatos. De otro modo, el sistema reparado puede dañarse de nuevo al reanudar las escrituras.
5. Resuelve la causa, remonta y verifica
Después de corregir la causa de un estado no intencionado, utiliza el TARGET exacto y el procedimiento del sistema o plataforma. Un ejemplo local es `mount -o remount,rw /exact/mountpoint`, pero no es una reparación universal. Puede ser incorrecto para recursos remotos, bind, contenedores, instantáneas o volúmenes gestionados.
Verifica por capas: repite findmnt para la ruta afectada, realiza una escritura controlada en un directorio seguro designado, léela y elimínala. Revisa nuevos errores del sistema o I/O en el registro y observa la carga habitual para detectar recurrencia.
Da por terminado el incidente solo si el montaje permite escritura, la prueba sigue siendo correcta tras sync o una ida y vuelta de la aplicación, no surgen errores y no regresa el estado de solo lectura. Si vuelve, deja de tratar el remontaje como solución y utiliza las pruebas para investigar dispositivo, controlador, red o plataforma.