Tecnología · GUÍA PRÁCTICA
¿Linux dice “fork: Resource temporarily unavailable”? Demuestra primero qué presupuesto se agotó
Distingue los límites de PID o hilos por usuario, cgroup, systemd y kernel antes de elevarlos, matar procesos o reiniciar.
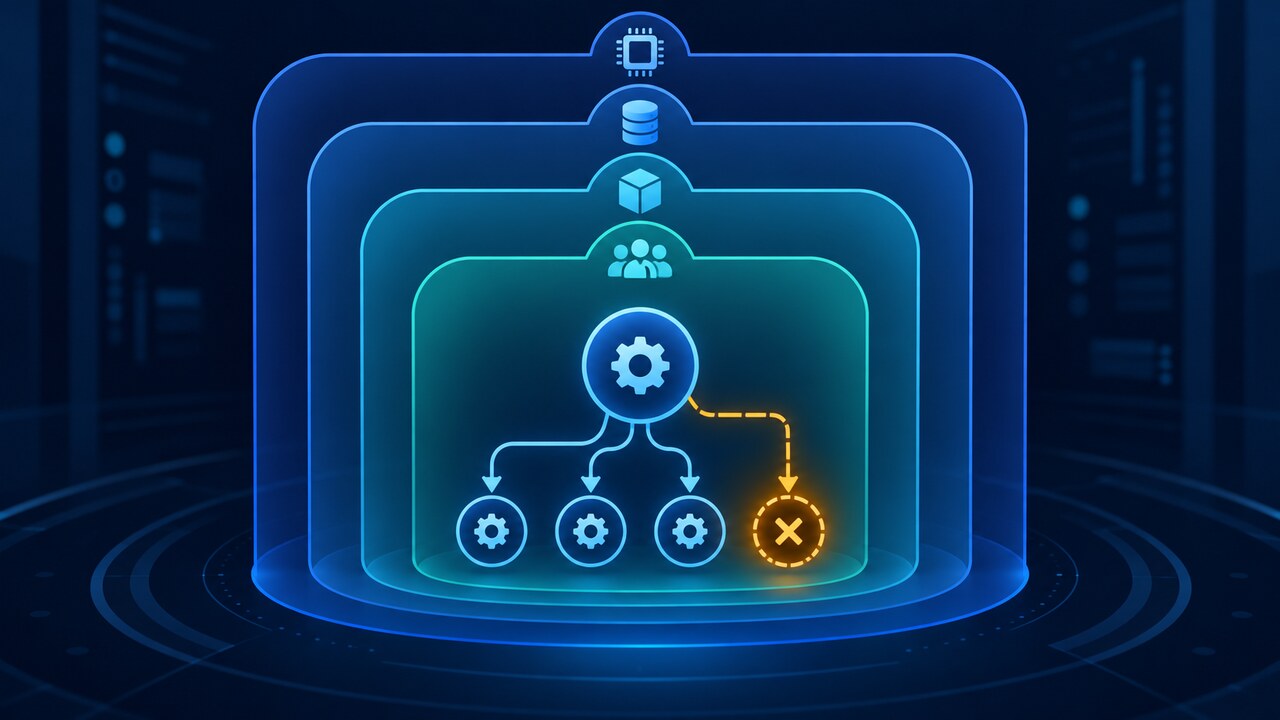
fork o clone puede devolver EAGAIN aunque la memoria y los descriptores parezcan sanos. El presupuesto agotado puede pertenecer a un usuario, un cgroup, una unidad systemd o al host.
Esta auditoría conserva la evidencia, identifica el límite efectivo y al dueño de la expansión de procesos o hilos, y verifica la corrección mínima reversible.
Congela el fallo antes de liberar tareas
Conserva un shell de recuperación y copia comando, hora, usuario, servicio o contenedor, stderr y estado antes de reiniciar. Distingue EAGAIN de ENOMEM; fork(2) los documenta por separado y una impresión de falta de memoria no sustituye al errno real.
Desde el mismo ámbito captura PID, PPID, usuario, comando y NLWP, además de despliegues o tráfico recientes. No empieces con un kill masivo: puede borrar el árbol y los contadores que identifican el presupuesto y al dueño del crecimiento.
Prueba primero el presupuesto por usuario
fork(2) enumera RLIMIT_NPROC como causa de EAGAIN. En Linux se aplica a tareas, más precisamente hilos, del UID real. Compara UID y límites blando y duro del proceso, y cuenta hilos vivos en lugar de solo filas de procesos.
Un ulimit alto en tu shell no demuestra el valor efectivo del servicio. Obtén los límites desde el proceso que falla o su gestor, y separa la cuenta de servicio del operador. Si está cerca del techo, identifica ejecutable y padre que crecen.
Localiza el cgroup y lee su libro de PID
El controlador pids de cgroup v2 cuenta tareas, incluidos hilos. Lee pids.current, pids.peak, pids.events y pids.max del cgroup afectado. El aumento del evento max demuestra intentos de fork o clone que cruzaron el límite y recibieron EAGAIN.
En una unidad systemd compara TasksCurrent, TasksMax y EffectiveTasksMax. TasksMax corresponde a pids.max y el valor efectivo refleja padres más estrictos. Lee la unidad y cgroup reales, sin asumir que contenedor, slice y host tienen el mismo margen.
Revisa los techos del host después de los límites cercanos
Si usuario y cgroup tienen margen, inspecciona threads-max, pid_max y el total de tareas. fork(2) cita ambos como causas de EAGAIN; un pid_max grande no descarta threads-max, usuario o cgroup anidado.
Separa este nivel de los descriptores. Elevar nofile o cerrar sockets no crea presupuesto de PID o hilos. Registra SCHED_DEADLINE sin reset-on-fork si aplica, pero no uses ese caso especializado como explicación predeterminada.
Encuentra y clasifica al dueño de la expansión
Ordena por hilos y descendientes; inspecciona padre, servicio y carga principales frente a una base sana. Un NLWP que crece rápido sugiere fuga de hilos; muchos hijos breves pueden indicar tormenta de reintentos, demasiados workers o cambio de concurrencia.
Decide si es concurrencia legítima o crecimiento sin control. Conserva logs, muestras de pila y árbol antes de mitigar. Reiniciar o matar puede recuperar capacidad, pero sin dueño y patrón convierte un agotamiento diagnosticable en incidente recurrente.
Aplica la corrección mínima reversible
Prefiere detener al productor desbocado, reducir workers o reintentos, o corregir el límite del servicio que se demostró bajo. Eleva un límite solo si la carga estable y un margen documentado lo justifican; evita infinito y cambios para todos los usuarios.
Registra valor anterior, nuevo, dueño, motivo y reversión. En systemd cambia la unidad controlada y recarga por la vía normal; en cgroup o contenedor cambia la configuración fuente, no una escritura efímera de ejecución.
Repite la ruta exacta y demuestra margen
Tras mitigar, repite el comando o carga desde el mismo usuario, unidad y contenedor. Confirma que se crea el hijo, no solo que un envoltorio dejó de mostrar el error. Revisa hilos, pids.current frente a pids.max, pids.events y techos del host.
Éxito significa que fork o clone funciona, el evento relevante deja de aumentar y el uso permanece bajo el límite durante una observación. Guarda evidencia y reversión; un reinicio exitoso sin estas pruebas es recuperación, no diagnóstico.