テクノロジー · 実用ガイド
Linuxでファイル監視上限のENOSPC?sysctlを上げる前にinotify消費台帳を作る
同じENOSPCでも、監視マーク、inotifyインスタンス、キュー、同一ユーザーの別プロセスが原因になり得ます。まず読み取り専用で棚卸しします。
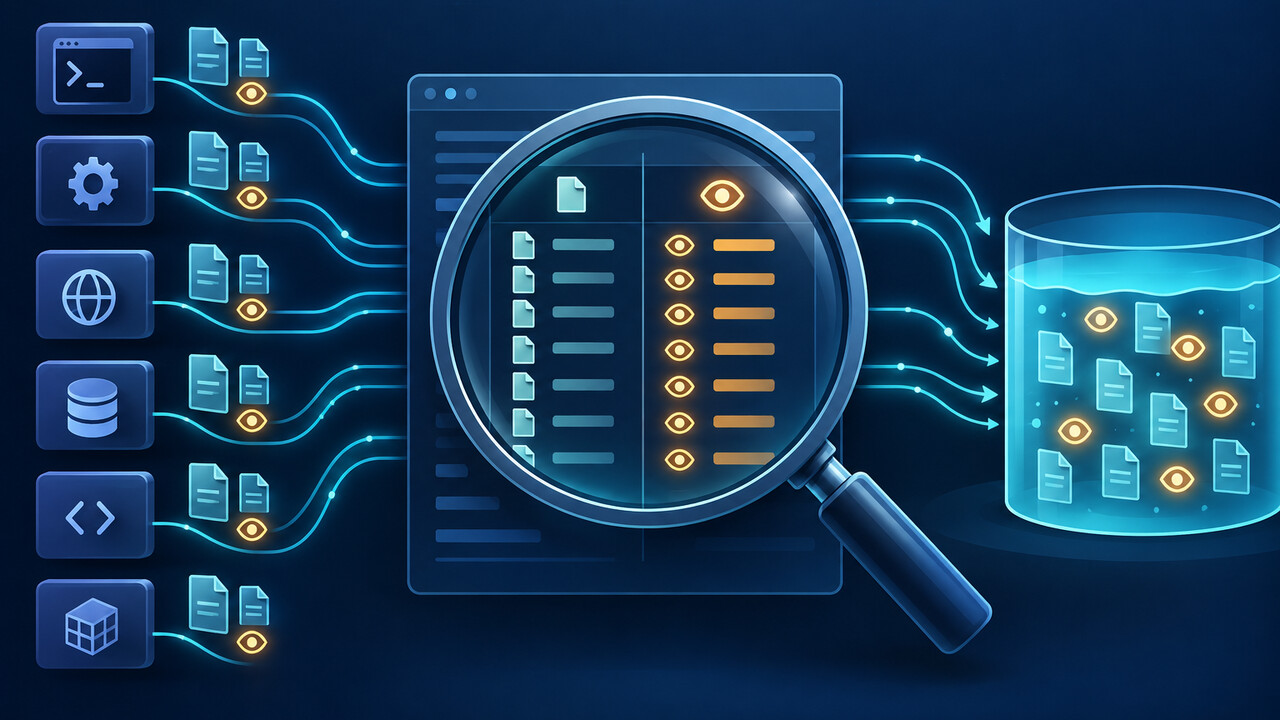
Linuxの開発ツールが `ENOSPC: System limit for number of file watchers reached` と表示する場合、多くはディスク満杯ではなくinotify資源の枯渇です。エラーのパスは次に登録できなかった場所であり、最大消費プロセスを示すとは限りません。
制限は実ユーザーID単位なので、エディター、言語サーバー、開発サーバー、テスト、同期ツール、コンテナが同じ枠を共有します。`max_user_watches`が高くても`max_user_instances`は枯渇し、キューあふれは別の故障です。
sysctl変更、再起動、一括終了の前に、`/proc`から読み取り専用の消費台帳を作ります。上限、インスタンス、マーク、プロセス、権限欠落、名前空間を比較し、一つの可逆な変更だけを再測定します。
inotify系のENOSPCかを確認する
正確なエラー、コマンド、OS、パスを保存します。`fs.watch`、Chokidar、Watchpack、エディターなどLinuxの監視登録で失敗したならinotify枯渇が有力です。書き込み失敗なら`df -h`と`df -i`も確認します。
`id -ru`で実ユーザーIDを記録し、`max_user_watches`、`max_user_instances`、`max_queued_events`を読みます。前二つは登録失敗、キューあふれは`IN_Q_OVERFLOW`とイベント欠落を起こします。
インスタンスと監視マークを別々に数える
inotifyインスタンスは`anon_inode:inotify`記述子ですが、一つに多くのマークが入ります。記述子数はインスタンス数を示しても、`max_user_watches`への距離は示しません。
読み取れる各inotify `fdinfo`で`inotify`から始まる行を数え、PIDと実UIDごとに合計します。記述子数は独立した`instances`列に残します。
権限欠落を表せる消費台帳を作る
各PIDについて実UID、プロセス名、インスタンス数、マーク数を記録します。`/proc/<pid>/cmdline`の文字列を実行してはいけません。走査中に終了したプロセスは競合として扱い、ゼロにしません。
拒否または読めない`fdinfo`も数えます。自分のプロセスだけでもユーザー単位の診断はできますが、全システムに他の消費者がいない証明にはなりません。hidepid、コンテナ、名前空間境界では対象プロセス側の名前空間で再実行します。
テスト済みの読み取り専用台帳を実行する
次のスクリプトを`inotify-ledger.sh`として保存し、内容を確認してから`bash inotify-ledger.sh`を実行します。procfsとsysctlファイルを読むだけで、sysctl書き込み、プロセス終了、サービス再起動、削除、私的パス解決は行いません。
```bash #!/usr/bin/env bash set -u printf 'setting\tvalue\n' for name in max_user_watches max_user_instances max_queued_events; do path="/proc/sys/fs/inotify/${name}" if [[ -r "$path" ]]; then IFS= read -r value < "$path" printf '%s\t%s\n' "$name" "$value" else printf '%s\tUNREADABLE\n' "$name" fi done printf '\npid\truid\tcomm\tinstances\twatches\tunreadable_fdinfo\n' for proc in /proc/[0-9]*; do pid=${proc##*/} [[ -r "$proc/status" ]] || continue ruid=$(awk '/^Uid:/{print $2; exit}' "$proc/status" 2>/dev/null || true) [[ -n "$ruid" ]] || continue comm=$(tr '\t\n' ' ' < "$proc/comm" 2>/dev/null || true) instances=0 watches=0 unreadable=0 shopt -s nullglob for fdinfo in "$proc"/fdinfo/*; do fd=${fdinfo##*/} target=$(readlink "$proc/fd/$fd" 2>/dev/null || true) [[ "$target" == "anon_inode:inotify" ]] || continue ((instances+=1)) if [[ -r "$fdinfo" ]]; then count=$(awk '/^inotify /{n++} END{print n+0}' "$fdinfo" 2>/dev/null || printf '0') ((watches+=count)) else ((unreadable+=1)) fi done if ((instances > 0 || watches > 0 || unreadable > 0)); then printf '%s\t%s\t%s\t%s\t%s\t%s\n' "$pid" "$ruid" "$comm" "$instances" "$watches" "$unreadable" fi done | sort -t $'\t' -k5,5nr -k4,4nr printf '\nnamespace\ttarget\n' for ns in pid user mnt; do printf 'self_%s\t%s\n' "$ns" "$(readlink "/proc/self/ns/$ns" 2>/dev/null || printf 'UNREADABLE')" printf 'init_%s\t%s\n' "$ns" "$(readlink "/proc/1/ns/$ns" 2>/dev/null || printf 'UNREADABLE')" done ```
隔離テストでは一つのNode.jsプロセスが三つの一時ディレクトリを監視し、台帳はインスタンス1、マーク3を正しく報告しました。PID 1の名前空間が読めない環境では`UNREADABLE`を残し、見えない利用をゼロにしません。
失敗パスと最大消費者を混同しない
例外のパスは上限に達した登録先です。最大消費者は別ワークスペース、拡張ホスト、言語サーバー、同期ツール、長寿命プロセスかもしれません。公開issueでは拡張が数万マークを使い、別のserveが先に失敗しました。
台帳をマーク数で並べ、確認済みで不要な消費者を一つだけ通常終了して再実行します。大きな低下が因果の証拠です。再起動は証拠を消し、同じ広い監視が戻るかを示しません。
上限変更前に監視範囲を監査する
最大消費者の監視ルートと除外設定を確認します。`.venv`、生成物、キャッシュ、依存ディレクトリは監視価値が低いことがあります。VS Codeは`files.watcherExclude`で大きな不要フォルダーを先に除外するよう案内しています。
一般的な`node_modules`除外が全監視器に効くとは限りません。エディター、拡張、言語サーバー、テスト、フレームワークは別々に購読できます。マーク所有コンポーネントを変更し、台帳の減少と必要イベントの維持を確認します。
台帳が必要性を示した上限だけ上げる
正当な範囲が`max_user_watches`を超えるなら、メモリ余裕を考えた値をディストリビューションのsysctl方法で適用します。インスタンス枯渇ならマーク上限だけ変えても無効です。旧値、設定ファイル、アプリ版を保存します。
万能の数字を全ホストに貼らないでください。VS Codeは524,288を一例として最悪時のメモリ費用も示しますが、コンテナ、小VM、複数ユーザーでは予算が違います。適用後の値、台帳、メモリを再確認します。
ランダムな修正ではなく分岐表を使う
一PIDが支配的ならその消費者の範囲や版を見直します。多くの妥当な消費者が合計で上限を超えるなら`max_user_watches`を慎重に上げます。インスタンスが上限に近ければオブジェクト過多や漏れを調べ、不完全台帳なら可視性を先に解決します。
両方が十分低いなら最小ワークスペースで再現し、アプリ自身の監視ログを確認します。報告には前後の台帳、正確な上限、カーネルとアプリの版、最小再現を付け、秘密や私的パス一覧は付けません。