Tecnología · GUÍA PRÁCTICA
¿ENOSPC por el límite de vigilantes en Linux? Cree un registro de consumidores inotify antes de subir sysctl
El mismo ENOSPC puede deberse a marcas, instancias, la cola o a otro proceso del mismo usuario. Haga primero un inventario de solo lectura.
Cuando una herramienta de desarrollo muestra `ENOSPC: System limit for number of file watchers reached`, normalmente se agotó un recurso de inotify, no el directorio del proyecto. La ruta del error suele ser el siguiente registro que falló; no identifica al mayor consumidor.
Los límites se cobran por ID de usuario real, de modo que editor, servidor de lenguaje, servidor de desarrollo, pruebas, sincronización y contenedores comparten el mismo fondo. Un `max_user_watches` alto no impide agotar `max_user_instances`; el desbordamiento de cola es un tercer fallo.
Antes de subir sysctl, reiniciar o terminar procesos en masa, construya un registro de consumidores de solo lectura desde `/proc`. Compare límites, instancias, marcas, identidad, permisos y espacios de nombres; después haga un solo cambio reversible y vuelva a medir.
Confirme que es la rama ENOSPC de inotify
Guarde el error exacto, comando, sistema y ruta. Si falla `fs.watch`, Chokidar, Watchpack, un editor u otro registro de vigilancia de Linux, el agotamiento de inotify es una hipótesis fuerte. Si falla una escritura, revise también `df -h` y `df -i`.
Anote el usuario real con `id -ru` y lea `max_user_watches`, `max_user_instances` y `max_queued_events`. Los dos primeros causan fallos de registro; la cola pierde eventos y emite `IN_Q_OVERFLOW`.
Cuente por separado instancias y marcas
Una instancia inotify es un descriptor `anon_inode:inotify`, pero puede contener muchas marcas. El número de descriptores revela instancias, no la distancia hasta `max_user_watches`.
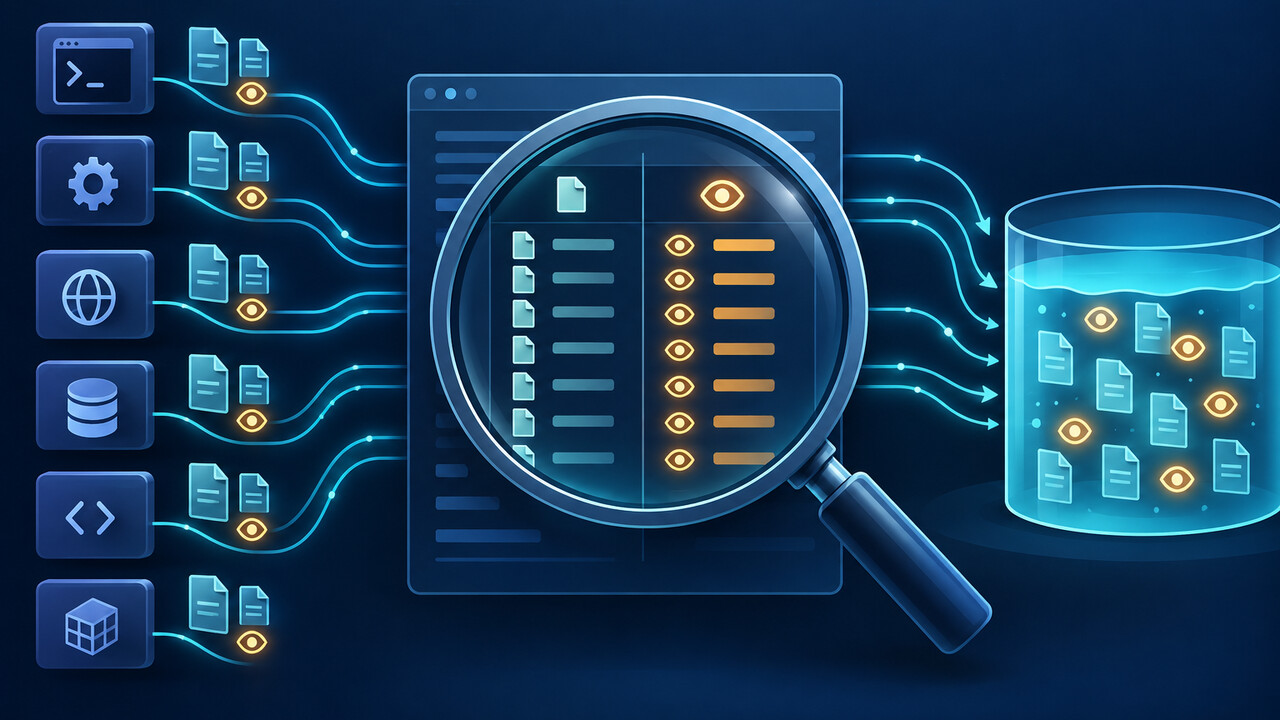
En cada `fdinfo` inotify legible cuente las líneas que empiezan por `inotify`. Sume por PID y UID real, y conserve el número de descriptores en una columna independiente `instances`.
Cree un registro consciente de los permisos
Para cada PID inspeccionable registre UID real, nombre, instancias y marcas. No ejecute texto leído de `/proc/<pid>/cmdline`. Si un proceso desaparece durante el recorrido, márquelo como carrera, no como cero.
Cuente también los `fdinfo` denegados o ilegibles. Ver solo procesos propios puede diagnosticar el fondo por usuario, pero no demuestra ausencia en todo el sistema. Con hidepid, contenedores o espacios de nombres, repita el inventario en el espacio que posee el proceso afectado.
Ejecute el registro probado de solo lectura
Guarde el script como `inotify-ledger.sh`, revíselo y ejecute `bash inotify-ledger.sh`. Solo lee procfs y archivos sysctl; no escribe sysctl, termina procesos, reinicia servicios, borra archivos ni resuelve rutas privadas.
```bash #!/usr/bin/env bash set -u printf 'setting\tvalue\n' for name in max_user_watches max_user_instances max_queued_events; do path="/proc/sys/fs/inotify/${name}" if [[ -r "$path" ]]; then IFS= read -r value < "$path" printf '%s\t%s\n' "$name" "$value" else printf '%s\tUNREADABLE\n' "$name" fi done printf '\npid\truid\tcomm\tinstances\twatches\tunreadable_fdinfo\n' for proc in /proc/[0-9]*; do pid=${proc##*/} [[ -r "$proc/status" ]] || continue ruid=$(awk '/^Uid:/{print $2; exit}' "$proc/status" 2>/dev/null || true) [[ -n "$ruid" ]] || continue comm=$(tr '\t\n' ' ' < "$proc/comm" 2>/dev/null || true) instances=0 watches=0 unreadable=0 shopt -s nullglob for fdinfo in "$proc"/fdinfo/*; do fd=${fdinfo##*/} target=$(readlink "$proc/fd/$fd" 2>/dev/null || true) [[ "$target" == "anon_inode:inotify" ]] || continue ((instances+=1)) if [[ -r "$fdinfo" ]]; then count=$(awk '/^inotify /{n++} END{print n+0}' "$fdinfo" 2>/dev/null || printf '0') ((watches+=count)) else ((unreadable+=1)) fi done if ((instances > 0 || watches > 0 || unreadable > 0)); then printf '%s\t%s\t%s\t%s\t%s\t%s\n' "$pid" "$ruid" "$comm" "$instances" "$watches" "$unreadable" fi done | sort -t $'\t' -k5,5nr -k4,4nr printf '\nnamespace\ttarget\n' for ns in pid user mnt; do printf 'self_%s\t%s\n' "$ns" "$(readlink "/proc/self/ns/$ns" 2>/dev/null || printf 'UNREADABLE')" printf 'init_%s\t%s\n' "$ns" "$(readlink "/proc/1/ns/$ns" 2>/dev/null || printf 'UNREADABLE')" done ```
La prueba aislada hizo que un proceso Node.js vigilara tres directorios temporales distintos. El registro informó una instancia y tres marcas. Cuando el espacio de nombres de PID 1 no era legible, conservó `UNREADABLE` en vez de presentar la falta de visibilidad como uso cero.
No confunda la ruta fallida con el mayor consumidor
La ruta de la excepción es el registro que alcanzó el límite. El mayor consumidor puede ser otro espacio de trabajo, un host de extensiones, un servidor de lenguaje, un sincronizador o un proceso duradero. Incidencias públicas muestran una extensión con decenas de miles de marcas mientras fallaba otro proceso serve.
Ordene el registro por marcas, cierre normalmente un consumidor confirmado y no esencial y repita. Una caída grande relaciona causa y efecto. Reiniciar puede vaciar el fondo, pero borra la atribución y no indica si el alcance amplio volverá.
Audite el alcance antes de cambiar el techo
Asocie el mayor consumidor con sus raíces y exclusiones. Árboles como `.venv`, salidas de compilación, cachés y dependencias pueden aportar poco valor. VS Code recomienda `files.watcherExclude` para carpetas grandes e irrelevantes antes de subir límites.
No suponga que excluir `node_modules` llega a todos los vigilantes. Editores, extensiones, servidores de lenguaje, pruebas y frameworks pueden suscribirse por separado. Cambie el componente dueño de las marcas y confirme que baja el registro sin perder eventos necesarios.
Suba un límite solo si el registro lo justifica
Si el alcance legítimo supera `max_user_watches`, elija un valor medido con margen de memoria y aplíquelo por la vía sysctl de la distribución. Si se agotaron instancias, cambiar solo marcas no sirve. Conserve el valor anterior, archivo y versiones para revertir.
No copie una cifra universal. VS Code documenta 524.288 como máximo posible y advierte del coste de memoria, pero contenedores, VM pequeñas y sistemas multiusuario tienen presupuestos distintos. Confirme el valor efectivo, repita la carga y compare registro y memoria.
Use una matriz de ramas, no arreglos al azar
Si domina un PID, reduzca o actualice ese consumidor. Si muchos consumidores legítimos superan juntos las marcas, aumente `max_user_watches` con prudencia. Si las instancias rozan `max_user_instances`, busque demasiados objetos o fugas. Si el registro está incompleto, resuelva primero la visibilidad.
Si marcas e instancias quedan muy por debajo de los límites, reproduzca en un espacio mínimo y revise los registros propios de la aplicación. Escale con el registro antes y después, límites exactos, versiones del kernel y la app y una reproducción mínima, nunca con secretos ni listas de rutas privadas.