科技 · 實用指南
Kubernetes 出現 CrashLoopBackOff?重啟 Pod 前先保存上次終止證據
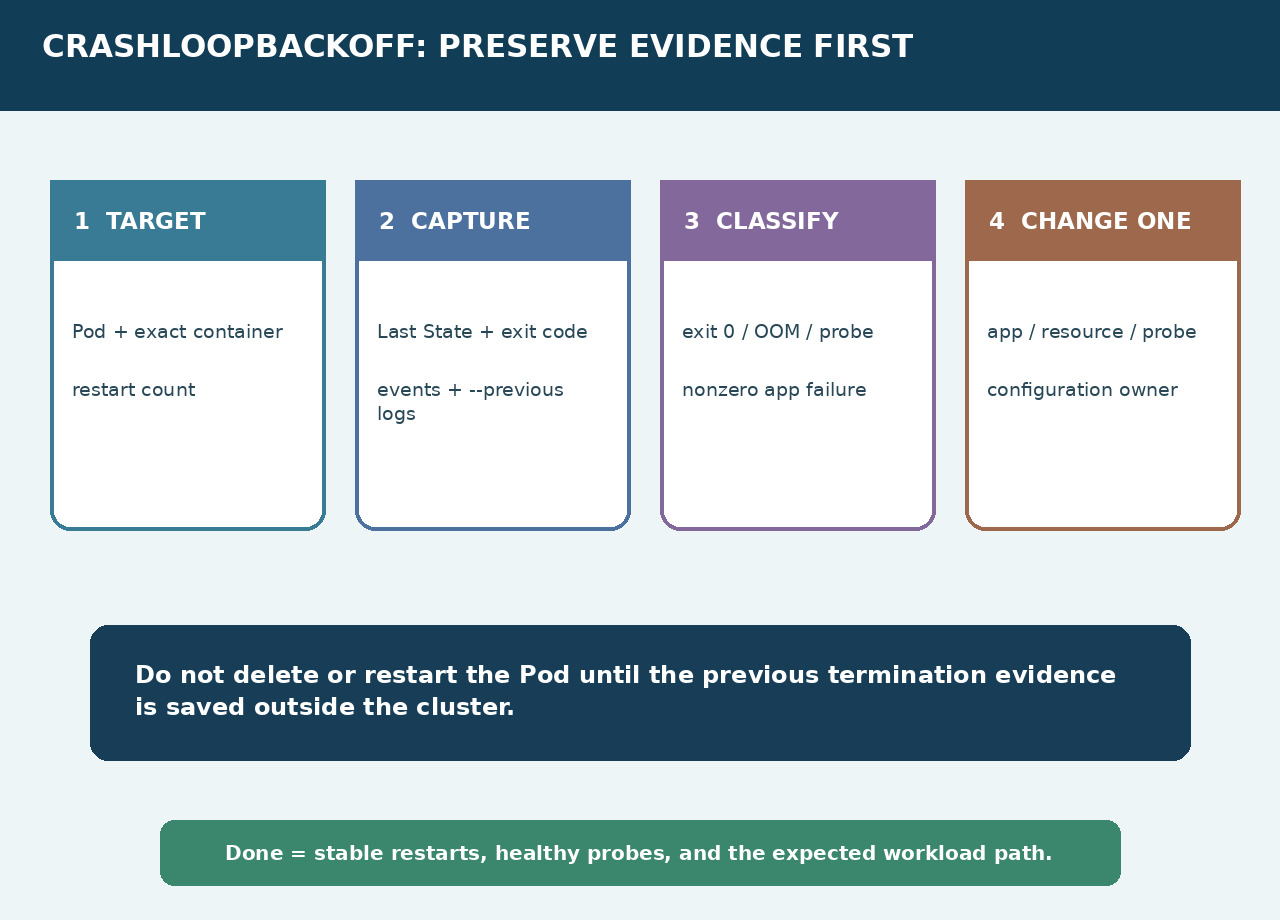
CrashLoopBackOff 是退避狀態,不是根因。刪除或重啟前,先保存正確容器、Last State、結束碼、事件與 previous logs。
Pod 顯示 CrashLoopBackOff,只代表某個 container 反覆終止,Kubernetes 正延遲下一次重啟;它尚未說明程序正常結束、記憶體不足、probe 失敗或應用程式崩潰。先保存上一個 instance,再讓終止證據決定下一位負責者。
凍結證據視窗
確認 namespace、Pod、正確 container 與所屬 controller,保存重啟次數與時間。對 Pod 執行 describe,記錄 container 狀態、Last State、原因、結束碼、開始與結束時間及近期事件;再保存指定 container 的 previous logs。必須在刪除、rollout restart 或人工修改前完成。
previous logs 為空時
先確認命令指向正確 container;sidecar 與 init container 各有獨立記錄。即使沒有應用日誌,也要讀取終止原因、結束碼與事件。檢查 termination-message 設定;權限允許時建立 debug copy,而不是修改唯一失敗樣本。平台留存可輔助,但不能取代證據包。
依終止訊號分流
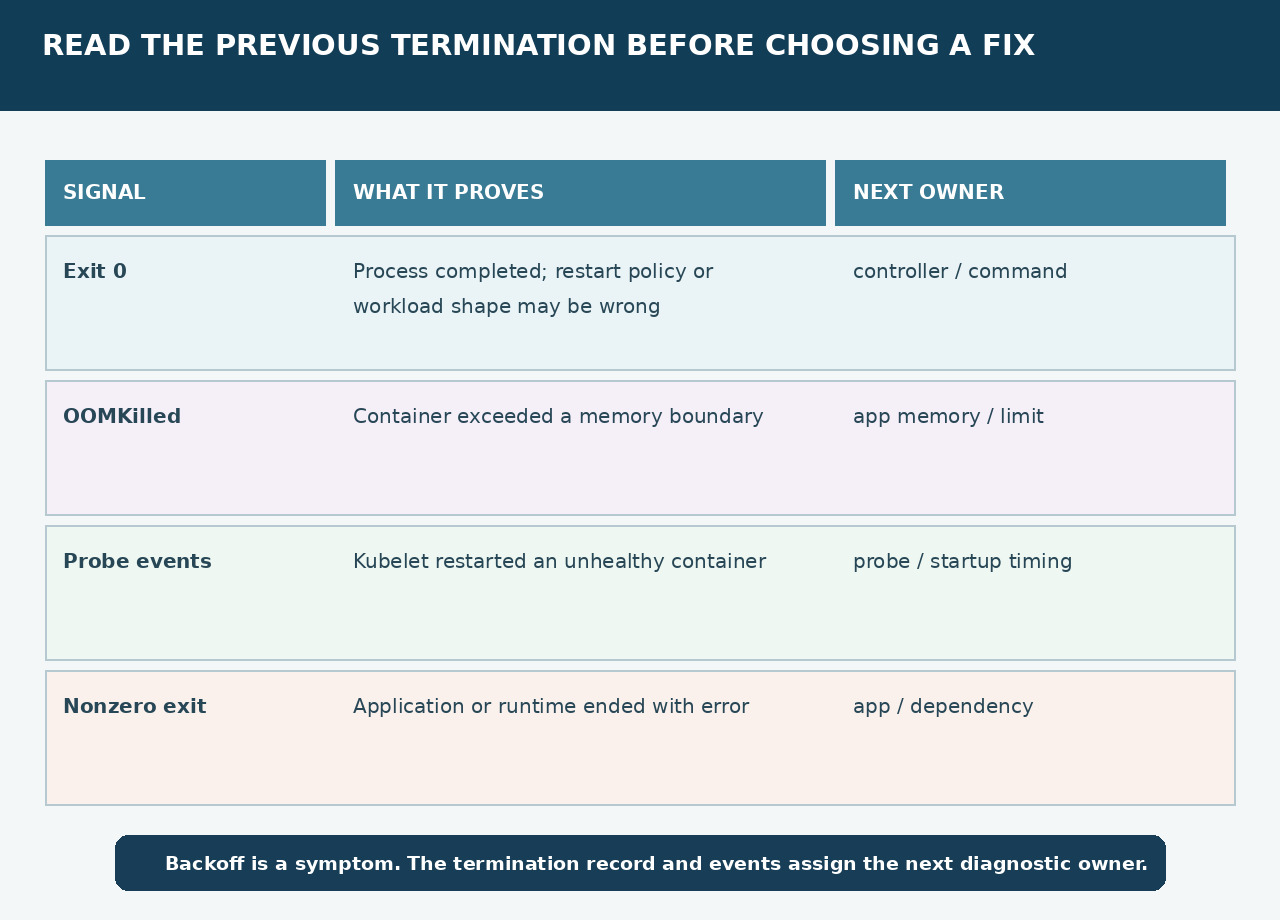
結束 0 常表示程序正常完成,卻位於預期持續執行的 workload 或 command。OOMKilled 先交給應用記憶體行為與 container limit。反覆 liveness 或 startup-probe 事件先查 probe 目標、時序與依賴就緒。帶 stack trace 的非零結束交給失敗程式碼或依賴。
不要混合原因家族
image pull、排程失敗與 admission error 是不同狀態。現在可讀日誌不會抹去上次終止;probe 症狀也不證明 probe 一定錯,程序可能真的不健康。寫清楚每份材料能證明什麼,並把假設與 exit、event、log 證據分開。
只改一個責任層並觀察完整視窗
只對已證實責任層做一次明確修改:command 或 controller 形態、記憶體行為或 limit、probe 設定,或應用/依賴故障。記錄 workload revision,並跨越預期 startup 與 probe 視窗觀察重啟次數、Last State 與事件。
以可重現證據收尾
只有預期 controller 執行正確 container、重啟次數不再增加、probe 持續健康且原工作路徑成功,事件才算結束。附上修改前證據包、單一修改、修改後視窗與 rollback 步驟;若證據指向其他團隊,就交付此證據包而非盲目重啟。