기술 · 실용 가이드
Kubernetes CrashLoopBackOff: Pod 재시작 전에 이전 종료 증거를 보존하세요
CrashLoopBackOff는 backoff 상태이지 근본 원인이 아닙니다. 삭제나 재시작 전에 정확한 container, Last State, exit code, event와 previous logs를 저장하세요.
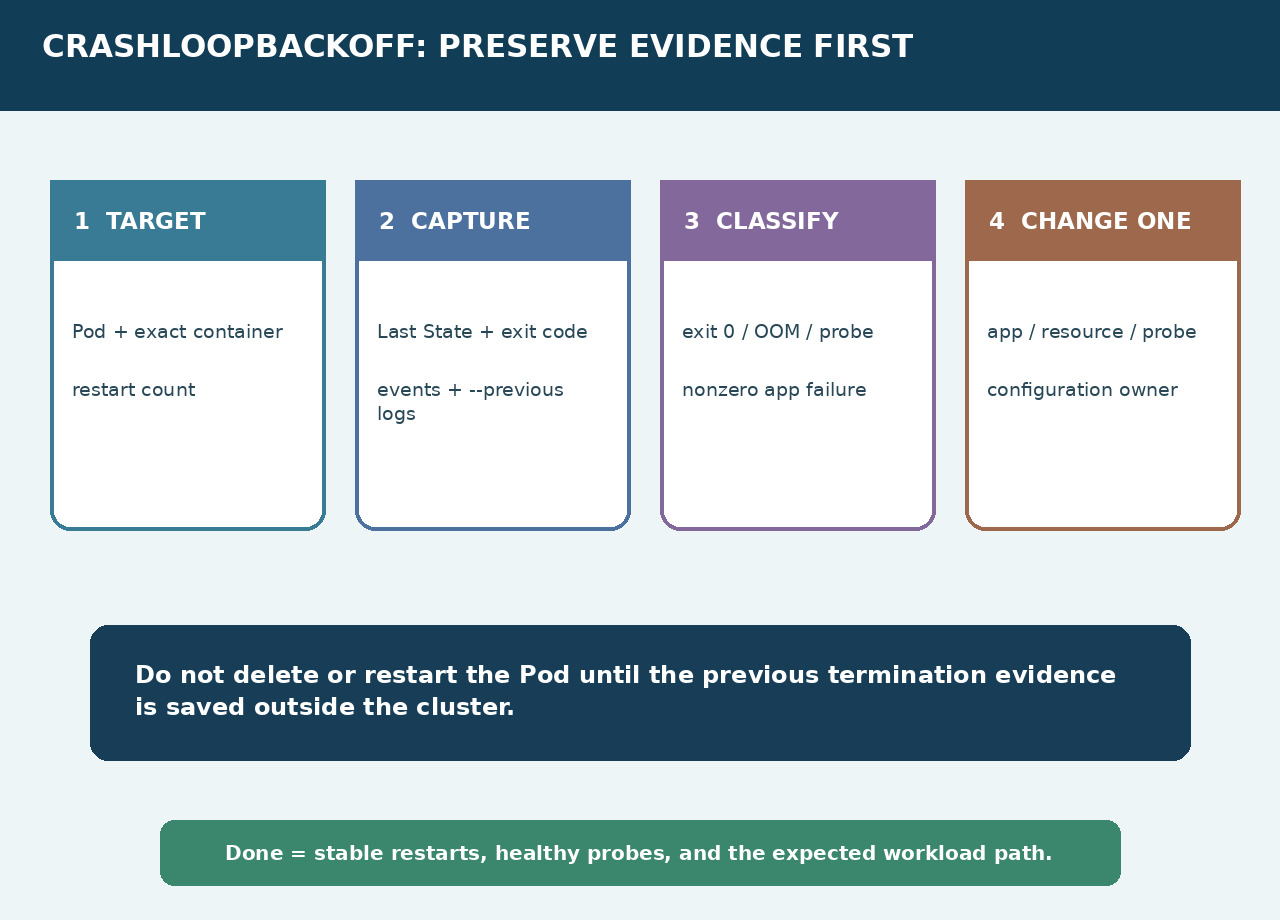
Pod의 CrashLoopBackOff는 container가 반복 종료되어 Kubernetes가 다음 재시작을 늦추고 있다는 뜻일 뿐입니다. 정상 종료, 메모리 부족, probe 실패, 애플리케이션 충돌 중 무엇인지는 아직 모릅니다. 이전 instance를 보존한 뒤 종료 증거가 다음 owner를 정하게 하세요.
증거 창을 고정한다
namespace, Pod, 정확한 container와 소유 controller를 식별하고 restart count와 시간을 저장합니다. Pod describe에서 container status, Last State, reason, exit code, 시작·종료 시간과 최근 event를 기록한 뒤 container별 previous logs를 저장합니다. 삭제나 rollout restart 전에 수행해야 합니다.
previous logs가 비어 있을 때
올바른 container를 지정했는지 확인하세요. sidecar와 init container는 별도 기록입니다. app log가 없어도 termination reason, exit code와 event를 읽습니다. termination-message 설정을 확인하고 허용된다면 유일한 실패 표본을 변경하지 말고 debug copy를 만드세요. provider 보관만 의존하지 않습니다.
종료 신호로 분기한다
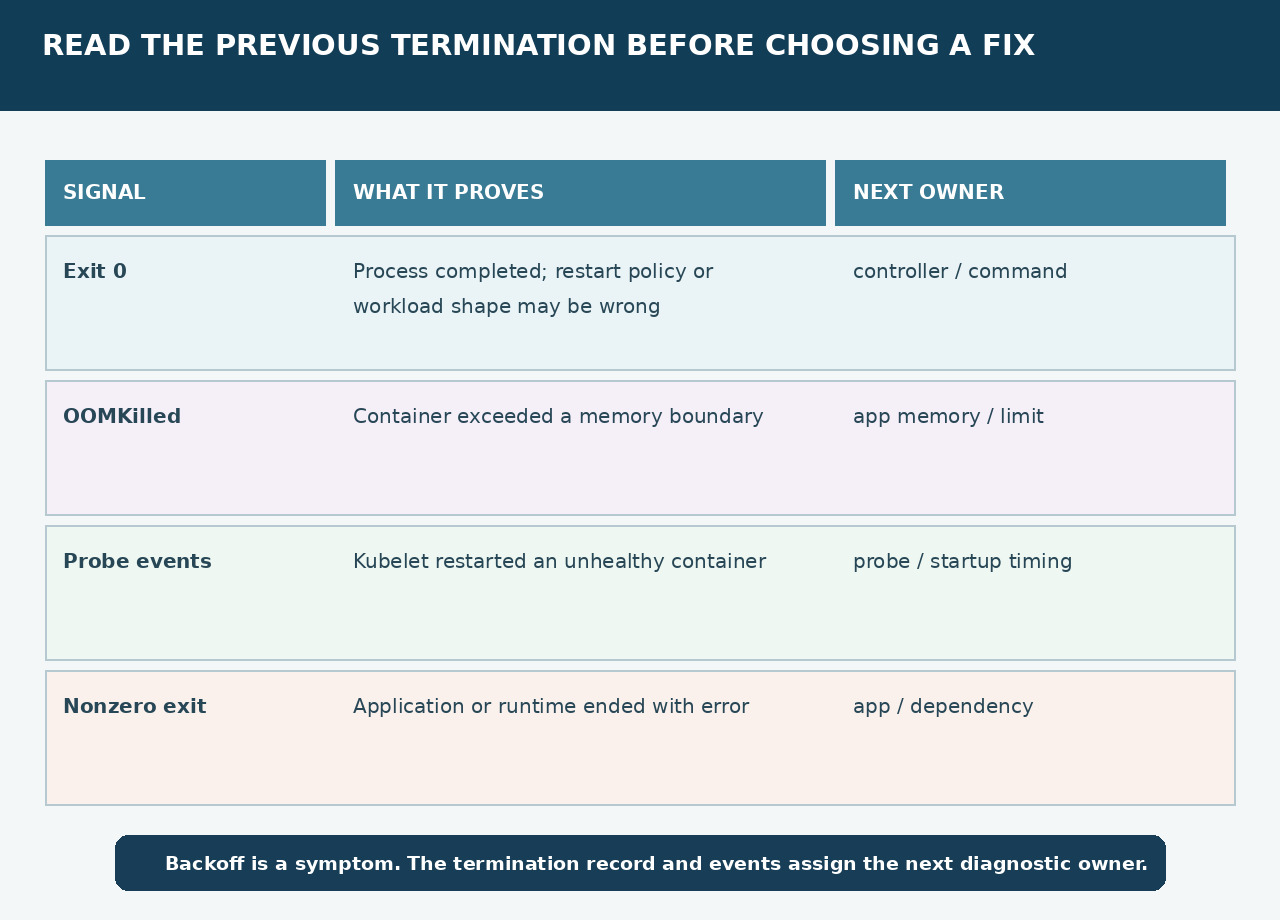
exit 0은 process가 정상 완료했지만 계속 실행되어야 하는 workload나 command에 배치됐을 수 있음을 뜻합니다. OOMKilled는 app memory와 limit가 첫 owner입니다. liveness/startup probe event는 target, timing과 dependency readiness를 확인합니다. app trace가 있는 nonzero exit는 code나 dependency owner로 갑니다.
원인 계열을 섞지 않는다
image pull, scheduling failure와 admission error는 다른 상태입니다. 현재 log가 보인다고 이전 종료가 사라지지 않으며, probe 증상이 probe 설정 오류를 증명하지도 않습니다. 각 artifact가 증명하는 사실을 쓰고 가설을 exit, event, log 관찰과 분리하세요.
한 owner만 변경하고 전체 창을 본다
command/controller 형태, memory/limit, probe 설정, app/dependency 실패 중 증거가 지목한 하나만 변경하고 workload revision을 기록합니다. 예상 startup과 probe window 전체에서 restart count, Last State와 event를 관찰해 잠깐의 정적을 복구로 오해하지 마세요.
재현 가능한 증거로 종료한다
예상 controller가 올바른 container를 실행하고 restart count가 늘지 않으며 probe가 건강하고 원래 workflow가 성공할 때만 종료합니다. 변경 전 bundle, 단일 변경, 변경 후 window와 rollback을 첨부하세요. 다른 owner라면 bundle을 전달하고 맹목적으로 재시작하지 않습니다.