Tecnología · GUÍA PRÁCTICA
¿Kubernetes muestra CrashLoopBackOff? Conserva la terminación anterior antes de reiniciar el Pod
CrashLoopBackOff es un estado de espera, no la causa raíz. Antes de borrar o reiniciar, guarda el contenedor exacto, Last State, código de salida, eventos y previous logs.
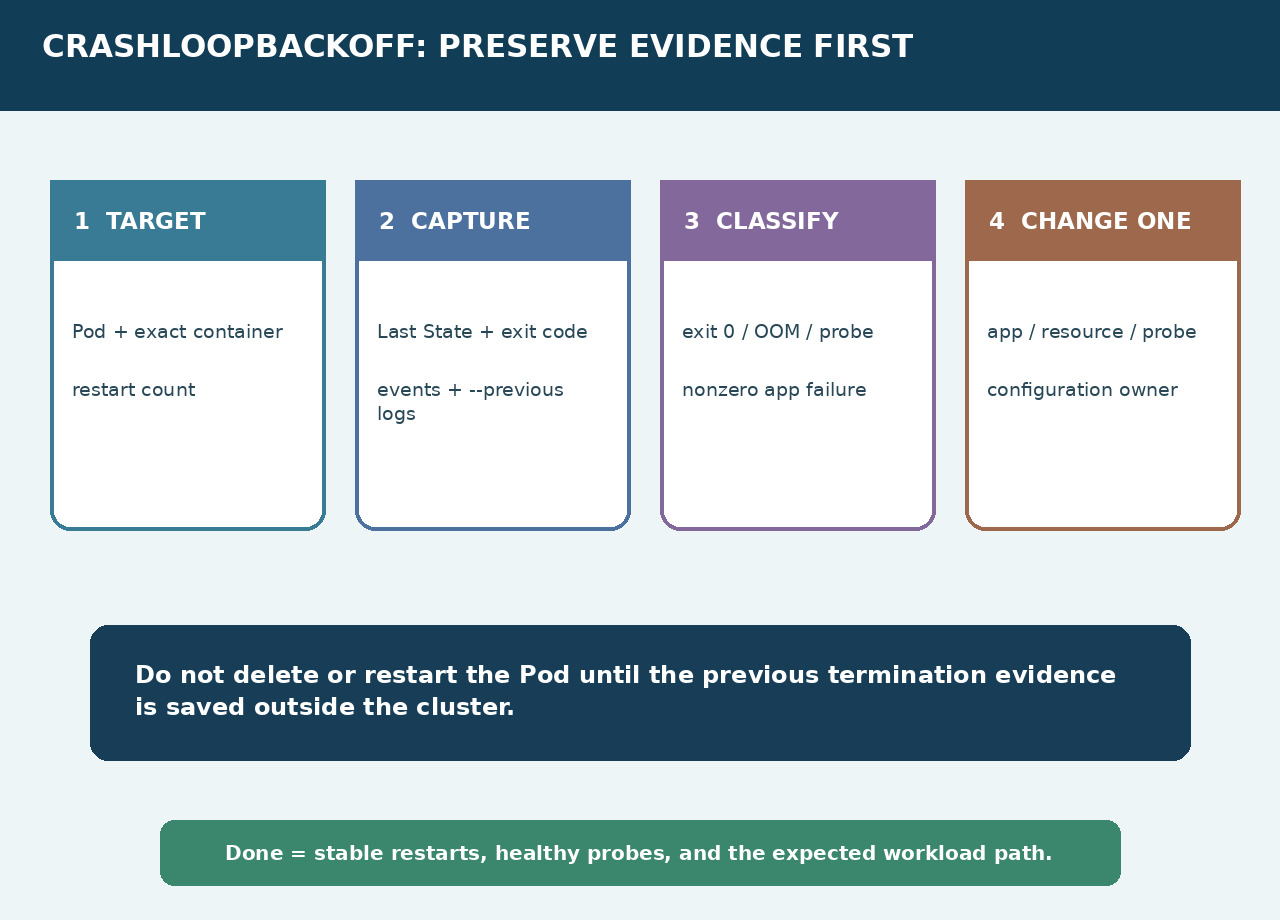
CrashLoopBackOff solo indica que un contenedor termina repetidamente y Kubernetes retrasa otro reinicio. Aún no dice si el proceso terminó bien, agotó memoria, falló una probe o chocó dentro de la aplicación. Conserva la instancia anterior y deja que la evidencia de terminación elija al siguiente responsable.
Congela la ventana de evidencia
Identifica namespace, Pod, contenedor exacto y controller propietario. Guarda el número de reinicios y la hora. Captura con describe el estado, Last State, razón, código de salida, horas de inicio y fin y eventos recientes. Después guarda los previous logs del contenedor. Hazlo antes de borrar, reiniciar un rollout o cambiarlo manualmente.
Si previous logs está vacío
Confirma que apuntas al contenedor correcto; sidecars e init containers tienen registros separados. Lee razón, código y eventos aunque no haya logs de aplicación. Revisa la ruta de termination-message y, si se permite, crea una copia de debug sin modificar el único ejemplar fallido. La retención del proveedor ayuda, pero no sustituye el paquete local.
Divide por la señal de terminación
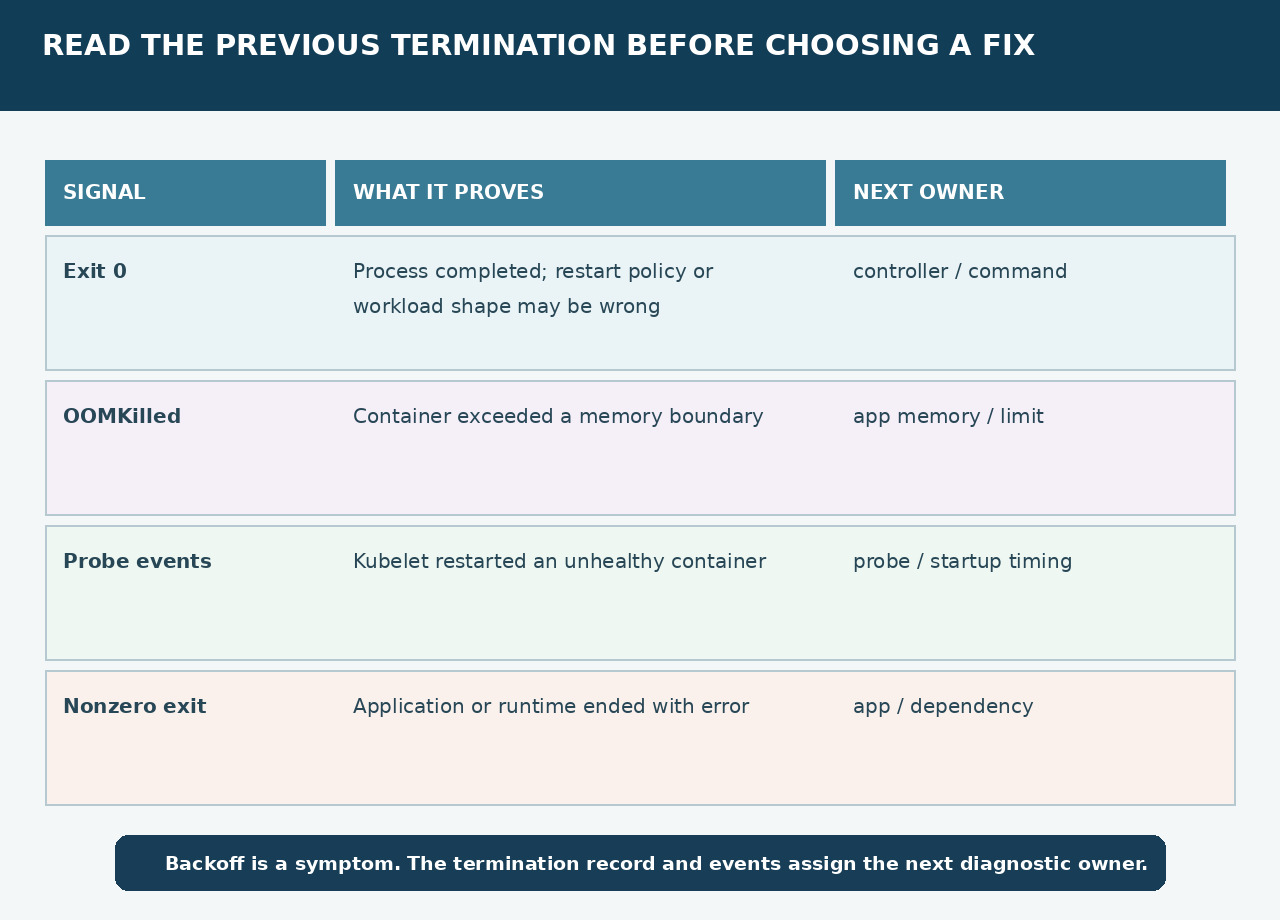
Exit 0 suele indicar que el proceso terminó correctamente pero está en un workload o comando que espera permanencia. OOMKilled asigna la primera revisión a memoria y limit. Eventos repetidos de liveness o startup probe apuntan a destino, tiempo y preparación de dependencias. Una salida no cero con traza apunta al código o dependencia.
No mezcles familias de causas
Image pulls, scheduling y errores de admission son estados distintos. Un log actual no borra la terminación anterior. Un síntoma de probe tampoco prueba que la probe esté mal: el proceso puede estar enfermo. Escribe qué demuestra cada artefacto y separa hipótesis de exit, event y log observados.
Cambia un dueño y observa toda la ventana
Aplica un cambio acotado al responsable demostrado: comando o controller, memoria o limit, configuración de probe, o fallo de aplicación/dependencia. Registra la revisión y observa restart count, Last State y eventos durante toda la ventana de arranque y probes para no confundir una pausa breve con recuperación.
Cierra con prueba reproducible
Solo termina cuando el controller previsto ejecuta el contenedor correcto, los reinicios dejan de aumentar, las probes siguen sanas y funciona el flujo original. Adjunta el paquete previo, el único cambio, la ventana posterior y rollback. Si la evidencia apunta a otro equipo, entrega el paquete exacto en vez de reiniciar a ciegas.