科技 · 实用指南
把 Joplin 的 HTML 导出拆成带附件、可独立阅读的笔记本
这套经过测试的 Linux 批处理流程,可将一份完整的 HTML 目录导出拆成独立的笔记本包,再检查缺失文件,以及仍依赖 Joplin 或其他笔记本的链接。
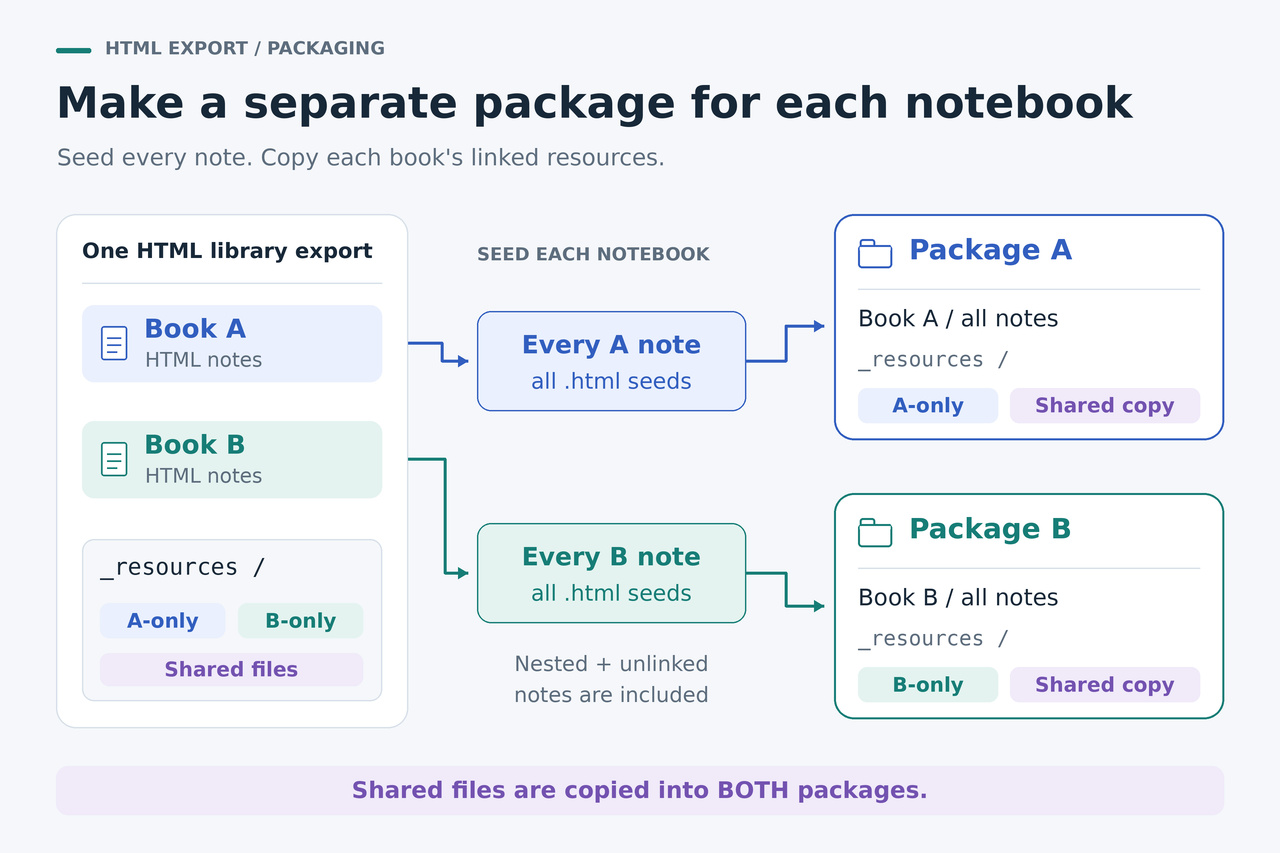
要从 Joplin 的 HTML 导出中单独移出一个笔记本,需要把其中的 HTML 笔记与它们实际引用的资源放在同一个包内。HTTrack 可以复制这些依赖文件,并改写本地链接。下面的批处理从一份保持完整的导出开始,列出每个顶层笔记本中的所有笔记,再为各笔记本建立独立的外层文件夹。
最后的检查与复制本身同样重要。在我们的测试中,HTTrack 虽然报告零错误,指向其他笔记本的链接却仍指向已经停止的本地服务器。复制完成后,还要核对笔记清单、检查附件,并生成明确的链接报告,才能判断这个包是否可以独立阅读。
先判断是否需要拆成独立的包
如果你只是想把整个归档移到另一块硬盘,保持整个导出目录完整即可。笔记本文件夹和共享的 _resources 目录可以作为一个整体移动。如果只有少量笔记本,逐本单独导出也可能更简单。
这套批处理流程适合这样的情况:你已经有一份大型 HTML 目录导出,并希望各个笔记本能够独立移动。2026 年的一则 Joplin 论坛讨论提到,用户有约 100 个笔记本,实际困难正是为每个笔记本重复手动导出。
这套流程保留导出的 HTML 阅读格式。如果你是为了导入另一款笔记应用,应考虑那款应用支持的格式,或 Jimmy 这样的转换工具。Joplin 文档将 JEX 描述为一种无损、可重新导入并保留笔记元数据的备份格式;请在原始导出之外,同时保留一份 JEX 备份。
从完整的桌面端导出开始
通过 Joplin 桌面应用的导出菜单,将所需笔记本导出为 HTML 目录。请选择会生成独立 HTML 文件和笔记本文件夹的选项。本指南核查的 v3.7.21 源码显示,Joplin 命令行应用不支持 HTML 导出。
导出前,先等待同步和附件下载完成。Joplin 的附件设置区分 Always(始终)、Auto(自动)和 Manual(手动):Auto 会在打开笔记时下载,Manual 则等待你明确执行下载。本次核查的 HTML 导出器会跳过尚未下载的、由 Joplin 管理的资源。打包无法补出源导出中缺失的数据。
在文件管理器中打开导出文件夹。对于这套流程,它的直接子项应为笔记本目录和共享的 _resources 目录;pluginAssets 可能位于笔记本目录内。嵌套笔记本会留在所属顶层笔记本的包内。保持这份导出完整,并把输出放在它的目录之外。
继续操作前,先打开有代表性的源 HTML 笔记及其附件,包括一篇嵌套层级较深的笔记,以及一个 PDF 或文档链接。如果笔记原本就链接到了错误位置,需要先修正源导出。普通文件系统链接、特殊的自定义 HTML 和插件生成的内容,可能需要另外处理;这套流程针对的是 Joplin 的常规导出布局。
1. 设置四个值并启动本地服务器
使用已安装 Python 3 和 HTTrack 命令行程序的 Linux Bash 终端。测试使用的 HTTrack 版本为 3.50-5;请从项目官方下载页 https://www.httrack.com/page/2/en/index.html 获取程序,并在运行前检查可执行文件的版本。以下命令采用 Bash 语法,尚未在 Windows 命令提示符、PowerShell 或 macOS 上测试。
在下一条命令中,将 EXPORT 替换为完整导出目录的绝对路径,将 HTTRACK 替换为可执行文件的绝对路径。将 OUT 设置为导出目录以外的一个新目录:该目录尚不存在,但它的父目录必须已经存在。在 OUT 路径后追加 -moved 所得到的路径也必须不存在。请选择一个未被占用的本地端口;示例使用 8765。
每个编号步骤中的命令都要作为一个不含换行的完整单行运行,并使用同一个 Bash 会话。保留直引号、反斜线和分号。第一条命令会创建输出目录,并启动一个仅绑定 127.0.0.1 的服务器。它不会把笔记上传到网站。
EXPORT="/absolute/path/to/html-export"; OUT="/absolute/path/to/new-notebook-bundles"; PORT=8765; HTTRACK="/absolute/path/to/httrack"; mkdir "$OUT" && { python3 -m http.server "$PORT" --bind 127.0.0.1 --directory "$EXPORT" >"$OUT/server.log" 2>&1 & HTTRACK_SERVER_PID=$!; printf "%s\n" "$HTTRACK_SERVER_PID" >"$OUT/server.pid"; sleep 1; kill -0 "$HTTRACK_SERVER_PID"; }
如果这条命令报错,请先停止,不要运行批处理。检查 OUT/server.log,修正路径或端口,然后使用一个全新的输出目录。保持终端会话打开:后续命令还会使用其中的变量,以及记录下来的服务器进程 ID。
2. 为每个顶层笔记本建立独立的包
这条命令会递归遍历每个笔记本,写出一个 .urls.txt 文件,列出每篇 HTML 笔记的 URL。它会对这些起始 URL 中的空格和非 ASCII 字符进行编码,将 pluginAssets 排除在笔记清单之外,然后对每个笔记本分别运行一次 HTTrack。
RESULT=0; for BOOK in "$EXPORT"/*/; do NAME=${BOOK%/}; NAME=${NAME##*/}; [ "$NAME" = "_resources" ] && continue; LIST="$OUT/$NAME.urls.txt"; python3 -c 'import pathlib,sys;from urllib.parse import quote;s=pathlib.Path(sys.argv[1]).resolve();b=pathlib.Path(sys.argv[2]).resolve();sys.stdout.write("".join("http://127.0.0.1:"+sys.argv[3]+"/"+quote(p.relative_to(s).as_posix(),safe="/")+"\n" for p in sorted(b.rglob("*.html")) if "pluginAssets" not in p.relative_to(b).parts))' "$EXPORT" "$BOOK" "$PORT" >"$LIST"; [ -s "$LIST" ] || continue; "$HTTRACK" --list "$LIST" -B -N0 -K0 -q "-*" "+127.0.0.1:$PORT/_resources/*" "+127.0.0.1:$PORT/*/pluginAssets/*" -O "$OUT/$NAME"; STATUS=$?; printf "%s: %s HTML seeds; HTTrack exit %s\n" "$NAME" "$(wc -l <"$LIST")" "$STATUS"; [ "$STATUS" -eq 0 ] || { RESULT=1; break; }; done; test "$RESULT" -eq 0
过滤规则先禁止常规抓取,再允许跟进 _resources 和 pluginAssets 中被引用的文件。共享的 _resources 目录不会被用作起始页面,因此这套批处理不会主动抓取它的整个目录列表。HTML 笔记之间不必互相链接,因为每一篇笔记都已明确列入 URL 清单。
等待命令执行结束,然后查看每个笔记本的起始 URL 数量和 HTTrack 退出状态。如果出现 Python traceback(异常回溯)、非零退出状态,或输出意外缺少某个笔记本,请停止。正常退出和零错误日志都是有用的检查,但都不能证明阅读所需的每项依赖已经齐全。
3. 停止服务器、移动输出并报告未解决的链接
下一条命令会停止本次会话的本地服务器,并在输出目录名称后追加 -moved。随后,它会扫描镜像中的 HTML 文件,并在移动后的输出目录顶层写入 link-report.json。重命名不会改动原始导出。
kill "$HTTRACK_SERVER_PID" && mv "$OUT" "$OUT-moved" && python3 -c 'exec("import pathlib,sys,json\nfrom html.parser import HTMLParser\nfrom urllib.parse import urlsplit,unquote\nr=pathlib.Path(sys.argv[1]).resolve()\nrows=[]\nchecked=0\nfor m in sorted(r.glob(\"*/127.0.0.1*\")):\n for f in sorted(m.rglob(\"*.html\")):\n links=[]\n p=HTMLParser()\n p.handle_starttag=lambda tag,attrs: links.extend(v for k,v in attrs if k in (\"href\",\"src\") and v)\n p.feed(f.read_text(encoding=\"utf-8\",errors=\"replace\"))\n for v in links:\n u=urlsplit(v)\n if u.scheme==\"joplin\" or u.hostname==\"127.0.0.1\":\n rows.append({\"file\":str(f.relative_to(r)),\"kind\":\"joplin\" if u.scheme==\"joplin\" else \"local-http\",\"url\":v})\n elif not u.scheme and not u.netloc and u.path:\n checked+=1\n t=(f.parent/unquote(u.path)).resolve()\n if not t.is_file() or m.resolve() not in t.parents:\n rows.append({\"file\":str(f.relative_to(r)),\"kind\":\"missing-or-outside-local\",\"url\":v})\nresult={\"checked_local_html_references\":checked,\"review\":rows}\ntext=json.dumps(result,ensure_ascii=False,indent=2)\n(r/\"link-report.json\").write_text(text,encoding=\"utf-8\")\nprint(text)\n")' "$OUT-moved"
报告会列出每个被标记项目所在的 HTML 文件、链接和原因。其中的 checked_local_html_references 数值,统计的是已检查的本地 HTML href/src 引用次数,不是笔记数、附件数,也不是全部依赖数。review 列表为空是一项有用证据,但不等于完成了整个归档的验证。
如果停止服务器或移动输出失败,不要假定后面的扫描已经执行。请先解决这一步的故障。新一轮运行不要复用旧目标目录:为 OUT 和 OUT-moved 选择新路径,避免旧镜像掩盖本次输出缺失。
确认包可用之前,先读懂报告
local-http 条目仍指向 127.0.0.1。它可能是一个有意留在本包之外的跨笔记本链接,也可能是没有捕获到的资源。打开报告中指出的源笔记,检查链接目标。如果必需的图片、样式表或附件仍使用本地服务器地址,就说明这个包还不完整。
joplin 条目是应用链接。笔记被复制后,这种链接不会自动变成普通的、可随 HTML 一同移动的链接。missing-or-outside-local 条目指向的本地文件,要么不存在,要么位于该包的镜像目录之外。在依赖这份副本之前,先查清这些条目。
如果被标记的链接只是用于跨笔记本跳转,请判断:记录下这一限制后,这份阅读副本是否仍满足需要。如果你需要这些链接正常工作,就应保持完整的原始导出在一起。这套流程不会把跨笔记本导航改写成一个新的合并笔记库,也不会修复原有的 joplin:// 链接。
自动扫描覆盖 HTML 中的 href 和 src。它不会检查 CSS 的 url() 依赖、脚本生成的请求、页面片段锚点、嵌入式应用行为,或所有其他 HTML 属性。还需要查看笔记的实际显示效果,并打开附件。
报告不会标记普通的外部 HTTP 或 HTTPS URL,包括 href 或 src 所引用的远程图片或样式表。抓取过滤规则会把这些远程资源留在包外。如果笔记依赖远程内容,请检查这些 URL,或在断开网络后打开已移动的副本进行验证,再判断这些内容能否离线使用。指向网站的普通链接,可以保留供联网时使用。
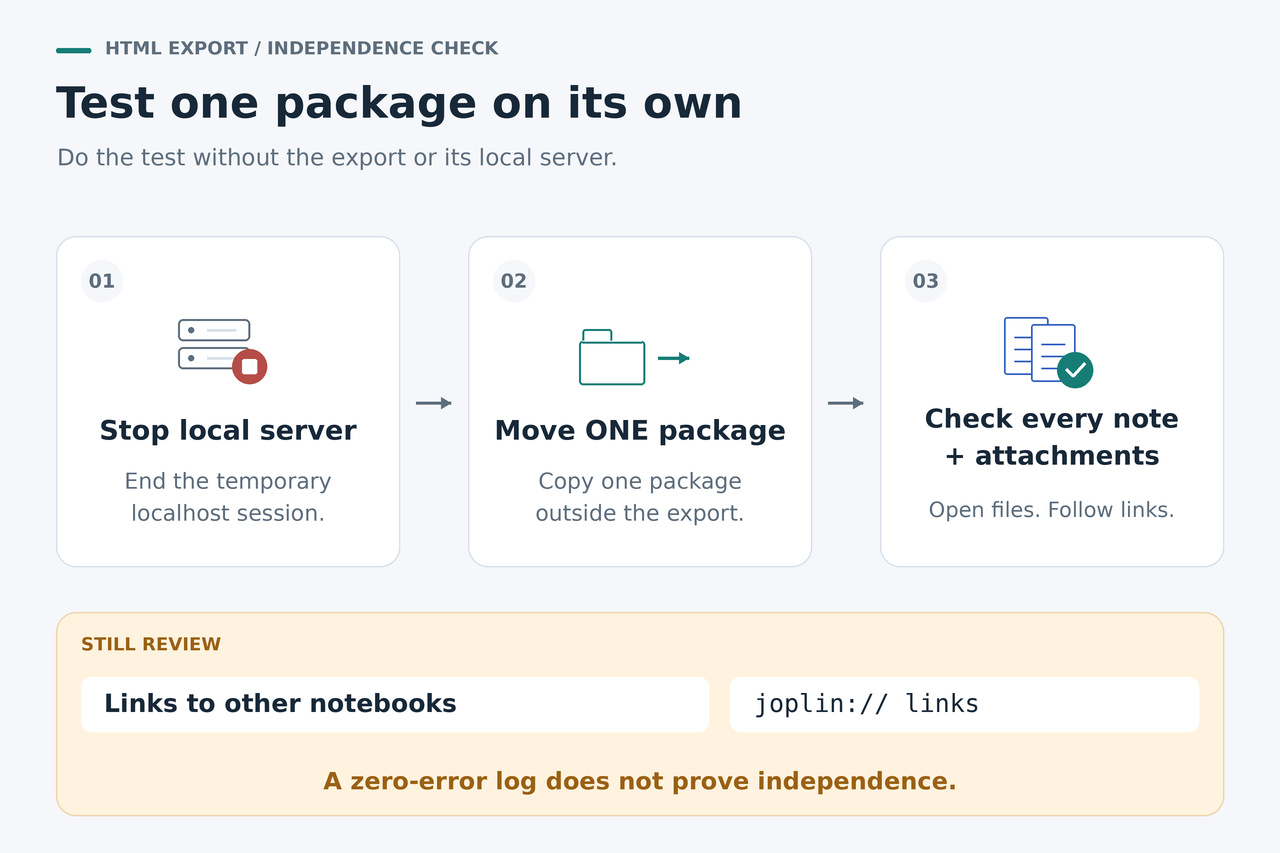
把一个包移到批处理目录以外进行验证
在 OUT-moved 下选择一个笔记本的外层文件夹,将整个文件夹复制到其他位置,例如另一块硬盘上的临时文件夹。HTTrack 会在其中建立一个以主机地址命名的目录,例如 127.0.0.1_8765,里面包含笔记本及其自己的 _resources。请把这个以主机地址命名的目录及其全部内容保持在一起。
将为该笔记本生成的 .urls.txt 清单,与镜像笔记本目录树中的 HTML 文件逐一对应。检查文件名和嵌套路径,不能只看总数,因为总数可能包含 HTTrack 自己生成的索引页。每篇预期笔记都应存在,包括没有其他笔记链接到它的笔记。对每个打算保留的包,都重复这项清单核对。
保持本地服务器停止,从已经单独移走的外层文件夹中打开笔记。打开一个 PDF 或文档附件,检查一张图片,再检查一篇嵌套笔记以及依赖插件资源的格式。对于重要的二进制附件,将副本文件的校验和与原始 _resources 目录中的对应文件进行比较;不要把使用附件文件名保存的错误页面当作复制成功。
共享附件应存在于每个引用它的笔记本包中。仅供另一个笔记本使用的文件,不应仅因两个笔记本来自同一份导出就出现在本包中。核对清楚笔记清单、必需附件和链接限制后,这个包才是一份独立的阅读副本。请保留原始完整导出和 JEX 备份。
测试了什么,还有什么需要你检查
我们在 Linux 上使用 Bash、Python 3 和 HTTrack 3.50-5 进行了测试。测试使用的是依据 Joplin v3.7.21 HTML 导出器目录结构构建的合成样本。这不是对 Joplin 桌面界面的端到端测试,也没有测试所有导出版本和插件。
最终批处理包含两个顶层笔记本,其中一个名称含空格和中文字符。预期的五篇 HTML 笔记全部复制成功,包括嵌套笔记,以及没有其他笔记链接到它的笔记。第一个包包含预期的 10 个全局资源和 4 个插件资源;第二个包包含预期的 4 个全局资源和 1 个插件资源。共享 PDF 和文档副本的字节内容与源文件一致,全部 24 个源文件都保持不变。
停止服务器并移动输出后,测试样本的验证器确认了 21 条有效的本地 HTML 和 CSS 引用。上面提供给读者使用的命令则单独检查了 18 条 HTML href/src 引用,并正确报告了两条跨笔记本的本地 HTTP 链接和两条 joplin:// 链接。两份 HTTrack 日志仍然都报告零错误。
较早的一版过滤规则包含经过编码的笔记本名称,却漏掉了名称含空格和中文字符的笔记本中的一份样式表。最终流程改为跟进标准资源目录,并将所有笔记明确列为起始 URL。因此,过滤规则和后续检查需要配合使用:复制结果、日志,以及成功打开的第一篇笔记,各自只能回答是否能够独立移动这一问题的一部分。