科技 · 实用指南
不启动编码,检查 HandBrake 队列的字幕标记
在已保存队列的检查表中区分字幕搜索请求与明确轨道,并保留 true、false 和未记录值的差别。
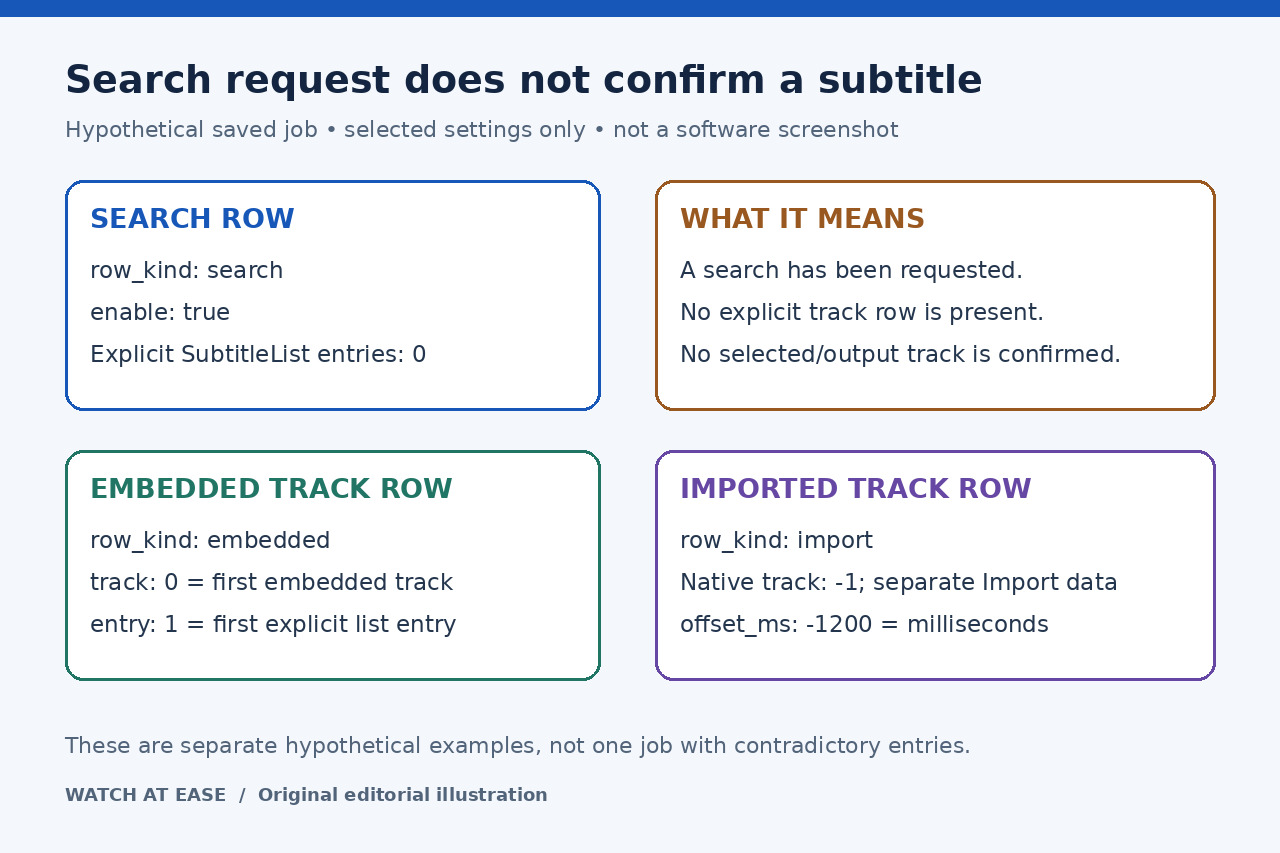
批量队列可能只有外语音频字幕搜索请求,没有任何明确字幕轨道。把两者当成一回事会误导检查:请求扫描,不代表已经确认选中了哪条字幕,也不代表它会出现在输出中。
HandBrake 已经支持在保存的预设中配置字幕选择行为,也支持逐项编辑队列。本指南补充对自己持有的受支持导出副本进行有限的离线 CSV 检查,不修复所谓原生缺陷、不改队列、不打开媒体,也不启动编码。
先取得正确的已保存导出
添加批量任务前,在预设中配置并保存 HandBrake 的字幕选择行为。预设保存的是选择行为,而不是一组手动指定的固定轨道。已有队列任务可用原生 Edit 功能修改,再将修改后的任务加入队列;逐项检查也是有效的内置方法。
本方法需要一份单独保存为 queue.json 的、受支持的 Windows 队列 CLI 用途导出副本。当前 Windows 源码生成包含 Job 的对象数组,其中有 Source、Destination 和 Subtitle 对象。普通 GUI 队列备份的结构不同,会被拒绝。CLI 导出排除已完成任务,但本表不显示任务状态,也不声称每个导出任务都在等待执行。
这是保存时的快照,不是实时队列监视器。要求 UTF-8 JSON、数组类型的 SubtitleList,以及类型符合支持范围的选定字段。缺少 Search 时按未记录处理;Search 明确为 null、旧式 SRT 结构或其他不支持的结构会被拒绝。其他平台的 GUI 导出与未来格式不在支持范围内。
创建检查表,避免覆盖文件
在有 Python 3 的 Linux Bash 终端中进入 queue.json 副本所在目录。将下面命令作为一整行复制,保留直引号和反斜杠。已存在 subtitles.csv 时会拒绝覆盖。此准确命令仅在 Linux Bash 执行过,没有在 Windows 或 macOS 执行。
转换器先解析并验证全部检查行,再创建 CSV。它拒绝重复 JSON 键、非标准数值、选定字段的错误类型,以及受支持结构中的无效形态。它不打开源媒体或导入字幕文件,也不检查未选入表中的设置:这是十七个选定字段的报告,不是完整编码配置验证。
python3 -c 'exec("import csv, json, sys\nfrom pathlib import Path\ndef pairs(items):\n d = {}\n for k, v in items:\n if k in d:\n raise ValueError('"'"'Duplicate JSON key'"'"')\n d[k] = v\n return d\ndef bad(value):\n raise ValueError('"'"'Nonstandard JSON number'"'"')\ndef obj(v):\n if not isinstance(v, dict):\n raise ValueError('"'"'Expected object'"'"')\n return v\ndef text(v):\n if v is None: return '"'"''"'"'\n if not isinstance(v, str): raise ValueError('"'"'Expected string'"'"')\n v.encode('"'"'utf-8'"'"')\n return v\ndef integer(v):\n if v is None: return '"'"''"'"'\n if type(v) is not int: raise ValueError('"'"'Expected integer'"'"')\n return str(v)\ndef flag(v):\n if v is None: return '"'"''"'"'\n if type(v) is not bool: raise ValueError('"'"'Expected Boolean'"'"')\n return '"'"'true'"'"' if v else '"'"'false'"'"'\nsrc, dst = map(Path, sys.argv[1:])\njobs = json.loads(src.read_bytes().decode('"'"'utf-8-sig'"'"'), object_pairs_hook=pairs, parse_constant=bad)\nif not isinstance(jobs, list): raise ValueError('"'"'Expected CLI queue array'"'"')\nrows = []\nfor n, wrapper in enumerate(jobs, 1):\n job = obj(obj(wrapper)['"'"'Job'"'"'])\n source, dest, sub = obj(job['"'"'Source'"'"']), obj(job['"'"'Destination'"'"']), obj(job['"'"'Subtitle'"'"'])\n title = source['"'"'Title'"'"']\n if type(title) is not int or title < 1: raise ValueError('"'"'Expected positive title index'"'"')\n base = [str(n), text(source['"'"'Path'"'"']), text(dest['"'"'File'"'"']), str(title)]\n search = obj(sub.get('"'"'Search'"'"', {}))\n rows.append(base + ['"'"'search'"'"', '"'"''"'"', '"'"''"'"', flag(search.get('"'"'Enable'"'"'))] + [flag(search.get(k)) for k in ['"'"'Burn'"'"', '"'"'Default'"'"', '"'"'Forced'"'"']] + ['"'"''"'"'] * 6)\n tracks = sub['"'"'SubtitleList'"'"']\n if not isinstance(tracks, list): raise ValueError('"'"'Expected subtitle list'"'"')\n for i, item in enumerate(tracks, 1):\n item = obj(item)\n if '"'"'SRT'"'"' in item: raise ValueError('"'"'Legacy SRT shape unsupported'"'"')\n imp = item.get('"'"'Import'"'"')\n if imp is None:\n track = item['"'"'Track'"'"']\n if type(track) is not int or track < 0: raise ValueError('"'"'Expected embedded track index'"'"')\n kind, imp = '"'"'embedded'"'"', {}\n else:\n kind, imp = '"'"'import'"'"', obj(imp)\n if not text(imp['"'"'Filename'"'"']): raise ValueError('"'"'Import filename missing'"'"')\n rows.append(base + [kind, str(i), integer(item.get('"'"'Track'"'"')), '"'"''"'"'] + [flag(item.get(k)) for k in ['"'"'Burn'"'"', '"'"'Default'"'"', '"'"'Forced'"'"']] + [integer(item.get('"'"'Offset'"'"'))] + [text(imp.get(k)) for k in ['"'"'Filename'"'"', '"'"'Language'"'"', '"'"'Codeset'"'"', '"'"'Format'"'"']] + [text(item.get('"'"'Name'"'"'))])\nheader = ['"'"'job'"'"', '"'"'source'"'"', '"'"'destination'"'"', '"'"'title'"'"', '"'"'row_kind'"'"', '"'"'entry'"'"', '"'"'track'"'"', '"'"'enable'"'"', '"'"'burn'"'"', '"'"'default'"'"', '"'"'forced'"'"', '"'"'offset_ms'"'"', '"'"'import_file'"'"', '"'"'import_language'"'"', '"'"'import_codeset'"'"', '"'"'import_format'"'"', '"'"'name'"'"']\nwith dst.open('"'"'x'"'"', encoding='"'"'utf-8-sig'"'"', newline='"'"''"'"') as f:\n w = csv.writer(f); w.writerow(header); w.writerows(rows)\nwith dst.open(encoding='"'"'utf-8-sig'"'"', newline='"'"''"'"') as f:\n if list(csv.reader(f)) != [header] + rows: raise ValueError('"'"'Readback mismatch; discard partial CSV'"'"')\nprint(len(jobs), '"'"'saved jobs and'"'"', len(rows), '"'"'report rows checked; not an encode result'"'"')\n")' "queue.json" "subtitles.csv"
分开阅读搜索行和明确轨道行
列名是 job、source、destination、title、row_kind、entry、track、enable、burn、default、forced、offset_ms、import_file、import_language、import_codeset、import_format 和 name。任务序号与明确轨道条目序号按保存顺序从 1 开始;重复任务保留。源路径、目标路径和名称是解析后的字符串,不扩展路径或检查文件是否存在。
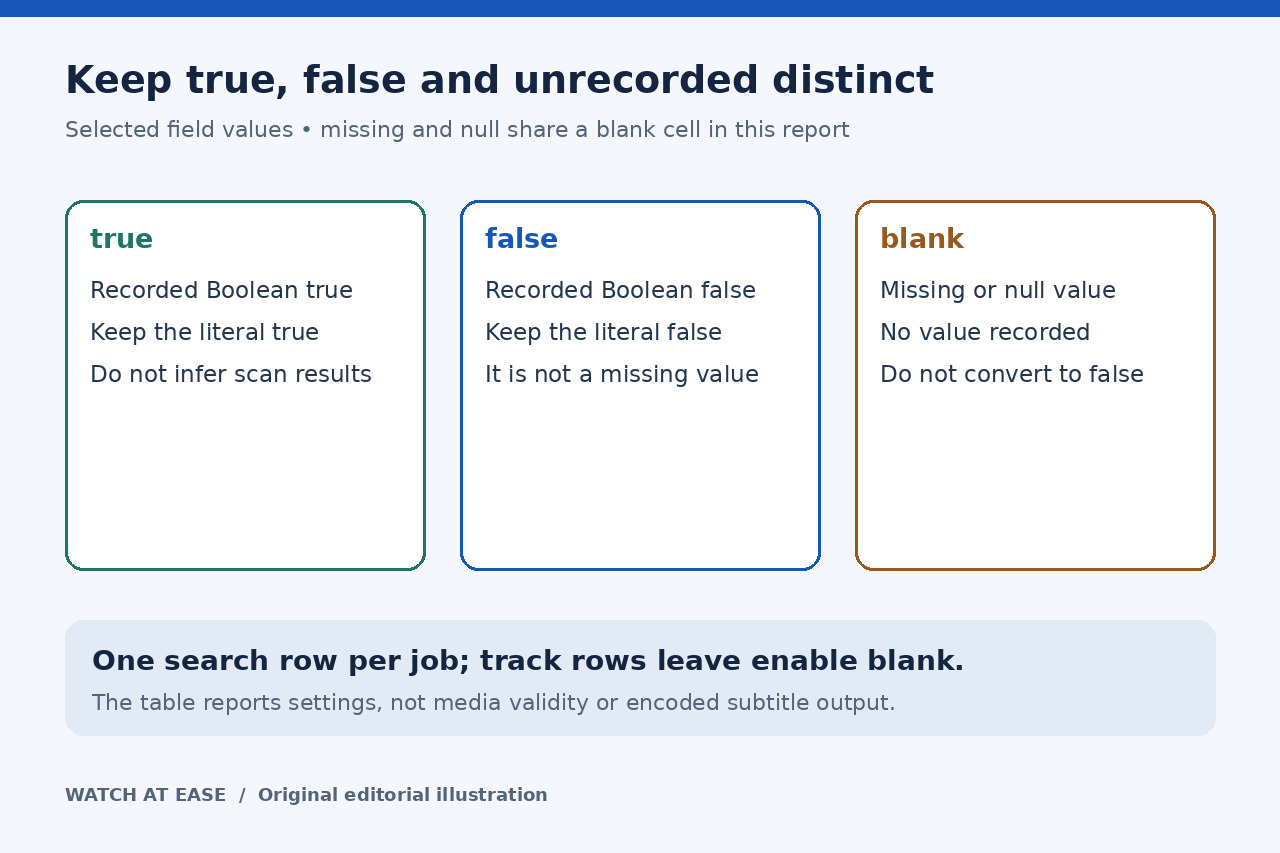
每个任务先有一条 row_kind 为 search 的行,记录 Search 标记,后面是 SubtitleList 明确条目的行。enable 为 true 表示请求搜索,不是已经确认的字幕选择。因此,启用搜索但明确列表为空,与没有配置搜索不同。布尔值输出为 true 或 false;选定字段缺失或为 null 时留空,表示没有记录值,绝不推断为 false。轨道行的 enable 留空,因为它是搜索字段。
内嵌 Track 索引从 0 开始:0 是有效的第一条轨道,不是缺失值。原生导入条目使用 Track -1 和独立的 Import 对象;检查表保留其原始文件名、语言、字符编码及格式,不读取字幕文件。Offset 是毫秒单位的整数,可以为负数,不是秒。标记或偏移值不能证明文件存在、语言符合预期,或字幕在输出容器中能正常播放。
批准批量任务前核对快照
命令在报告任务数与检查行数前,重新读取 CSV 并比较表头及每个字段。确认每个导出任务恰有一条搜索行,再把已知内嵌与导入条目和原生队列对照。统计 CSV 记录,不要统计文本物理行:引号包围的字段可能含换行。空导出仅生成表头。保留原始 JSON 和 CSV 母本,只在工作副本中编辑或筛选。
在 LibreOffice Calc 中按 UTF-8、逗号分隔及直双引号文本限定符导入。将十七列全部设为文本,关闭合并分隔符、删除空格和计算公式。若对话框隐藏,启用编辑筛选器设置。我们没有运行 Calc 界面。要修改任务,应在 HandBrake 中修改、重新导出快照,再用新文件名生成报告;编辑 CSV 不会更新队列,它也不是导入文件。
此命令实际执行了 26 个合成用例:七个有效用例覆盖空列表、没有明确轨道的搜索、Track 0、导入 Track -1、负偏移、缺失或 null 字段、Unicode、引号、换行及重复任务顺序;十九个无效用例在创建 CSV 前停止。另外七次覆盖尝试被拒绝,输入与已有输出的字节保持不变。没有测试真实 HandBrake GUI、队列导出或编码。写入或回读失败时,丢弃部分 CSV,换新文件名重试。依赖整夜批量编码前,应另行验证自己有权使用的短片试编码及播放;本表不能证明扫描结果或输出字幕。