기술 · 실용 가이드
인코딩을 시작하지 않고 HandBrake 대기열의 자막 플래그 확인하기
저장된 대기열 보고서에서 자막 검색 요청과 명시적 트랙을 구분하고 true, false, 미기록 값의 차이를 남깁니다.
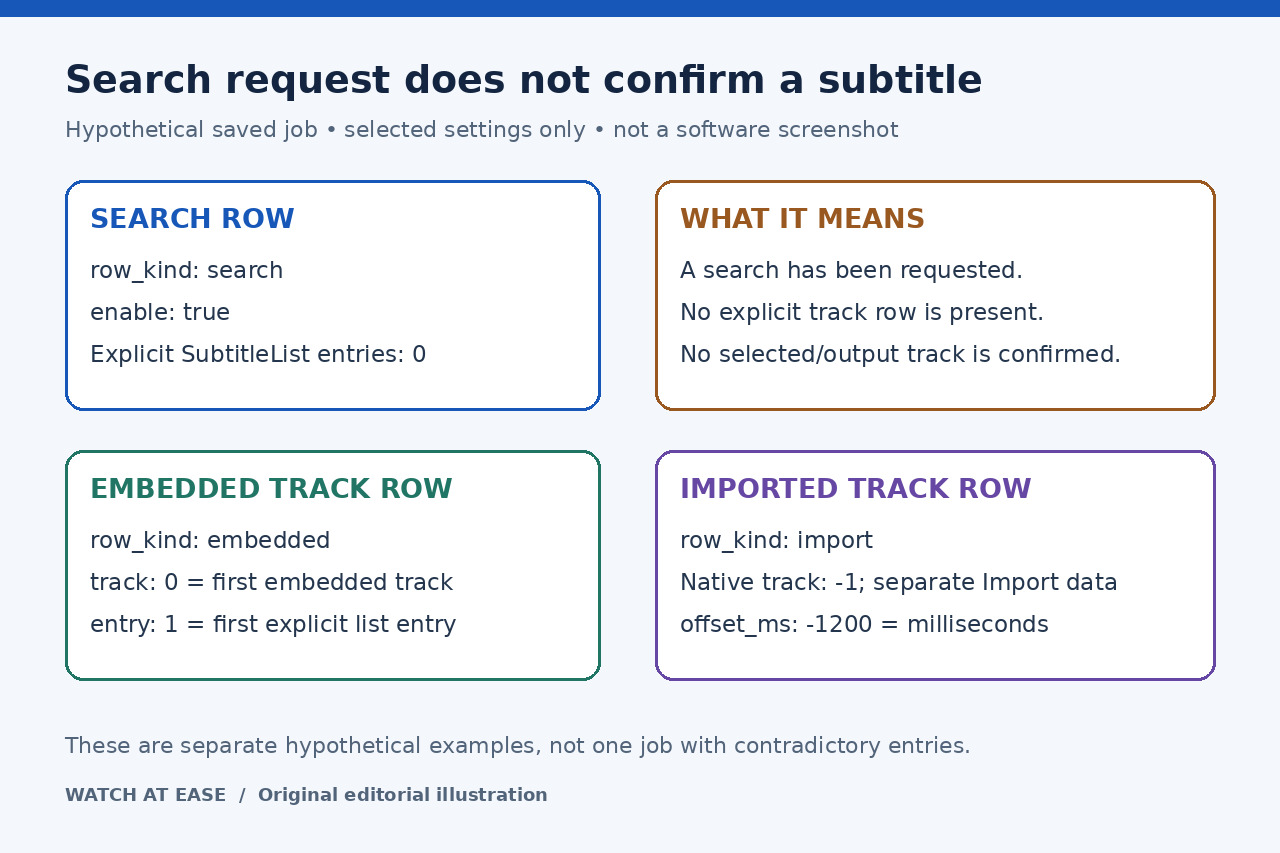
일괄 대기열에는 명시적인 자막 트랙 없이 외국어 음성 자막 검색 요청만 있을 수 있습니다. 둘을 같게 취급하면 확인을 잘못할 수 있습니다. 스캔 요청은 어떤 자막이 선택되거나 결과물에 나타날지 확인한 것이 아닙니다.
HandBrake는 저장한 프리셋의 자막 선택 동작과 작업별 대기열 편집을 이미 제공합니다. 이 가이드는 자신이 보유한 지원되는 내보내기 복사본에서 선택된 설정을 제한된 오프라인 CSV로 확인합니다. 프로그램 결함을 고치거나 대기열을 변경하거나 미디어를 열거나 인코딩을 시작하지 않습니다.
올바른 저장 내보내기 준비하기
일괄 작업을 추가하기 전에 프리셋에서 HandBrake의 자막 선택 동작을 설정하고 저장하세요. 프리셋은 수동으로 고른 고정 트랙 목록 대신 선택 동작을 저장합니다. 이미 추가한 작업은 기본 Edit 기능으로 수정한 뒤 다시 추가합니다. 작업별 검토도 유효한 기본 방법입니다.
이 방법은 지원되는 Windows 대기열 CLI용 내보내기를 별도로 queue.json으로 보관한 복사본을 사용합니다. 현재 Windows 소스는 Source, Destination, Subtitle 객체가 있는 Job을 포함한 객체 배열을 만듭니다. 일반 GUI 대기열 백업은 구조가 달라 거부됩니다. CLI용 내보내기는 완료 작업을 제외하지만 이 표는 작업 상태를 보여 주거나 모든 내보낸 작업이 대기 중이라고 주장하지 않습니다.
저장 시점의 스냅샷이며 실시간 대기열 감시가 아닙니다. UTF-8 JSON, 배열인 SubtitleList, 지원되는 타입의 선택 필드가 필요합니다. Search가 없으면 미기록으로 허용하지만 명시적 null Search 객체, 이전 SRT 구조나 지원되지 않는 형태는 거부합니다. 다른 플랫폼의 GUI 내보내기와 미래 형식은 대상이 아닙니다.
덮어쓰지 않고 보고서 만들기
Python 3가 있는 Linux Bash 터미널에서 queue.json 복사본 폴더를 여세요. 다음 명령을 한 줄로 복사하며 곧은 따옴표와 역슬래시를 보존합니다. 기존 subtitles.csv는 덮어쓰지 않고 거부합니다. 이 정확한 명령은 Linux Bash에서만 실행했고 Windows나 macOS에서는 실행하지 않았습니다.
변환기는 모든 보고서 행을 파싱하고 검증한 뒤 CSV를 만듭니다. 중복 JSON 키, 비표준 숫자, 선택 필드의 잘못된 타입과 지원 구조의 잘못된 형태를 거부합니다. 원본 미디어나 가져오기 자막 파일을 열지 않습니다. 알 수 없는 설정을 검사하는 것이 아니라 선택한 열일곱 필드의 보고서이며 전체 인코딩 설정 검증이 아닙니다.
python3 -c 'exec("import csv, json, sys\nfrom pathlib import Path\ndef pairs(items):\n d = {}\n for k, v in items:\n if k in d:\n raise ValueError('"'"'Duplicate JSON key'"'"')\n d[k] = v\n return d\ndef bad(value):\n raise ValueError('"'"'Nonstandard JSON number'"'"')\ndef obj(v):\n if not isinstance(v, dict):\n raise ValueError('"'"'Expected object'"'"')\n return v\ndef text(v):\n if v is None: return '"'"''"'"'\n if not isinstance(v, str): raise ValueError('"'"'Expected string'"'"')\n v.encode('"'"'utf-8'"'"')\n return v\ndef integer(v):\n if v is None: return '"'"''"'"'\n if type(v) is not int: raise ValueError('"'"'Expected integer'"'"')\n return str(v)\ndef flag(v):\n if v is None: return '"'"''"'"'\n if type(v) is not bool: raise ValueError('"'"'Expected Boolean'"'"')\n return '"'"'true'"'"' if v else '"'"'false'"'"'\nsrc, dst = map(Path, sys.argv[1:])\njobs = json.loads(src.read_bytes().decode('"'"'utf-8-sig'"'"'), object_pairs_hook=pairs, parse_constant=bad)\nif not isinstance(jobs, list): raise ValueError('"'"'Expected CLI queue array'"'"')\nrows = []\nfor n, wrapper in enumerate(jobs, 1):\n job = obj(obj(wrapper)['"'"'Job'"'"'])\n source, dest, sub = obj(job['"'"'Source'"'"']), obj(job['"'"'Destination'"'"']), obj(job['"'"'Subtitle'"'"'])\n title = source['"'"'Title'"'"']\n if type(title) is not int or title < 1: raise ValueError('"'"'Expected positive title index'"'"')\n base = [str(n), text(source['"'"'Path'"'"']), text(dest['"'"'File'"'"']), str(title)]\n search = obj(sub.get('"'"'Search'"'"', {}))\n rows.append(base + ['"'"'search'"'"', '"'"''"'"', '"'"''"'"', flag(search.get('"'"'Enable'"'"'))] + [flag(search.get(k)) for k in ['"'"'Burn'"'"', '"'"'Default'"'"', '"'"'Forced'"'"']] + ['"'"''"'"'] * 6)\n tracks = sub['"'"'SubtitleList'"'"']\n if not isinstance(tracks, list): raise ValueError('"'"'Expected subtitle list'"'"')\n for i, item in enumerate(tracks, 1):\n item = obj(item)\n if '"'"'SRT'"'"' in item: raise ValueError('"'"'Legacy SRT shape unsupported'"'"')\n imp = item.get('"'"'Import'"'"')\n if imp is None:\n track = item['"'"'Track'"'"']\n if type(track) is not int or track < 0: raise ValueError('"'"'Expected embedded track index'"'"')\n kind, imp = '"'"'embedded'"'"', {}\n else:\n kind, imp = '"'"'import'"'"', obj(imp)\n if not text(imp['"'"'Filename'"'"']): raise ValueError('"'"'Import filename missing'"'"')\n rows.append(base + [kind, str(i), integer(item.get('"'"'Track'"'"')), '"'"''"'"'] + [flag(item.get(k)) for k in ['"'"'Burn'"'"', '"'"'Default'"'"', '"'"'Forced'"'"']] + [integer(item.get('"'"'Offset'"'"'))] + [text(imp.get(k)) for k in ['"'"'Filename'"'"', '"'"'Language'"'"', '"'"'Codeset'"'"', '"'"'Format'"'"']] + [text(item.get('"'"'Name'"'"'))])\nheader = ['"'"'job'"'"', '"'"'source'"'"', '"'"'destination'"'"', '"'"'title'"'"', '"'"'row_kind'"'"', '"'"'entry'"'"', '"'"'track'"'"', '"'"'enable'"'"', '"'"'burn'"'"', '"'"'default'"'"', '"'"'forced'"'"', '"'"'offset_ms'"'"', '"'"'import_file'"'"', '"'"'import_language'"'"', '"'"'import_codeset'"'"', '"'"'import_format'"'"', '"'"'name'"'"']\nwith dst.open('"'"'x'"'"', encoding='"'"'utf-8-sig'"'"', newline='"'"''"'"') as f:\n w = csv.writer(f); w.writerow(header); w.writerows(rows)\nwith dst.open(encoding='"'"'utf-8-sig'"'"', newline='"'"''"'"') as f:\n if list(csv.reader(f)) != [header] + rows: raise ValueError('"'"'Readback mismatch; discard partial CSV'"'"')\nprint(len(jobs), '"'"'saved jobs and'"'"', len(rows), '"'"'report rows checked; not an encode result'"'"')\n")' "queue.json" "subtitles.csv"
검색 행과 명시적 트랙 행을 따로 읽기
열은 job, source, destination, title, row_kind, entry, track, enable, burn, default, forced, offset_ms, import_file, import_language, import_codeset, import_format, name입니다. 작업과 명시적 항목 번호는 저장 순서대로 1부터 시작하며 반복 작업도 남깁니다. 원본 경로, 대상 경로와 이름은 파싱된 문자열로, 경로 확장이나 파일 존재 확인은 하지 않습니다.
작업마다 Search 플래그를 담은 row_kind search 행 하나가 있고, 뒤에 SubtitleList의 명시적 항목 행이 옵니다. enable true는 검색 요청이지 확인된 자막 선택이 아닙니다. 따라서 검색을 켠 빈 명시 목록은 검색을 설정하지 않은 상태와 다릅니다. 불리언은 true 또는 false로 쓰며 누락되거나 null인 선택 필드 값은 빈칸으로 남깁니다. 미기록을 의미하며 false로 추정하지 않습니다. 트랙 행의 enable은 검색 필드이므로 비웁니다.
내장 Track 인덱스는 0부터 시작하며 0은 유효한 첫 트랙입니다. 기본 가져오기 항목은 Track -1과 별도 Import 객체를 사용합니다. 원래 파일 이름, 언어, 문자 인코딩과 형식을 기록하지만 자막 파일을 조사하지 않습니다. Offset은 음수도 가능한 밀리초 단위 정수이며 초가 아닙니다. 플래그나 오프셋만으로 파일 존재, 의도한 언어와의 일치나 출력 컨테이너에서의 정상 재생을 증명할 수 없습니다.
일괄 작업 승인 전에 스냅샷 대조하기
명령은 작업 수와 보고서 행 수를 표시하기 전에 CSV를 다시 읽어 헤더와 모든 필드를 비교합니다. 내보낸 작업마다 검색 행이 정확히 하나인지 확인한 뒤 알려진 내장 및 가져오기 항목을 기본 대기열과 비교하세요. 따옴표로 감싼 필드에는 줄바꿈이 있을 수 있으므로 실제 텍스트 줄이 아닌 CSV 레코드를 세세요. 빈 내보내기는 헤더만 만듭니다. 원본 JSON과 CSV 마스터를 보관하고 작업 복사본에서만 편집하거나 필터링합니다.
LibreOffice Calc에서 UTF-8, 쉼표 구분과 곧은 큰따옴표 문자열 구분으로 가져옵니다. 열일곱 열 모두 텍스트로 설정하고 구분자 병합, 공백 제거와 수식 평가를 끕니다. 창이 숨겨지면 필터 설정 편집을 켜세요. Calc 인터페이스는 실행하지 않았습니다. 변경은 HandBrake에서 하고 새 스냅샷을 내보내 새 이름의 보고서를 만드세요. CSV 편집은 대기열을 업데이트하지 않으며 이 표는 가져오기 파일도 아닙니다.
이 정확한 명령으로 합성 사례 26개를 실행했습니다. 정상 일곱 사례는 빈 목록, 명시 트랙 없는 검색, Track 0, 가져오기 Track -1, 음수 오프셋, 누락과 null, Unicode, 따옴표, 줄바꿈, 반복 작업 순서를 포함합니다. 잘못된 열아홉 사례는 CSV 생성 전에 멈췄습니다. 추가 덮어쓰기 일곱 번을 거부하고 입력과 기존 출력 바이트가 불변임을 확인했습니다. 실제 HandBrake GUI, 대기열 내보내기나 인코딩은 검사하지 않았습니다. 쓰기나 다시 읽기가 실패하면 부분 CSV를 버리고 새 이름으로 재시도하세요. 밤새 처리에 의존하기 전에 사용할 권한이 있는 짧은 소재의 시험 인코딩과 재생을 별도로 확인하세요. 이 표는 스캔 결과나 출력 자막을 증명하지 않습니다.