科技 · 实用指南
Gzip 提示“unexpected end of file”?再次解压前先证明字节来源
EOF 可能来自下载截断、流中断,也可能只是把分片误当成完整归档。先保存并验证原始字节,再修复真正失败的传输或拼接环节。
“gzip: unexpected end of file”只说明解压器遇到字节流提前结束,并不直接说明原因。换着 tar 参数重复运行无法补回从未到达的数据;即使已经解出少量文件,也不能证明部分归档可信。
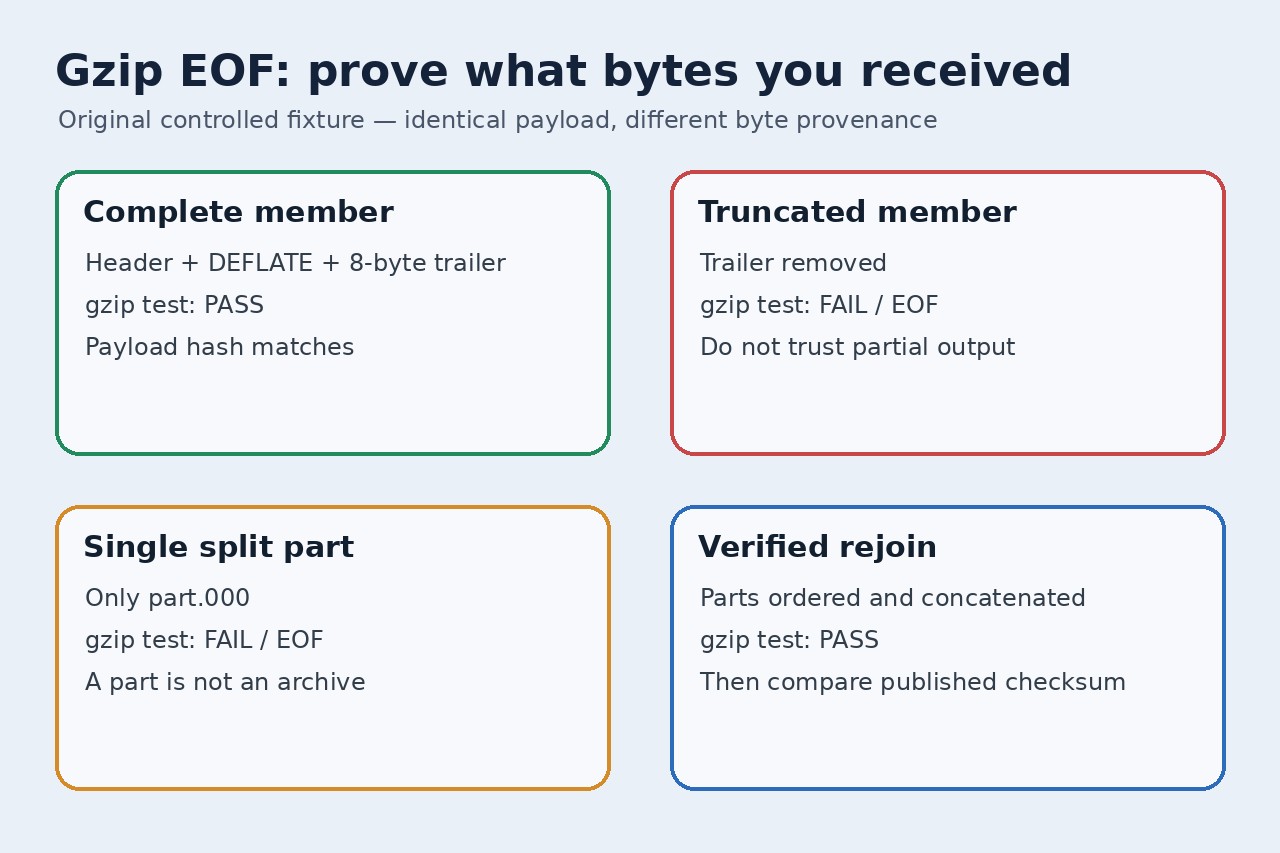
我们用 151,552 字节确定性载荷生成了一个 gzip 成员。完整的 514 字节成员可解压;删掉末尾八字节 trailer 后出现 EOFError。第一个 257 字节分片同样出现 EOFError,第二个分片单独读取则不是 gzip 头。按顺序拼回两个分片后,514 字节文件的 SHA-256 与原始成员完全一致,解压载荷哈希也一致。
该受控测试用于支持诊断顺序,不是恢复保证。未知文件还可能中段损坏、由变化的 URL 返回、生成未完成、由多个合法成员串接,或外面再套一层格式。请保存失败字节,并尽量取得发布者提供的校验和或大小。
重试前冻结失败证据
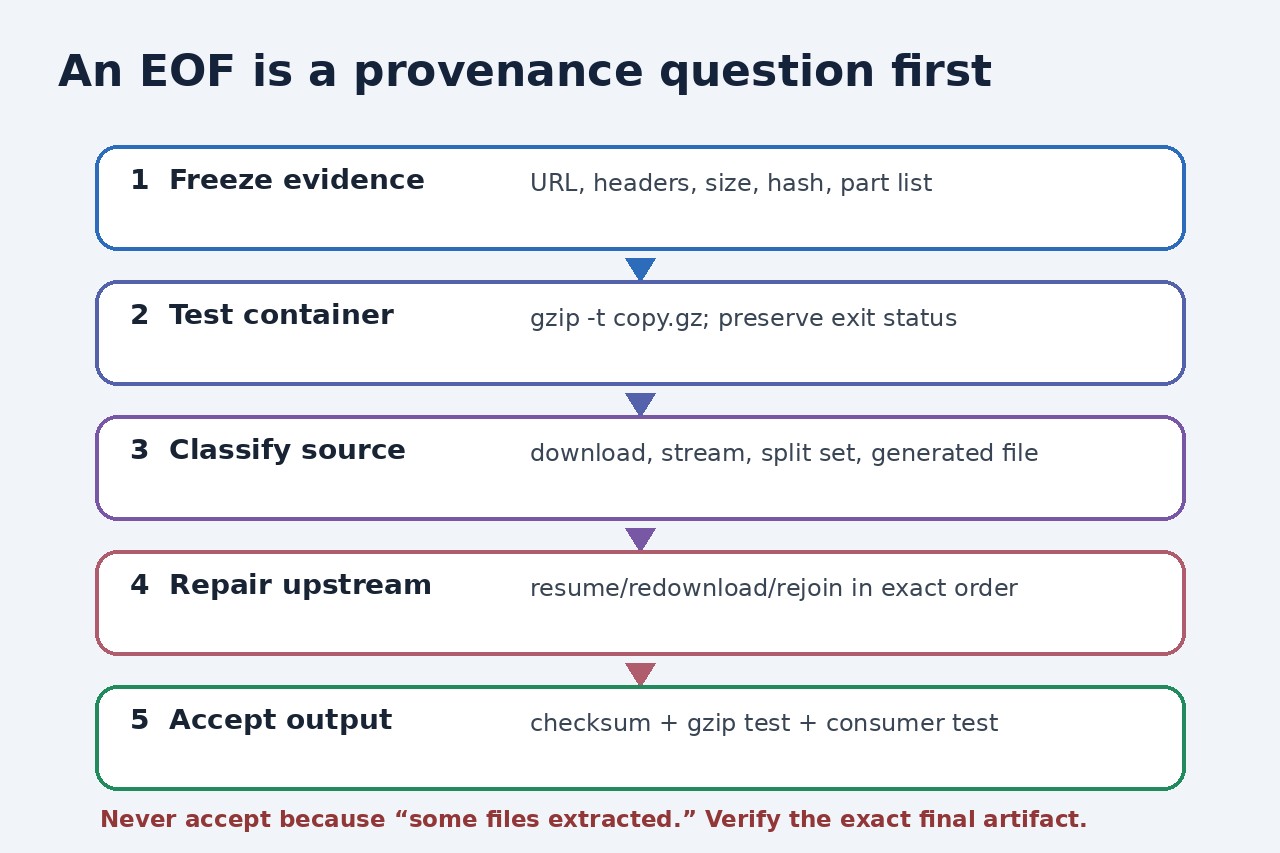
把文件复制到新的证据路径,记录字节数、SHA-256、来源 URL 或对象键、响应头、下载时间和全部分片名。不要用第二次下载覆盖它,否则可能抹掉暴露传输不稳定的差异。
对副本运行 gzip -t,并保存退出码与标准错误。该测试会读取整个 gzip 流并执行完整性检查,不会把“解出了一部分文件”误当成功。处理不可信输入时,应在隔离目录中测试,避免自动解压。
区分下载、流、分片集与上游生成
下载场景应将收到的大小与哈希和发布者的签名或认证元数据比较。检查代理是否返回 HTML、范围请求是否提前结束,或续传是否追加了不兼容字节。把重下文件写到新名字,比较哈希后再决定替换。
流式场景要同时记录传输结束状态和解压错误。Node.js 的需求案例在读取同一 S3 对象时于不同位置失败;这提示应检查流完成、重试和对象身份,而不能据此断言大 gzip 天生无效。
仅按已验证清单拼接字节分片
若制作方明确使用 split,先盘点每个分片、预期大小或哈希,以及排序规则。Unix & Linux 案例说明 part.000 为何在 gzip 完成前结束:这些片段属于同一个文件,必须按顺序拼接后再测试。
把拼接结果写到新文件,不要覆盖分片。先比对可信校验和,再对该文件运行 gzip -t,最后执行真实消费程序。gzip 通过只证明 gzip 完整性,并不证明所有预期应用记录或 tar 成员都存在。
缺少可信源字节时应停止
不要因为已经出现部分文件就接受归档,不要删字节直到测试通过,也不要屏蔽解压错误。这些做法会把可见失败变成静默遗漏。应向发布者或上游任务索取新的不可变对象及校验和。
修复后记录旧新哈希、传输或拼接变化、完整 gzip 测试与下游验证。把未解决缺口明确保留;如果不存在权威源文件,就应把输出标记为部分结果,而不是完整结果。