科技 · 实用指南
Google Takeout 照片显示今天的日期?修改前先审计 EXIF 与 JSON 匹配
用只读试点报告分开下载时间戳、内嵌标签与侧车日期;文件名匹配并不等于获准改写元数据。
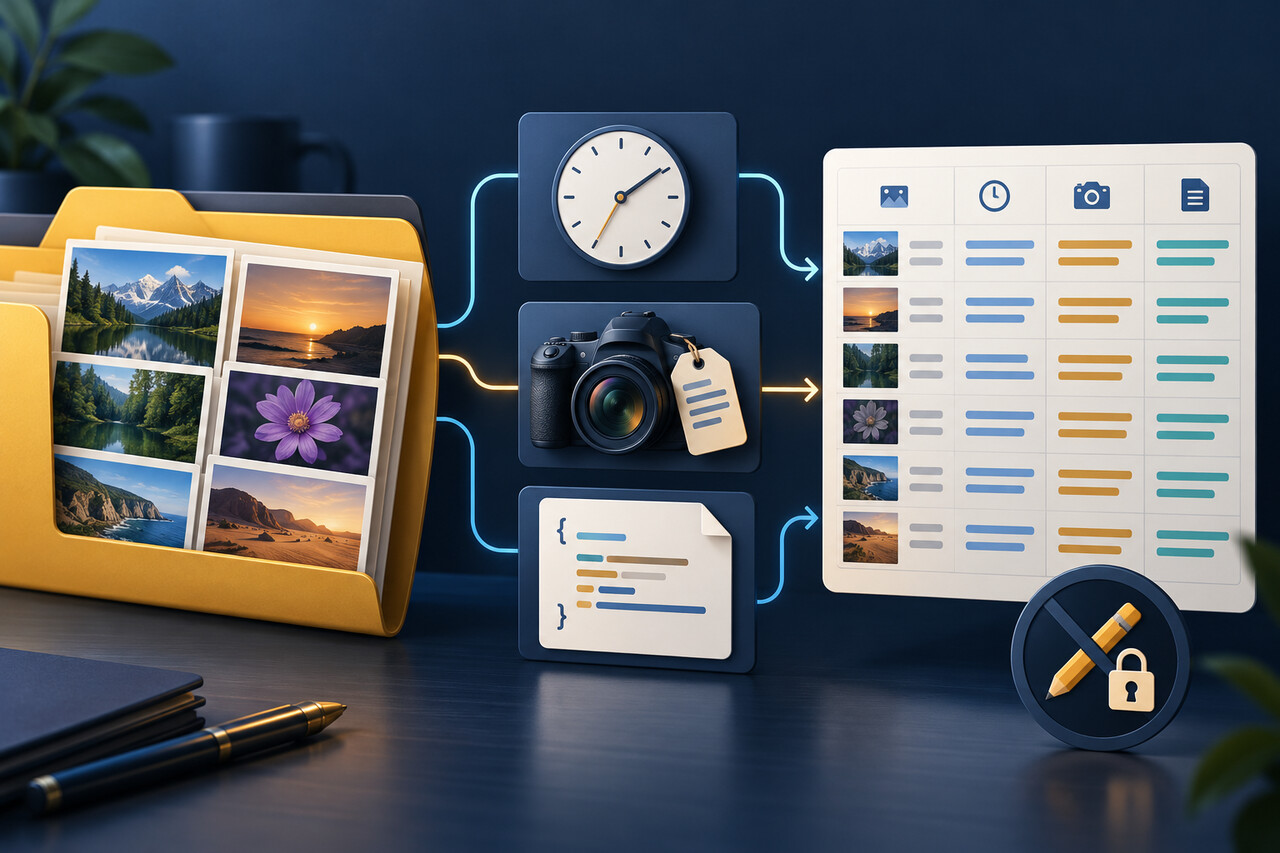
Google Takeout 可能在同一张照片旁留下多层日期:下载时分配的文件系统修改时间、内嵌 EXIF 或视频标签,以及含 photoTakenTime 等字段的 JSON 侧车。它们不能互换。Google 官方帮助也指出,操作系统可能给下载文件分配新的时间戳,而照片或视频的元数据仍可在文件详细信息中找到。
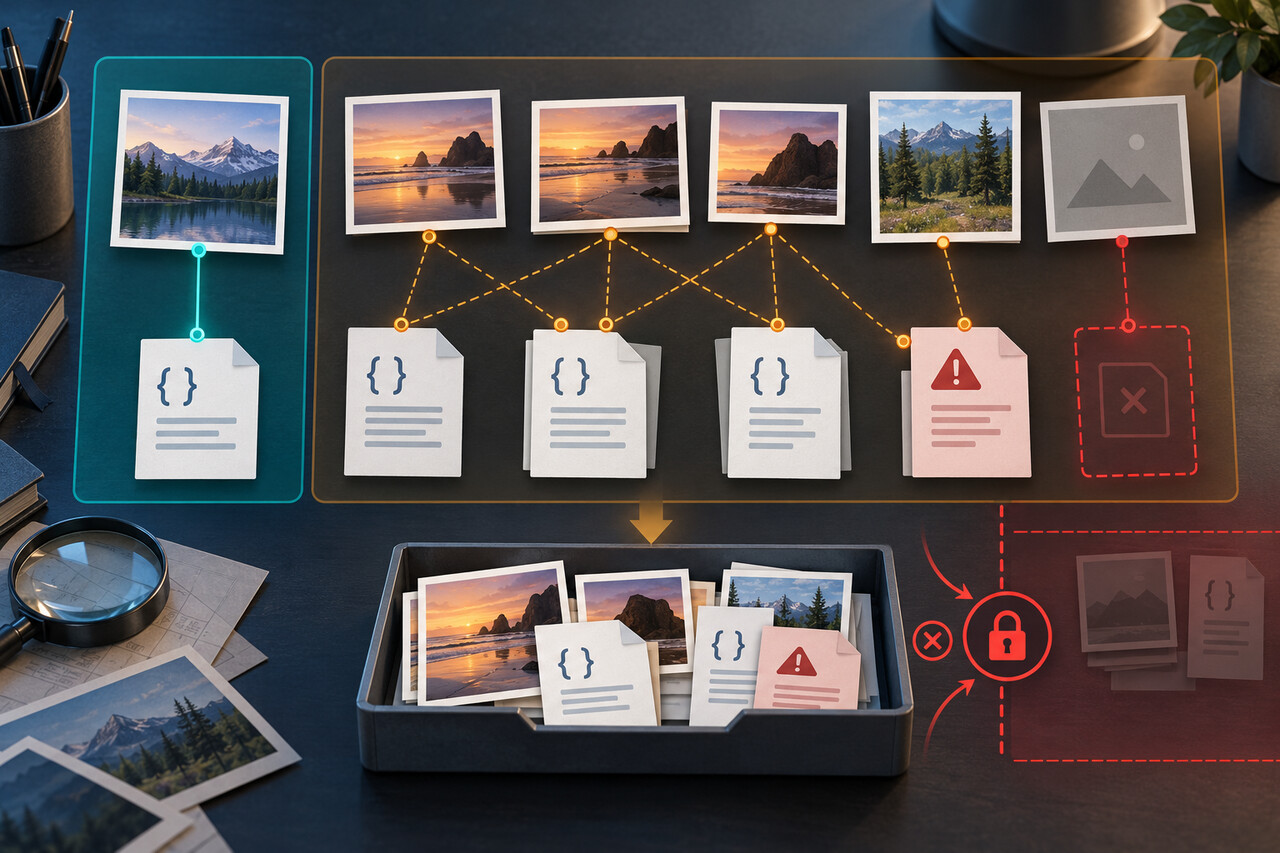
危险的捷径是把每个显示今天日期的文件都当成损坏,并立即把 JSON 值写进媒体。文件名截断、编辑版、副本以及旧式与 supplemental-metadata 命名差异,都可能让多个侧车看似合理。一次错误的一对一匹配,足以悄悄把成千上万张照片移到错误日期。
本指南只为可信的解压副本建立有界证据表,所有日期比较和元数据更改都留给人工复核。缺少元数据记录时标记为 not-inspected,而不是断言文件没有拍摄日期。
保全导出文件并只读提取内嵌标签
保留原始压缩包,并先完成所有分卷的解压。请在名为 Takeout 的可信独立副本上工作,不使用符号链接,并把报告文件放在该目录树之外。本试点最多支持 10,000 个源文件;请先在小型且有代表性的副本上运行。它会为每个源文件计算两次哈希,可能产生大量磁盘读取;候选文件名扫描也采取保守规则,并不验证所有可能的 Takeout 布局。
通过 ExifTool 官方发行渠道安装 ExifTool,并准备 Python 3.9 或更高版本。在父目录中,以 Linux Bash 运行下面的只读 ExifTool 模板。使用全新的 embedded.json,检查 stderr 和退出状态;读取失败就停止。这是标签导出,而不是 -json= 导入;没有赋值、tagsFromFile 或覆盖选项。该命令已对照 ExifTool 官方参考核验,但本轮没有实际执行。
( set -o noclobber; exiftool -r -json -G1 -s -DateTimeOriginal -CreateDate -OffsetTimeOriginal -OffsetTimeDigitized -Error -Warning "Takeout" > "embedded.json" )
生成有界 CSV 报告
当前文件夹内应有 Takeout 和 embedded.json。把下一条命令复制为一整行,并保留直引号和反斜杠。它会在源目录树之外以独占创建方式生成 takeout-audit.csv,因此已有报告会被拒绝覆盖。我们通过 Linux Bash 和合成元数据记录实际执行过 Python 转换;真实 ExifTool/媒体提取以及 Windows、macOS 执行均未测试。
报告清点 JPG/JPEG、HEIC、PNG、GIF、MP4、MOV、TIF/TIFF 和 WEBP 扩展名,包含解析后的原始内嵌记录、选定的 JSON 日期证据,以及明确标注为 UTC 的文件系统修改时间。它不会解码媒体,也不能证明文件有效。创建输出前,源文件大小、纳秒 mtime、哈希和文件集合必须保持不变;随后还会回读并逐项比较 CSV 表头与所有字段。
python3 -c 'exec("import csv, json, sys, hashlib\nfrom pathlib import Path\nfrom datetime import datetime, timezone\ndef pairs(items):\n result = {}\n for k, v in items:\n if k in result: raise ValueError('"'"'Duplicate JSON key'"'"')\n result[k] = v\n return result\ndef read_json(p):\n return json.loads(p.read_bytes().decode('"'"'utf-8-sig'"'"'), object_pairs_hook=pairs, parse_constant=lambda x: (_ for _ in ()).throw(ValueError('"'"'Nonstandard number'"'"')))\ndef utc(v):\n if not isinstance(v, dict) or '"'"'timestamp'"'"' not in v: return '"'"''"'"'\n t = v['"'"'timestamp'"'"']\n if type(t) is int: n = t\n elif isinstance(t, str) and t.lstrip('"'"'-'"'"').isdigit(): n = int(t)\n else: raise ValueError('"'"'Invalid epoch'"'"')\n return datetime.fromtimestamp(n, timezone.utc).isoformat()\nroot, metadata, output = map(Path, sys.argv[1:])\nroot = root.resolve()\nif not root.is_dir(): raise ValueError('"'"'Need extracted root directory'"'"')\nif output.resolve().is_relative_to(root): raise ValueError('"'"'Output must be outside source tree'"'"')\nfiles = sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file())\nif len(files) > 10000: raise ValueError('"'"'Bounded pilot only: at most 10000 source files'"'"')\nif any(p.is_symlink() for p in root.rglob('"'"'*'"'"')): raise ValueError('"'"'Symlinks unsupported'"'"')\ndef digest(p):\n h = hashlib.sha256()\n with p.open('"'"'rb'"'"') as f:\n for chunk in iter(lambda: f.read(1048576), b'"'"''"'"'): h.update(chunk)\n return h.hexdigest()\ndef snapshot():\n return {str(p.relative_to(root)): (p.stat().st_size, p.stat().st_mtime_ns, digest(p)) for p in files}\nbefore = snapshot()\nmedia = [p for p in files if p.suffix.lower() in {'"'"'.jpg'"'"','"'"'.jpeg'"'"','"'"'.heic'"'"','"'"'.png'"'"','"'"'.gif'"'"','"'"'.mp4'"'"','"'"'.mov'"'"','"'"'.tif'"'"','"'"'.tiff'"'"','"'"'.webp'"'"'}]\nsidecars = [p for p in files if p.suffix.lower() == '"'"'.json'"'"']\ndata = read_json(metadata)\nif not isinstance(data, list): raise ValueError('"'"'Expected ExifTool JSON array'"'"')\nembedded = {}\nfor item in data:\n if not isinstance(item, dict) or not isinstance(item.get('"'"'SourceFile'"'"'), str): raise ValueError('"'"'Missing SourceFile'"'"')\n path = Path(item['"'"'SourceFile'"'"']).resolve()\n if not path.is_relative_to(root): raise ValueError('"'"'Metadata path outside root'"'"')\n if path in embedded: raise ValueError('"'"'Duplicate metadata row'"'"')\n embedded[path] = item\ncandidates = {}\nfor p in media:\n exact = [q for q in sidecars if q.parent == p.parent and q.name in (p.name+'"'"'.json'"'"', p.name+'"'"'.supplemental-metadata.json'"'"')]\n weak = [q for q in sidecars if q.parent == p.parent and q not in exact and len(q.name[:-5]) >= 5 and (p.name.startswith(q.name[:-5]) or q.name.startswith(p.name+'"'"'.s'"'"'))]\n candidates[p] = (exact, weak)\nused = {}\nfor p, (exact, weak) in candidates.items():\n for q in exact + weak: used[q] = used.get(q, 0) + 1\nrows = []\nfor p in media:\n exact, weak = candidates[p]; all_candidates = exact + weak\n state = '"'"'missing'"'"' if not all_candidates else '"'"'ambiguous-truncated'"'"' if weak else '"'"'ambiguous-duplicate'"'"' if len(exact) != 1 or used[exact[0]] != 1 else '"'"'unique'"'"'\n if '"'"'-edited'"'"' in p.stem.lower(): state = '"'"'edited-variant'"'"'\n evidence = []\n for q in all_candidates:\n try:\n value = read_json(q)\n if not isinstance(value, dict): raise ValueError('"'"'Sidecar is not object'"'"')\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'photoTakenTimeUTC'"'"':utc(value.get('"'"'photoTakenTime'"'"')), '"'"'creationTimeUTC'"'"':utc(value.get('"'"'creationTime'"'"')), '"'"'title'"'"':value.get('"'"'title'"'"'), '"'"'error'"'"':'"'"''"'"'})\n except (ValueError, KeyError, OverflowError, OSError, UnicodeError) as e:\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'error'"'"':type(e).__name__})\n state = '"'"'invalid-json'"'"'\n info = embedded.get(p)\n if info is None: embedded_status = '"'"'not-inspected'"'"'\n elif any(k.split('"'"':'"'"')[-1] in ('"'"'Error'"'"','"'"'Warning'"'"') for k in info): embedded_status = '"'"'read-warning-or-error'"'"'\n else: embedded_status = '"'"'record-present-not-capture-proof'"'"'\n rows.append([str(p.relative_to(root)),p.suffix.lower(),str(p.stat().st_size),datetime.fromtimestamp(p.stat().st_mtime,timezone.utc).isoformat(),embedded_status,json.dumps(info or {},ensure_ascii=False),json.dumps(evidence,ensure_ascii=False),state,'"'"'manual-comparison-required'"'"','"'"'No metadata write authorized'"'"'])\nif sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file()) != files or snapshot() != before: raise ValueError('"'"'Source file set/byte/hash/mtime changed; no report created'"'"')\nheader = ['"'"'relative_media_path'"'"','"'"'media_type'"'"','"'"'size_bytes'"'"','"'"'filesystem_mtime_utc'"'"','"'"'embedded_read_status'"'"','"'"'embedded_tags_raw_json'"'"','"'"'candidate_date_evidence_json'"'"','"'"'sidecar_match_status'"'"','"'"'date_source_agreement'"'"','"'"'manual_review_reason'"'"']\nwith output.open('"'"'x'"'"',encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n w=csv.writer(f);w.writerow(header);w.writerows(rows)\nwith output.open(encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n if list(csv.reader(f)) != [header]+rows: raise ValueError('"'"'CSV readback mismatch'"'"')\nprint(len(media),'"'"'media rows; source bytes/hashes/mtimes unchanged; no metadata written'"'"')\n")' "Takeout" "embedded.json" "takeout-audit.csv"
解释匹配和日期,但不要猜测
十列依次为 relative_media_path、media_type、size_bytes、filesystem_mtime_utc、embedded_read_status、embedded_tags_raw_json、candidate_date_evidence_json、sidecar_match_status、date_source_agreement 和 manual_review_reason。相对路径可区分不同文件夹中的同名文件。原始内嵌 JSON 保留可用的选定标签和偏移;缺少记录标为 not-inspected,出现读取警告或错误也不等于已验证拍摄日期。
在同一目录内,精确候选是完整媒体文件名再加 .json 或 .supplemental-metadata.json。弱候选包括:至少五个字符的 JSON 基名是媒体名的前缀,或缩短的 .s… 后缀形式。所有候选及其解析错误都会保留。多个精确候选标为 ambiguous-duplicate;只要出现弱候选就标为 ambiguous-truncated;文件名含 -edited 时为 edited-variant;无效 JSON/日期数据为 invalid-json。其他命名变体仍可能漏掉,因此 missing 只表示按这些规则没找到候选,不证明侧车不存在。
unique 仅表示在这组有限规则下存在一个未被其他媒体行共用的精确候选,并不能证明其内容属于该照片。JSON 的 photoTakenTime 和 creationTime epoch 会分别按 UTC 显示,但不会选择任何字段作为正确拍摄日期。每行仍为 manual-comparison-required:没有可靠时区的 EXIF 本地时间无法当作精确时刻比较。提出更改前,应保留原始文本,并复核标题、图像内容、相册上下文和偏移。
验证覆盖范围,并把修复留在独立阶段
报告中的媒体数量必须等于使用所列扩展名发现的文件数;由于字段可能含换行,CSV 记录数不能用物理文本行数代替。请从每个相关分支打开样本:静态图片、视频、编辑项、重名文件和非 ASCII 文件名,并把实际媒体与侧车一起检查。未检查或读取出错的内嵌记录,以及弱匹配、缺失、编辑版或无效候选,都需要人工复核。
以 UTF-8、逗号分隔、直双引号方式导入 CSV。把每一列都设为文本,并关闭公式求值和自动去空格,以免文件名与原始证据改变。保留 JSON/CSV 主文件,只在工作副本中批注。若解析、哈希、写入或回读失败,丢弃不完整输出,调查源文件并改用新的报告名。此 CSV 不是 ExifTool 导入文件,不能更新元数据。
十六个真实 Linux Bash 合成用例覆盖了旧/新精确名称、缺失及竞争候选、共享截断、编辑名称、畸形/重复键 JSON、无效 epoch、含 Unicode/逗号/换行的路径、不同目录同名、未检查视频、读取错误和空导出;另有十六次覆盖尝试被拒绝,源字节、哈希和 mtime 均保持不变。没有测试真实归档、ExifTool、GUI 或迁移。后续修复计划必须写明精确子集、来源字段、各媒体格式的目标标签、备份与回滚,并在副本上验证写入。仅仅在某个应用里排序正确,并不足以证明迁移正确。