기술 · 실용 가이드
Google Takeout 사진이 오늘 날짜로 보이나요? 편집 전에 EXIF와 JSON 일치를 점검하세요
다운로드 시각, 내장 태그, 사이드카 날짜를 읽기 전용 시험 보고서로 분리합니다. 파일명 일치는 메타데이터를 덮어쓸 권한이 아닙니다.
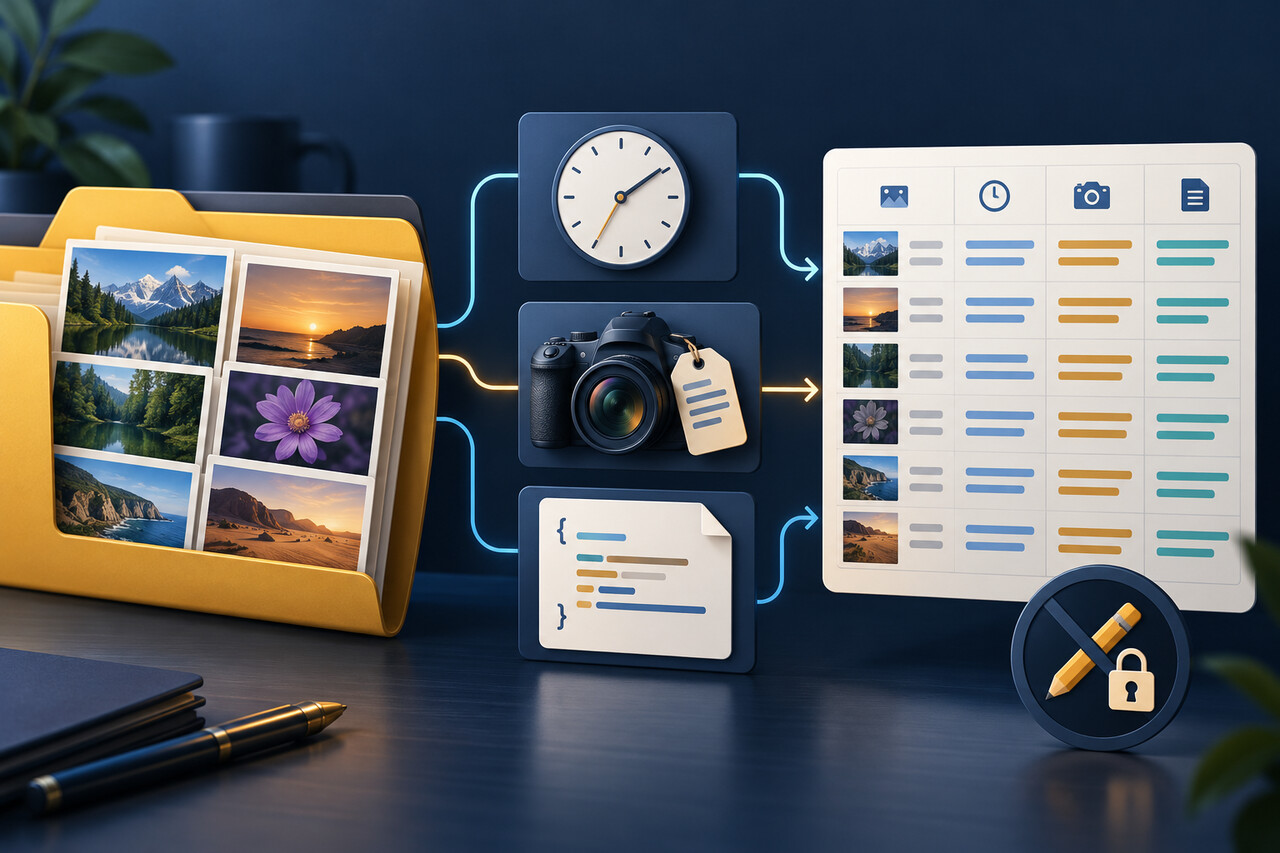
Google Takeout에는 한 사진 옆에 여러 날짜 층이 남을 수 있습니다. 다운로드할 때 부여된 파일 시스템 수정 시각, 내장 EXIF 또는 동영상 태그, photoTakenTime 같은 필드가 있는 JSON 사이드카입니다. 이 값들은 서로 바꿔 쓸 수 없습니다. Google 공식 도움말도 운영체제가 다운로드 파일에 새 타임스탬프를 부여해도 사진이나 동영상 메타데이터는 파일 세부정보에 남을 수 있다고 설명합니다.
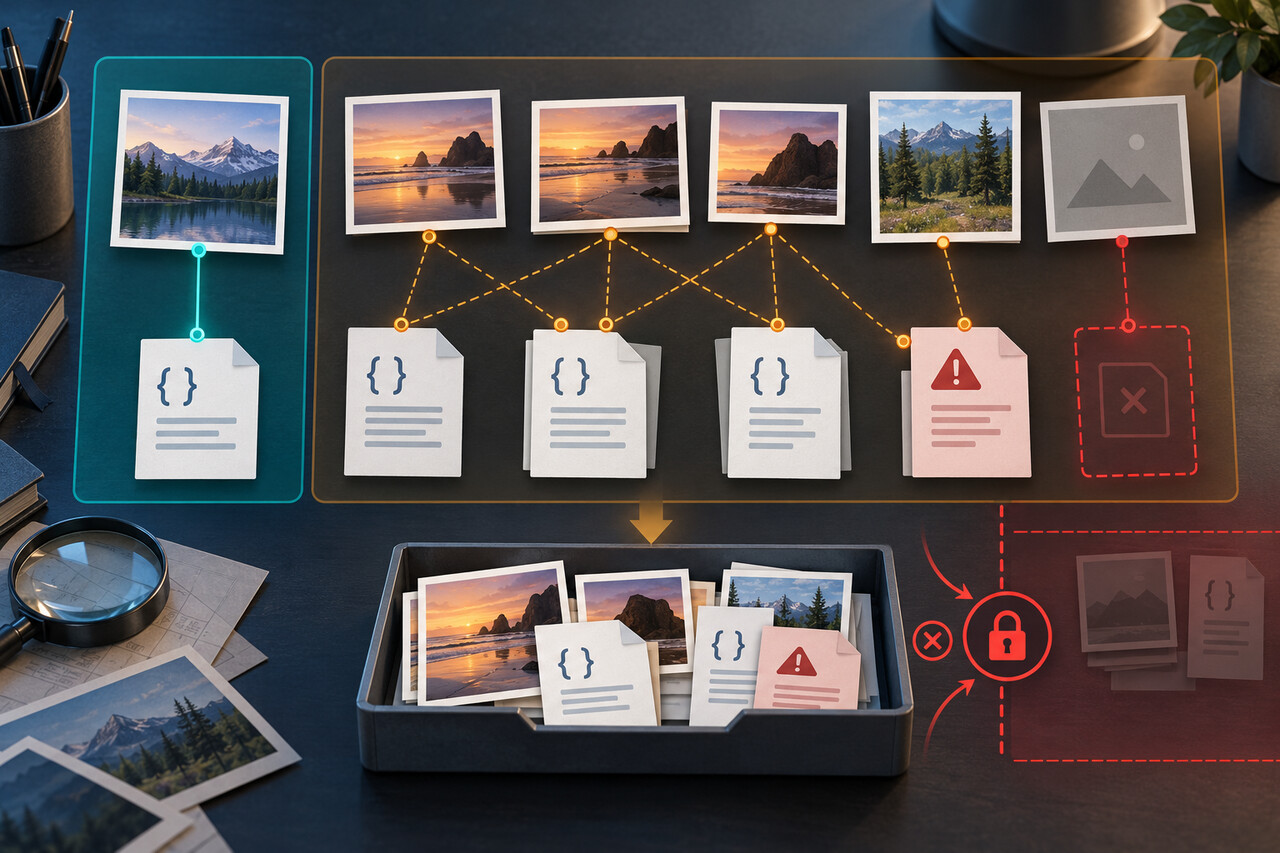
가장 위험한 지름길은 오늘 날짜가 보이는 모든 파일을 손상됐다고 간주하고 JSON 값을 즉시 미디어에 복사하는 것입니다. 긴 파일명 잘림, 편집본, 중복 파일, 예전 방식과 supplemental-metadata 방식의 이름 차이 때문에 여러 사이드카가 그럴듯해 보일 수 있습니다. 잘못된 일대일 연결은 수천 장의 사진을 조용히 엉뚱한 날짜로 옮길 수 있습니다.
이 가이드는 신뢰할 수 있는 압축 해제 복사본에서 범위를 제한한 증거표만 만듭니다. 날짜 비교와 메타데이터 변경은 모두 수동 검토로 남깁니다. 메타데이터 레코드가 없으면 촬영 날짜가 없다고 단정하지 않고 not-inspected로 표시합니다.
내보내기를 보존하고 내장 태그를 읽기 전용으로 추출하기
원본 아카이브를 보관하고 분할된 모든 파일의 압축 해제를 끝내세요. 가능하면 Takeout이라는 이름의 신뢰할 수 있는 별도 복사본에서 작업하고, 심볼릭 링크는 쓰지 말며, 보고서는 그 트리 밖에 두세요. 이 시험은 전체 소스 파일 10,000개까지만 지원하므로 작고 대표적인 복사본에서 먼저 실행하세요. 모든 소스 파일을 두 번 해시하므로 디스크 읽기 비용이 클 수 있습니다. 후보 파일명 검사는 보수적이며 가능한 모든 Takeout 구조를 검증하지는 않습니다.
ExifTool은 공식 배포판으로 설치하고 Python 3.9 이상을 준비하세요. 상위 폴더에서 아래 읽기 전용 ExifTool 템플릿을 Linux Bash로 실행합니다. 새 embedded.json을 쓰고 stderr와 종료 상태를 확인하며, 읽기 실패 시 중단하세요. 이것은 태그 내보내기이지 -json= 가져오기가 아닙니다. 대입, tagsFromFile, 덮어쓰기 옵션은 없습니다. 명령은 ExifTool 공식 참고문서와 대조했지만 여기서는 실행하지 않았습니다.
( set -o noclobber; exiftool -r -json -G1 -s -DateTimeOriginal -CreateDate -OffsetTimeOriginal -OffsetTimeDigitized -Error -Warning "Takeout" > "embedded.json" )
범위를 제한한 CSV 보고서 만들기
현재 폴더에 Takeout과 embedded.json을 둔 뒤 다음 명령을 한 줄로 복사하세요. 곧은따옴표와 백슬래시를 유지해야 합니다. 소스 트리 밖에 takeout-audit.csv를 배타적으로 새로 만들므로 같은 이름의 기존 보고서는 덮어쓰지 않습니다. Python 변환은 합성 메타데이터를 사용해 Linux Bash에서 실제 실행했지만, 실제 미디어에 대한 ExifTool 추출과 Windows·macOS 실행은 시험하지 않았습니다.
보고서는 JPG/JPEG, HEIC, PNG, GIF, MP4, MOV, TIF/TIFF, WEBP 확장자를 목록화합니다. 파싱한 원시 내장 레코드, 선택한 JSON 날짜 증거, UTC라고 명시한 파일 시스템 수정 시각을 포함합니다. 미디어를 디코딩하거나 파일 유효성을 증명하지 않습니다. 출력을 만들기 전에 소스 크기, 나노초 mtime, 해시, 파일 집합이 그대로여야 하며, 생성 뒤에는 CSV 헤더와 모든 필드를 다시 읽어 비교합니다.
python3 -c 'exec("import csv, json, sys, hashlib\nfrom pathlib import Path\nfrom datetime import datetime, timezone\ndef pairs(items):\n result = {}\n for k, v in items:\n if k in result: raise ValueError('"'"'Duplicate JSON key'"'"')\n result[k] = v\n return result\ndef read_json(p):\n return json.loads(p.read_bytes().decode('"'"'utf-8-sig'"'"'), object_pairs_hook=pairs, parse_constant=lambda x: (_ for _ in ()).throw(ValueError('"'"'Nonstandard number'"'"')))\ndef utc(v):\n if not isinstance(v, dict) or '"'"'timestamp'"'"' not in v: return '"'"''"'"'\n t = v['"'"'timestamp'"'"']\n if type(t) is int: n = t\n elif isinstance(t, str) and t.lstrip('"'"'-'"'"').isdigit(): n = int(t)\n else: raise ValueError('"'"'Invalid epoch'"'"')\n return datetime.fromtimestamp(n, timezone.utc).isoformat()\nroot, metadata, output = map(Path, sys.argv[1:])\nroot = root.resolve()\nif not root.is_dir(): raise ValueError('"'"'Need extracted root directory'"'"')\nif output.resolve().is_relative_to(root): raise ValueError('"'"'Output must be outside source tree'"'"')\nfiles = sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file())\nif len(files) > 10000: raise ValueError('"'"'Bounded pilot only: at most 10000 source files'"'"')\nif any(p.is_symlink() for p in root.rglob('"'"'*'"'"')): raise ValueError('"'"'Symlinks unsupported'"'"')\ndef digest(p):\n h = hashlib.sha256()\n with p.open('"'"'rb'"'"') as f:\n for chunk in iter(lambda: f.read(1048576), b'"'"''"'"'): h.update(chunk)\n return h.hexdigest()\ndef snapshot():\n return {str(p.relative_to(root)): (p.stat().st_size, p.stat().st_mtime_ns, digest(p)) for p in files}\nbefore = snapshot()\nmedia = [p for p in files if p.suffix.lower() in {'"'"'.jpg'"'"','"'"'.jpeg'"'"','"'"'.heic'"'"','"'"'.png'"'"','"'"'.gif'"'"','"'"'.mp4'"'"','"'"'.mov'"'"','"'"'.tif'"'"','"'"'.tiff'"'"','"'"'.webp'"'"'}]\nsidecars = [p for p in files if p.suffix.lower() == '"'"'.json'"'"']\ndata = read_json(metadata)\nif not isinstance(data, list): raise ValueError('"'"'Expected ExifTool JSON array'"'"')\nembedded = {}\nfor item in data:\n if not isinstance(item, dict) or not isinstance(item.get('"'"'SourceFile'"'"'), str): raise ValueError('"'"'Missing SourceFile'"'"')\n path = Path(item['"'"'SourceFile'"'"']).resolve()\n if not path.is_relative_to(root): raise ValueError('"'"'Metadata path outside root'"'"')\n if path in embedded: raise ValueError('"'"'Duplicate metadata row'"'"')\n embedded[path] = item\ncandidates = {}\nfor p in media:\n exact = [q for q in sidecars if q.parent == p.parent and q.name in (p.name+'"'"'.json'"'"', p.name+'"'"'.supplemental-metadata.json'"'"')]\n weak = [q for q in sidecars if q.parent == p.parent and q not in exact and len(q.name[:-5]) >= 5 and (p.name.startswith(q.name[:-5]) or q.name.startswith(p.name+'"'"'.s'"'"'))]\n candidates[p] = (exact, weak)\nused = {}\nfor p, (exact, weak) in candidates.items():\n for q in exact + weak: used[q] = used.get(q, 0) + 1\nrows = []\nfor p in media:\n exact, weak = candidates[p]; all_candidates = exact + weak\n state = '"'"'missing'"'"' if not all_candidates else '"'"'ambiguous-truncated'"'"' if weak else '"'"'ambiguous-duplicate'"'"' if len(exact) != 1 or used[exact[0]] != 1 else '"'"'unique'"'"'\n if '"'"'-edited'"'"' in p.stem.lower(): state = '"'"'edited-variant'"'"'\n evidence = []\n for q in all_candidates:\n try:\n value = read_json(q)\n if not isinstance(value, dict): raise ValueError('"'"'Sidecar is not object'"'"')\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'photoTakenTimeUTC'"'"':utc(value.get('"'"'photoTakenTime'"'"')), '"'"'creationTimeUTC'"'"':utc(value.get('"'"'creationTime'"'"')), '"'"'title'"'"':value.get('"'"'title'"'"'), '"'"'error'"'"':'"'"''"'"'})\n except (ValueError, KeyError, OverflowError, OSError, UnicodeError) as e:\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'error'"'"':type(e).__name__})\n state = '"'"'invalid-json'"'"'\n info = embedded.get(p)\n if info is None: embedded_status = '"'"'not-inspected'"'"'\n elif any(k.split('"'"':'"'"')[-1] in ('"'"'Error'"'"','"'"'Warning'"'"') for k in info): embedded_status = '"'"'read-warning-or-error'"'"'\n else: embedded_status = '"'"'record-present-not-capture-proof'"'"'\n rows.append([str(p.relative_to(root)),p.suffix.lower(),str(p.stat().st_size),datetime.fromtimestamp(p.stat().st_mtime,timezone.utc).isoformat(),embedded_status,json.dumps(info or {},ensure_ascii=False),json.dumps(evidence,ensure_ascii=False),state,'"'"'manual-comparison-required'"'"','"'"'No metadata write authorized'"'"'])\nif sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file()) != files or snapshot() != before: raise ValueError('"'"'Source file set/byte/hash/mtime changed; no report created'"'"')\nheader = ['"'"'relative_media_path'"'"','"'"'media_type'"'"','"'"'size_bytes'"'"','"'"'filesystem_mtime_utc'"'"','"'"'embedded_read_status'"'"','"'"'embedded_tags_raw_json'"'"','"'"'candidate_date_evidence_json'"'"','"'"'sidecar_match_status'"'"','"'"'date_source_agreement'"'"','"'"'manual_review_reason'"'"']\nwith output.open('"'"'x'"'"',encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n w=csv.writer(f);w.writerow(header);w.writerows(rows)\nwith output.open(encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n if list(csv.reader(f)) != [header]+rows: raise ValueError('"'"'CSV readback mismatch'"'"')\nprint(len(media),'"'"'media rows; source bytes/hashes/mtimes unchanged; no metadata written'"'"')\n")' "Takeout" "embedded.json" "takeout-audit.csv"
일치와 날짜를 추측하지 말고 해석하기
열 10개는 relative_media_path, media_type, size_bytes, filesystem_mtime_utc, embedded_read_status, embedded_tags_raw_json, candidate_date_evidence_json, sidecar_match_status, date_source_agreement, manual_review_reason입니다. 상대 경로로 다른 폴더의 같은 이름을 구분합니다. 원시 내장 JSON은 읽은 선택 태그와 오프셋을 보존합니다. 레코드가 없으면 not-inspected이며, 경고나 오류가 있어도 검증된 촬영 날짜로 취급하지 않습니다.
같은 디렉터리에서 정확한 후보는 전체 미디어 파일명에 .json 또는 .supplemental-metadata.json을 붙인 이름입니다. 약한 후보는 길이 5자 이상인 JSON 기본명이 미디어 이름의 접두사이거나 축약된 .s… 접미사 형태인 경우를 포함합니다. 모든 후보와 파싱 오류를 남깁니다. 정확한 후보가 여러 개면 ambiguous-duplicate, 약한 후보가 하나라도 있으면 ambiguous-truncated, 파일명에 -edited가 있으면 edited-variant, JSON이나 날짜가 유효하지 않으면 invalid-json입니다. 다른 이름 규칙은 놓칠 수 있으므로 missing은 이 규칙으로 후보를 찾지 못했다는 뜻일 뿐, 사이드카가 없다는 증거가 아닙니다.
unique는 이 제한된 규칙에서 다른 미디어 행과 공유되지 않는 정확한 후보가 하나 있다는 뜻일 뿐, 그 내용이 해당 사진에 속한다고 증명하지 않습니다. JSON의 photoTakenTime과 creationTime epoch는 UTC로 따로 표시하지만 어느 값도 올바른 촬영 날짜로 선택하지 않습니다. 모든 행은 manual-comparison-required로 남습니다. 신뢰할 수 있는 시간대가 없는 EXIF 현지 시각은 정확한 순간으로 비교할 수 없습니다. 변경을 제안하기 전에 원문과 오프셋을 보존하고 제목, 이미지 내용, 앨범 맥락을 검토하세요.
범위를 검증하고 복구는 별도 단계로 유지하기
보고된 미디어 수는 지정 확장자로 발견한 파일 수와 같아야 합니다. 필드에 줄바꿈이 들어갈 수 있으므로 CSV 레코드 수를 물리적인 텍스트 줄 수로 세면 안 됩니다. 정지 이미지, 동영상, 편집본, 중복 이름, 비 ASCII 파일명 등 관련 분기마다 표본을 열고 실제 미디어와 사이드카를 함께 확인하세요. 검사하지 않았거나 오류가 난 내장 레코드, 약한 일치, 누락, 편집본, 무효 후보는 수동 검토가 필요합니다.
CSV를 UTF-8, 쉼표 구분, 곧은 큰따옴표 형식으로 가져오세요. 모든 열을 텍스트로 지정하고 수식 평가와 자동 공백 제거를 꺼서 파일명과 원시 증거가 바뀌지 않게 합니다. JSON과 CSV 원본은 보관하고 작업 복사본에만 주석을 답니다. 파싱, 해시, 쓰기, 재읽기 중 하나라도 실패하면 불완전한 출력을 버리고 원인을 조사한 뒤 새 보고서 이름을 선택하세요. 이 CSV는 ExifTool 가져오기 파일이 아니며 메타데이터를 갱신할 수 없습니다.
실제 Linux Bash 합성 테스트 16건은 예전·새 정확한 이름, 누락과 경쟁 후보, 공유된 잘림, 편집 이름, 손상·중복 키 JSON, 잘못된 epoch, Unicode·쉼표·줄바꿈이 있는 경로, 다른 폴더의 같은 이름, 미검사 동영상, 읽기 오류, 빈 내보내기를 다뤘습니다. 추가 덮어쓰기 시도 16건도 거부됐고 소스 바이트, 해시, mtime은 변하지 않았습니다. 실제 아카이브, ExifTool, GUI, 이전 작업은 시험하지 않았습니다. 이후 복구 계획은 정확한 대상 집합, 참조 필드, 형식별 대상 태그, 백업과 롤백을 정의하고 복사본에 쓰기를 검증해야 합니다. 한 앱에서 정렬이 맞는 것만으로 올바른 이전을 증명할 수 없습니다.