テクノロジー · 実用ガイド
Google Takeout の写真が今日の日付になる?編集前に EXIF と JSON の対応を監査する
ダウンロード時刻、埋め込みタグ、サイドカーの日付を読み取り専用の試行レポートで分離します。ファイル名が一致しても、メタデータを書き換えてよいとは限りません。
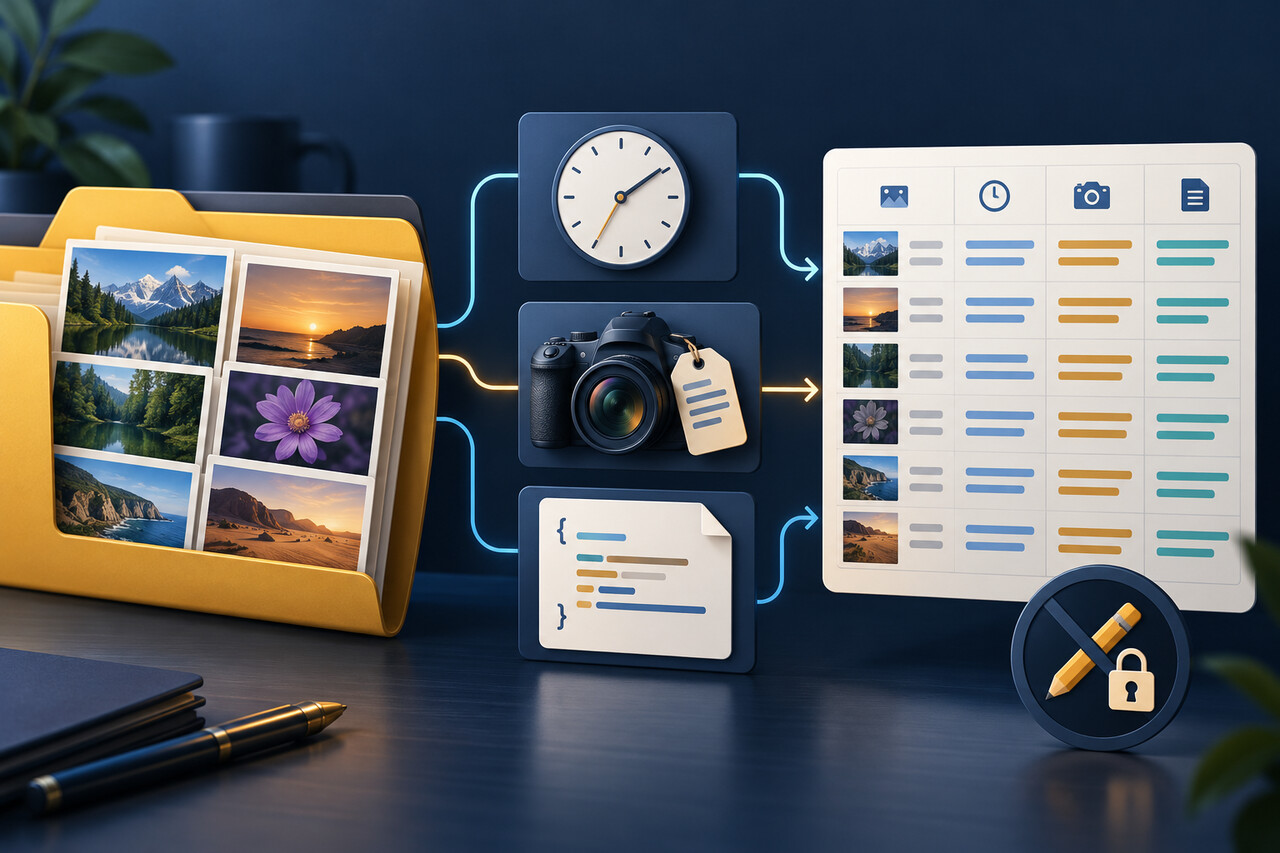
Google Takeout では、同じ写真のそばに複数の日時層が残ることがあります。ダウンロード時に付いたファイルシステムの更新時刻、埋め込み EXIF や動画タグ、photoTakenTime などを含む JSON サイドカーです。これらは相互に置き換えられません。Google の公式ヘルプも、OS がダウンロードしたファイルに新しい時刻を付けても、写真や動画のメタデータがファイルの詳細に残る場合があると説明しています。
危険なのは、今日の日付を示すファイルをすべて破損扱いし、すぐ JSON の値をメディアへ書き込むことです。長いファイル名の切り詰め、編集版、重複、旧形式と supplemental-metadata 形式の違いにより、複数のサイドカーがもっともらしく見える場合があります。一対一の対応を誤ると、何千枚もの写真が静かに別の日付へ移動しかねません。
このガイドは、信頼できる展開済みコピーから範囲を限定した証拠表を作るだけです。日時の判断とメタデータ変更はすべて人手の確認に残します。メタデータ行がない場合は not-inspected と記録し、撮影日時がないとは断定しません。
エクスポートを保全し、埋め込みタグを読み取り専用で取得する
元のアーカイブを保管し、分割された全パートを展開し終えてください。空き容量があれば Takeout という名前の信頼できる別コピーで作業し、シンボリックリンクは使わず、レポートをそのツリー外に置きます。この試行が扱うソースファイルは合計 10,000 個までです。まず小さく代表的なコピーで実行してください。全ソースを二度ハッシュするためディスク読み取り量が大きくなり得ます。候補名の走査は保守的で、Takeout のあらゆる構成を検証するものではありません。
ExifTool は公式配布元から、Python は 3.9 以降を用意します。親フォルダーから、次の読み取り専用 ExifTool テンプレートを Linux Bash で実行してください。新しい embedded.json を使い、stderr と終了状態を確認し、読み取り失敗時は停止します。これはタグのエクスポートであり、-json= によるインポートではありません。代入、tagsFromFile、上書きオプションは含みません。コマンドは ExifTool の公式リファレンスと照合しましたが、ここでは実行していません。
( set -o noclobber; exiftool -r -json -G1 -s -DateTimeOriginal -CreateDate -OffsetTimeOriginal -OffsetTimeDigitized -Error -Warning "Takeout" > "embedded.json" )
範囲を限定した CSV レポートを生成する
現在のフォルダーに Takeout と embedded.json を置き、次のコマンドを一行としてコピーしてください。直線引用符とバックスラッシュを保ちます。ソースツリー外に takeout-audit.csv を排他的に新規作成するため、同名の既存レポートは上書きされません。Python 変換は合成メタデータを使って Linux Bash から実行済みですが、実在するメディアへの ExifTool 抽出や Windows/macOS では未検証です。
レポートは JPG/JPEG、HEIC、PNG、GIF、MP4、MOV、TIF/TIFF、WEBP を一覧化し、解析した生の埋め込み記録、選択した JSON 日付証拠、UTC と明記したファイルシステム更新時刻を収めます。メディアをデコードせず、ファイルの有効性も証明しません。出力作成前にソースのサイズ、ナノ秒 mtime、ハッシュ、ファイル集合が不変である必要があり、その後 CSV のヘッダーと全フィールドを再読して比較します。
python3 -c 'exec("import csv, json, sys, hashlib\nfrom pathlib import Path\nfrom datetime import datetime, timezone\ndef pairs(items):\n result = {}\n for k, v in items:\n if k in result: raise ValueError('"'"'Duplicate JSON key'"'"')\n result[k] = v\n return result\ndef read_json(p):\n return json.loads(p.read_bytes().decode('"'"'utf-8-sig'"'"'), object_pairs_hook=pairs, parse_constant=lambda x: (_ for _ in ()).throw(ValueError('"'"'Nonstandard number'"'"')))\ndef utc(v):\n if not isinstance(v, dict) or '"'"'timestamp'"'"' not in v: return '"'"''"'"'\n t = v['"'"'timestamp'"'"']\n if type(t) is int: n = t\n elif isinstance(t, str) and t.lstrip('"'"'-'"'"').isdigit(): n = int(t)\n else: raise ValueError('"'"'Invalid epoch'"'"')\n return datetime.fromtimestamp(n, timezone.utc).isoformat()\nroot, metadata, output = map(Path, sys.argv[1:])\nroot = root.resolve()\nif not root.is_dir(): raise ValueError('"'"'Need extracted root directory'"'"')\nif output.resolve().is_relative_to(root): raise ValueError('"'"'Output must be outside source tree'"'"')\nfiles = sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file())\nif len(files) > 10000: raise ValueError('"'"'Bounded pilot only: at most 10000 source files'"'"')\nif any(p.is_symlink() for p in root.rglob('"'"'*'"'"')): raise ValueError('"'"'Symlinks unsupported'"'"')\ndef digest(p):\n h = hashlib.sha256()\n with p.open('"'"'rb'"'"') as f:\n for chunk in iter(lambda: f.read(1048576), b'"'"''"'"'): h.update(chunk)\n return h.hexdigest()\ndef snapshot():\n return {str(p.relative_to(root)): (p.stat().st_size, p.stat().st_mtime_ns, digest(p)) for p in files}\nbefore = snapshot()\nmedia = [p for p in files if p.suffix.lower() in {'"'"'.jpg'"'"','"'"'.jpeg'"'"','"'"'.heic'"'"','"'"'.png'"'"','"'"'.gif'"'"','"'"'.mp4'"'"','"'"'.mov'"'"','"'"'.tif'"'"','"'"'.tiff'"'"','"'"'.webp'"'"'}]\nsidecars = [p for p in files if p.suffix.lower() == '"'"'.json'"'"']\ndata = read_json(metadata)\nif not isinstance(data, list): raise ValueError('"'"'Expected ExifTool JSON array'"'"')\nembedded = {}\nfor item in data:\n if not isinstance(item, dict) or not isinstance(item.get('"'"'SourceFile'"'"'), str): raise ValueError('"'"'Missing SourceFile'"'"')\n path = Path(item['"'"'SourceFile'"'"']).resolve()\n if not path.is_relative_to(root): raise ValueError('"'"'Metadata path outside root'"'"')\n if path in embedded: raise ValueError('"'"'Duplicate metadata row'"'"')\n embedded[path] = item\ncandidates = {}\nfor p in media:\n exact = [q for q in sidecars if q.parent == p.parent and q.name in (p.name+'"'"'.json'"'"', p.name+'"'"'.supplemental-metadata.json'"'"')]\n weak = [q for q in sidecars if q.parent == p.parent and q not in exact and len(q.name[:-5]) >= 5 and (p.name.startswith(q.name[:-5]) or q.name.startswith(p.name+'"'"'.s'"'"'))]\n candidates[p] = (exact, weak)\nused = {}\nfor p, (exact, weak) in candidates.items():\n for q in exact + weak: used[q] = used.get(q, 0) + 1\nrows = []\nfor p in media:\n exact, weak = candidates[p]; all_candidates = exact + weak\n state = '"'"'missing'"'"' if not all_candidates else '"'"'ambiguous-truncated'"'"' if weak else '"'"'ambiguous-duplicate'"'"' if len(exact) != 1 or used[exact[0]] != 1 else '"'"'unique'"'"'\n if '"'"'-edited'"'"' in p.stem.lower(): state = '"'"'edited-variant'"'"'\n evidence = []\n for q in all_candidates:\n try:\n value = read_json(q)\n if not isinstance(value, dict): raise ValueError('"'"'Sidecar is not object'"'"')\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'photoTakenTimeUTC'"'"':utc(value.get('"'"'photoTakenTime'"'"')), '"'"'creationTimeUTC'"'"':utc(value.get('"'"'creationTime'"'"')), '"'"'title'"'"':value.get('"'"'title'"'"'), '"'"'error'"'"':'"'"''"'"'})\n except (ValueError, KeyError, OverflowError, OSError, UnicodeError) as e:\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'error'"'"':type(e).__name__})\n state = '"'"'invalid-json'"'"'\n info = embedded.get(p)\n if info is None: embedded_status = '"'"'not-inspected'"'"'\n elif any(k.split('"'"':'"'"')[-1] in ('"'"'Error'"'"','"'"'Warning'"'"') for k in info): embedded_status = '"'"'read-warning-or-error'"'"'\n else: embedded_status = '"'"'record-present-not-capture-proof'"'"'\n rows.append([str(p.relative_to(root)),p.suffix.lower(),str(p.stat().st_size),datetime.fromtimestamp(p.stat().st_mtime,timezone.utc).isoformat(),embedded_status,json.dumps(info or {},ensure_ascii=False),json.dumps(evidence,ensure_ascii=False),state,'"'"'manual-comparison-required'"'"','"'"'No metadata write authorized'"'"'])\nif sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file()) != files or snapshot() != before: raise ValueError('"'"'Source file set/byte/hash/mtime changed; no report created'"'"')\nheader = ['"'"'relative_media_path'"'"','"'"'media_type'"'"','"'"'size_bytes'"'"','"'"'filesystem_mtime_utc'"'"','"'"'embedded_read_status'"'"','"'"'embedded_tags_raw_json'"'"','"'"'candidate_date_evidence_json'"'"','"'"'sidecar_match_status'"'"','"'"'date_source_agreement'"'"','"'"'manual_review_reason'"'"']\nwith output.open('"'"'x'"'"',encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n w=csv.writer(f);w.writerow(header);w.writerows(rows)\nwith output.open(encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n if list(csv.reader(f)) != [header]+rows: raise ValueError('"'"'CSV readback mismatch'"'"')\nprint(len(media),'"'"'media rows; source bytes/hashes/mtimes unchanged; no metadata written'"'"')\n")' "Takeout" "embedded.json" "takeout-audit.csv"
対応と日時を推測せずに解釈する
10 列は relative_media_path、media_type、size_bytes、filesystem_mtime_utc、embedded_read_status、embedded_tags_raw_json、candidate_date_evidence_json、sidecar_match_status、date_source_agreement、manual_review_reason です。相対パスにより別フォルダーの同名ファイルを区別します。生の埋め込み JSON は取得できた選択タグとオフセットを保持します。行がなければ not-inspected、警告やエラーがあれば読み取り異常であり、撮影日時が確認できたとは扱いません。
同じディレクトリでの完全一致候補は、メディアの完全なファイル名に .json または .supplemental-metadata.json を付けたものです。弱い候補には、5 文字以上の JSON ベース名がメディア名の先頭と一致するものや、短縮された .s… 接尾辞形式を含めます。候補と解析エラーはすべて残します。完全一致が複数なら ambiguous-duplicate、弱い候補が一つでもあれば ambiguous-truncated、-edited を含む名前は edited-variant、無効な JSON/日時は invalid-json です。別の命名形は見逃し得るため、missing はこの規則で候補がなかったという意味に限られ、サイドカーが存在しない証明ではありません。
unique は、この限定規則で他のメディア行と共有されない完全一致候補が一つあることだけを示し、その内容が写真に属すると証明しません。JSON の photoTakenTime と creationTime の epoch は別々に UTC 表示されますが、正しい撮影日時は選びません。すべての行は manual-comparison-required のままです。信頼できるタイムゾーンがない EXIF のローカル時刻は、正確な瞬間として比較できません。変更を提案する前に、原文とオフセットを保ち、タイトル、画像内容、アルバム文脈を確認してください。
網羅性を検証し、修復は別工程に分ける
報告されたメディア数は、対象拡張子で見つかったファイル数と一致しなければなりません。フィールドに改行が入るため、CSV レコード数を物理的なテキスト行数で数えてはいけません。静止画、動画、編集版、重複名、非 ASCII ファイル名など各分岐から標本を開き、実物のメディアとサイドカーを並べて確認します。未確認またはエラーの埋め込み記録、弱い一致、欠落、編集版、無効候補は人手で確認します。
CSV は UTF-8、コンマ区切り、直線二重引用符として取り込み、全列をテキストに設定します。数式評価や自動トリミングを無効にし、ファイル名と生の証拠を変えないでください。JSON/CSV の原本を保持し、注記は作業コピーに行います。解析、ハッシュ、書き込み、再読のいずれかが失敗したら不完全な出力を捨て、原因を調べて別のレポート名を使います。この CSV は ExifTool のインポートファイルではなく、メタデータを更新できません。
Linux Bash で実際に行った 16 個の合成テストは、旧/新の完全名、欠落、競合候補、共有された切り詰め、編集名、壊れた/重複キー JSON、無効 epoch、Unicode・コンマ・改行を含むパス、別フォルダーの同名、未確認動画、読み取りエラー、空エクスポートを扱いました。さらに 16 回の上書き試行が拒否され、ソースのバイト、ハッシュ、mtime は不変でした。実在アーカイブ、ExifTool、GUI、移行は未検証です。後続の修復計画では、正確な対象集合、参照フィールド、形式別の書き込み先タグ、バックアップとロールバックを定義し、コピーで書き込みを検証する必要があります。一つのアプリで正しく並ぶだけでは、移行の正しさを証明できません。