Tecnología · GUÍA PRÁCTICA
¿Tus fotos de Google Takeout muestran la fecha de hoy? Audita EXIF y JSON antes de editar
Separa la fecha de descarga, las etiquetas incrustadas y las fechas de los archivos auxiliares con un informe piloto de solo lectura. Coincidir por nombre no autoriza a reescribir metadatos.
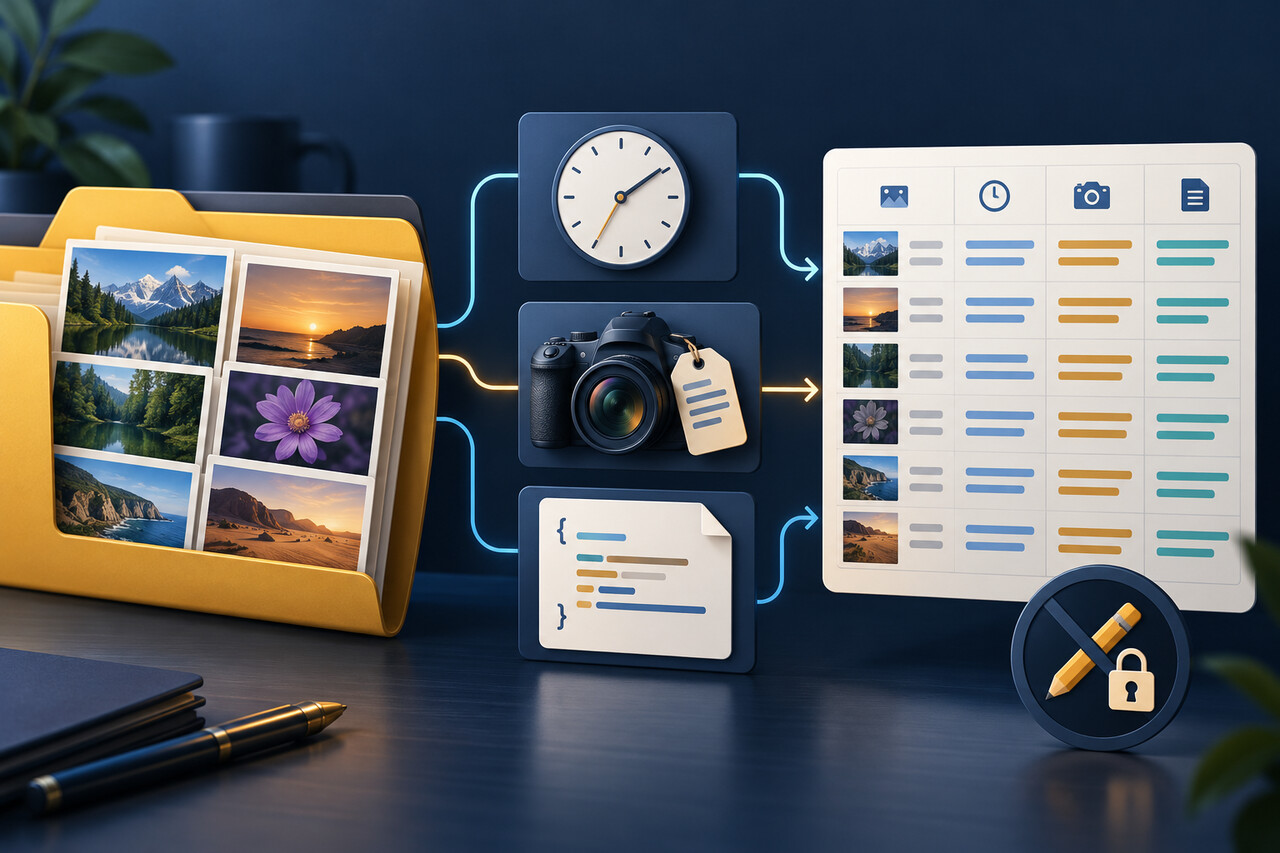
Google Takeout puede dejar varias capas de fecha junto a una misma foto: la hora de modificación del sistema de archivos asignada durante la descarga, las etiquetas EXIF o de vídeo incrustadas y un JSON auxiliar con campos como photoTakenTime. No son intercambiables. La propia ayuda de Google explica que el sistema operativo puede asignar una nueva marca temporal a un archivo descargado aunque los metadatos de la foto o del vídeo sigan disponibles en los detalles del archivo.
El atajo peligroso consiste en dar por dañado todo archivo que muestre la fecha de hoy y copiar de inmediato un valor del JSON al medio. El truncamiento de nombres, las copias editadas, los duplicados y las diferencias entre nombres antiguos y supplemental-metadata pueden hacer que más de un auxiliar parezca válido. Una correspondencia uno a uno incorrecta puede desplazar silenciosamente miles de fotos al día equivocado.
Esta guía solo crea una tabla de pruebas acotada para una copia extraída de confianza. Todas las comparaciones de fecha y cualquier cambio de metadatos quedan para revisión manual. Si falta un registro incrustado se marca como not-inspected, no como ausencia de fecha de captura.
Conserva la exportación y lee las etiquetas incrustadas
Guarda los archivos originales y termina de extraer todas las partes. Trabaja en una copia independiente de confianza llamada Takeout, sin enlaces simbólicos, y deja los informes fuera de ese árbol. Este piloto admite como máximo 10.000 archivos de origen; ejecútalo primero sobre una copia pequeña y representativa. Calcula dos veces el hash de cada archivo, lo que puede exigir muchas lecturas de disco, y busca nombres candidatos de forma conservadora sin validar todas las estructuras posibles de Takeout.
Instala ExifTool desde su distribución oficial y Python 3.9 o posterior. Desde la carpeta superior, ejecuta la siguiente plantilla de ExifTool de solo lectura en Linux Bash. Usa un embedded.json nuevo, revisa stderr y el estado de salida, y detente si falla la lectura. Es una exportación de etiquetas, no una importación -json=; no contiene asignaciones, tagsFromFile ni opciones de sobrescritura. El comando se contrastó con la referencia oficial de ExifTool, pero no se ejecutó aquí.
( set -o noclobber; exiftool -r -json -G1 -s -DateTimeOriginal -CreateDate -OffsetTimeOriginal -OffsetTimeDigitized -Error -Warning "Takeout" > "embedded.json" )
Genera el informe CSV acotado
Con Takeout y embedded.json en la carpeta actual, copia el siguiente comando como una sola línea y conserva las comillas rectas y las barras inversas. Crea takeout-audit.csv fuera del árbol de origen de forma exclusiva, por lo que rechazará un informe existente. Ejecutamos la conversión de Python mediante Linux Bash con registros sintéticos; no se probaron la extracción real con ExifTool, archivos multimedia reales ni la ejecución en Windows o macOS.
El informe inventaría JPG/JPEG, HEIC, PNG, GIF, MP4, MOV, TIF/TIFF y WEBP. Incluye los registros incrustados sin resumir que pudieron analizarse, pruebas de fechas JSON seleccionadas y la hora de modificación del sistema de archivos etiquetada expresamente como UTC. No descodifica el medio ni demuestra que el archivo sea válido. Antes de crear la salida deben permanecer iguales los tamaños, mtime en nanosegundos, hashes y conjunto de archivos; después se vuelven a leer y comparar la cabecera CSV y todos los campos.
python3 -c 'exec("import csv, json, sys, hashlib\nfrom pathlib import Path\nfrom datetime import datetime, timezone\ndef pairs(items):\n result = {}\n for k, v in items:\n if k in result: raise ValueError('"'"'Duplicate JSON key'"'"')\n result[k] = v\n return result\ndef read_json(p):\n return json.loads(p.read_bytes().decode('"'"'utf-8-sig'"'"'), object_pairs_hook=pairs, parse_constant=lambda x: (_ for _ in ()).throw(ValueError('"'"'Nonstandard number'"'"')))\ndef utc(v):\n if not isinstance(v, dict) or '"'"'timestamp'"'"' not in v: return '"'"''"'"'\n t = v['"'"'timestamp'"'"']\n if type(t) is int: n = t\n elif isinstance(t, str) and t.lstrip('"'"'-'"'"').isdigit(): n = int(t)\n else: raise ValueError('"'"'Invalid epoch'"'"')\n return datetime.fromtimestamp(n, timezone.utc).isoformat()\nroot, metadata, output = map(Path, sys.argv[1:])\nroot = root.resolve()\nif not root.is_dir(): raise ValueError('"'"'Need extracted root directory'"'"')\nif output.resolve().is_relative_to(root): raise ValueError('"'"'Output must be outside source tree'"'"')\nfiles = sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file())\nif len(files) > 10000: raise ValueError('"'"'Bounded pilot only: at most 10000 source files'"'"')\nif any(p.is_symlink() for p in root.rglob('"'"'*'"'"')): raise ValueError('"'"'Symlinks unsupported'"'"')\ndef digest(p):\n h = hashlib.sha256()\n with p.open('"'"'rb'"'"') as f:\n for chunk in iter(lambda: f.read(1048576), b'"'"''"'"'): h.update(chunk)\n return h.hexdigest()\ndef snapshot():\n return {str(p.relative_to(root)): (p.stat().st_size, p.stat().st_mtime_ns, digest(p)) for p in files}\nbefore = snapshot()\nmedia = [p for p in files if p.suffix.lower() in {'"'"'.jpg'"'"','"'"'.jpeg'"'"','"'"'.heic'"'"','"'"'.png'"'"','"'"'.gif'"'"','"'"'.mp4'"'"','"'"'.mov'"'"','"'"'.tif'"'"','"'"'.tiff'"'"','"'"'.webp'"'"'}]\nsidecars = [p for p in files if p.suffix.lower() == '"'"'.json'"'"']\ndata = read_json(metadata)\nif not isinstance(data, list): raise ValueError('"'"'Expected ExifTool JSON array'"'"')\nembedded = {}\nfor item in data:\n if not isinstance(item, dict) or not isinstance(item.get('"'"'SourceFile'"'"'), str): raise ValueError('"'"'Missing SourceFile'"'"')\n path = Path(item['"'"'SourceFile'"'"']).resolve()\n if not path.is_relative_to(root): raise ValueError('"'"'Metadata path outside root'"'"')\n if path in embedded: raise ValueError('"'"'Duplicate metadata row'"'"')\n embedded[path] = item\ncandidates = {}\nfor p in media:\n exact = [q for q in sidecars if q.parent == p.parent and q.name in (p.name+'"'"'.json'"'"', p.name+'"'"'.supplemental-metadata.json'"'"')]\n weak = [q for q in sidecars if q.parent == p.parent and q not in exact and len(q.name[:-5]) >= 5 and (p.name.startswith(q.name[:-5]) or q.name.startswith(p.name+'"'"'.s'"'"'))]\n candidates[p] = (exact, weak)\nused = {}\nfor p, (exact, weak) in candidates.items():\n for q in exact + weak: used[q] = used.get(q, 0) + 1\nrows = []\nfor p in media:\n exact, weak = candidates[p]; all_candidates = exact + weak\n state = '"'"'missing'"'"' if not all_candidates else '"'"'ambiguous-truncated'"'"' if weak else '"'"'ambiguous-duplicate'"'"' if len(exact) != 1 or used[exact[0]] != 1 else '"'"'unique'"'"'\n if '"'"'-edited'"'"' in p.stem.lower(): state = '"'"'edited-variant'"'"'\n evidence = []\n for q in all_candidates:\n try:\n value = read_json(q)\n if not isinstance(value, dict): raise ValueError('"'"'Sidecar is not object'"'"')\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'photoTakenTimeUTC'"'"':utc(value.get('"'"'photoTakenTime'"'"')), '"'"'creationTimeUTC'"'"':utc(value.get('"'"'creationTime'"'"')), '"'"'title'"'"':value.get('"'"'title'"'"'), '"'"'error'"'"':'"'"''"'"'})\n except (ValueError, KeyError, OverflowError, OSError, UnicodeError) as e:\n evidence.append({'"'"'path'"'"':str(q.relative_to(root)), '"'"'error'"'"':type(e).__name__})\n state = '"'"'invalid-json'"'"'\n info = embedded.get(p)\n if info is None: embedded_status = '"'"'not-inspected'"'"'\n elif any(k.split('"'"':'"'"')[-1] in ('"'"'Error'"'"','"'"'Warning'"'"') for k in info): embedded_status = '"'"'read-warning-or-error'"'"'\n else: embedded_status = '"'"'record-present-not-capture-proof'"'"'\n rows.append([str(p.relative_to(root)),p.suffix.lower(),str(p.stat().st_size),datetime.fromtimestamp(p.stat().st_mtime,timezone.utc).isoformat(),embedded_status,json.dumps(info or {},ensure_ascii=False),json.dumps(evidence,ensure_ascii=False),state,'"'"'manual-comparison-required'"'"','"'"'No metadata write authorized'"'"'])\nif sorted(p for p in root.rglob('"'"'*'"'"') if p.is_file()) != files or snapshot() != before: raise ValueError('"'"'Source file set/byte/hash/mtime changed; no report created'"'"')\nheader = ['"'"'relative_media_path'"'"','"'"'media_type'"'"','"'"'size_bytes'"'"','"'"'filesystem_mtime_utc'"'"','"'"'embedded_read_status'"'"','"'"'embedded_tags_raw_json'"'"','"'"'candidate_date_evidence_json'"'"','"'"'sidecar_match_status'"'"','"'"'date_source_agreement'"'"','"'"'manual_review_reason'"'"']\nwith output.open('"'"'x'"'"',encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n w=csv.writer(f);w.writerow(header);w.writerows(rows)\nwith output.open(encoding='"'"'utf-8-sig'"'"',newline='"'"''"'"') as f:\n if list(csv.reader(f)) != [header]+rows: raise ValueError('"'"'CSV readback mismatch'"'"')\nprint(len(media),'"'"'media rows; source bytes/hashes/mtimes unchanged; no metadata written'"'"')\n")' "Takeout" "embedded.json" "takeout-audit.csv"
Interpreta las coincidencias y fechas sin adivinar
Las diez columnas son relative_media_path, media_type, size_bytes, filesystem_mtime_utc, embedded_read_status, embedded_tags_raw_json, candidate_date_evidence_json, sidecar_match_status, date_source_agreement y manual_review_reason. Las rutas relativas distinguen nombres repetidos en carpetas distintas. El JSON incrustado sin resumir conserva las etiquetas y desplazamientos disponibles; un registro ausente es not-inspected y una advertencia o error no equivale a una fecha de captura verificada.
En el mismo directorio, los candidatos exactos son el nombre completo del medio más .json o .supplemental-metadata.json. Los candidatos débiles incluyen un nombre base JSON de al menos cinco caracteres que sea prefijo del medio, o formas abreviadas con sufijo .s…. Se conservan todos los candidatos y sus errores de análisis. Más de un candidato exacto es ambiguous-duplicate; cualquier candidato débil produce ambiguous-truncated; un nombre con -edited es edited-variant; y datos JSON o de fecha inválidos son invalid-json. Pueden escaparse otras variantes: missing solo significa que estas reglas no encontraron candidato, no que el auxiliar no exista.
unique solo indica que, bajo estas reglas limitadas, hay un candidato exacto que ninguna otra fila comparte. No demuestra que su contenido pertenezca a esa foto. Los epoch photoTakenTime y creationTime del JSON se muestran por separado en UTC y no se elige ninguno como fecha correcta. Todas las filas siguen como manual-comparison-required: una hora local EXIF sin zona fiable no puede compararse como instante exacto. Conserva el texto y desplazamiento originales y revisa título, contenido visual, contexto del álbum y zona antes de proponer cambios.
Valida la cobertura y separa la reparación
El número de medios informado debe ser igual al número de archivos descubiertos con las extensiones indicadas. Como un campo puede contener saltos de línea, no cuentes registros CSV como líneas físicas de texto. Abre una muestra de cada rama relevante: imagen fija, vídeo, versión editada, nombre duplicado y nombre no ASCII. Examina juntos el medio real y su auxiliar. Los registros incrustados no inspeccionados o con errores y los candidatos débiles, ausentes, editados o inválidos requieren revisión manual.
Importa el CSV como UTF-8, separado por comas y con comillas dobles rectas. Define todas las columnas como texto y desactiva la evaluación de fórmulas y el recorte automático para no alterar nombres ni pruebas sin resumir. Conserva los JSON y CSV maestros y anota solo una copia de trabajo. Si falla el análisis, el hash, la escritura o la relectura, descarta la salida parcial, investiga el origen y elige otro nombre de informe. Este CSV no es un archivo de importación de ExifTool y no puede actualizar metadatos.
Dieciséis casos sintéticos ejecutados realmente en Linux Bash cubrieron nombres exactos antiguos y nuevos, ausencias y candidatos competidores, truncamiento compartido, nombres editados, JSON malformado o con claves duplicadas, epoch inválido, rutas con Unicode, comas o saltos, nombres repetidos en carpetas distintas, vídeo no inspeccionado, errores de lectura y exportación vacía. Se rechazaron además dieciséis intentos de sobrescritura; bytes, hashes y mtime de origen no cambiaron. No se probaron archivos reales, ExifTool, GUI ni una migración. Un plan de reparación posterior debe identificar el subconjunto exacto, campo de origen, etiquetas de destino por formato, copia de seguridad y reversión, y verificar las escrituras en copias. Que una carpeta se ordene bien en una aplicación no demuestra una migración correcta.