科技 · 實用指南
GitHub ZIP裡只有LFS指標?捨棄複本前先核驗指定檔案的真實內容
ZIP下載成功也可能只有LFS指標。用可信提交中的指標核對封存指定成員的解壓後位元組,並把單檔匹配與整個儲存庫備份完成分開判斷。
GitHub原始碼ZIP預設包含Git LFS指標。儲存庫管理員可以選擇納入大型檔案物件,但已提交的追蹤規則和LFS儲存位置仍會影響結果。因此,能成功開啟下載封存,不代表大型檔案內容已經齊全。
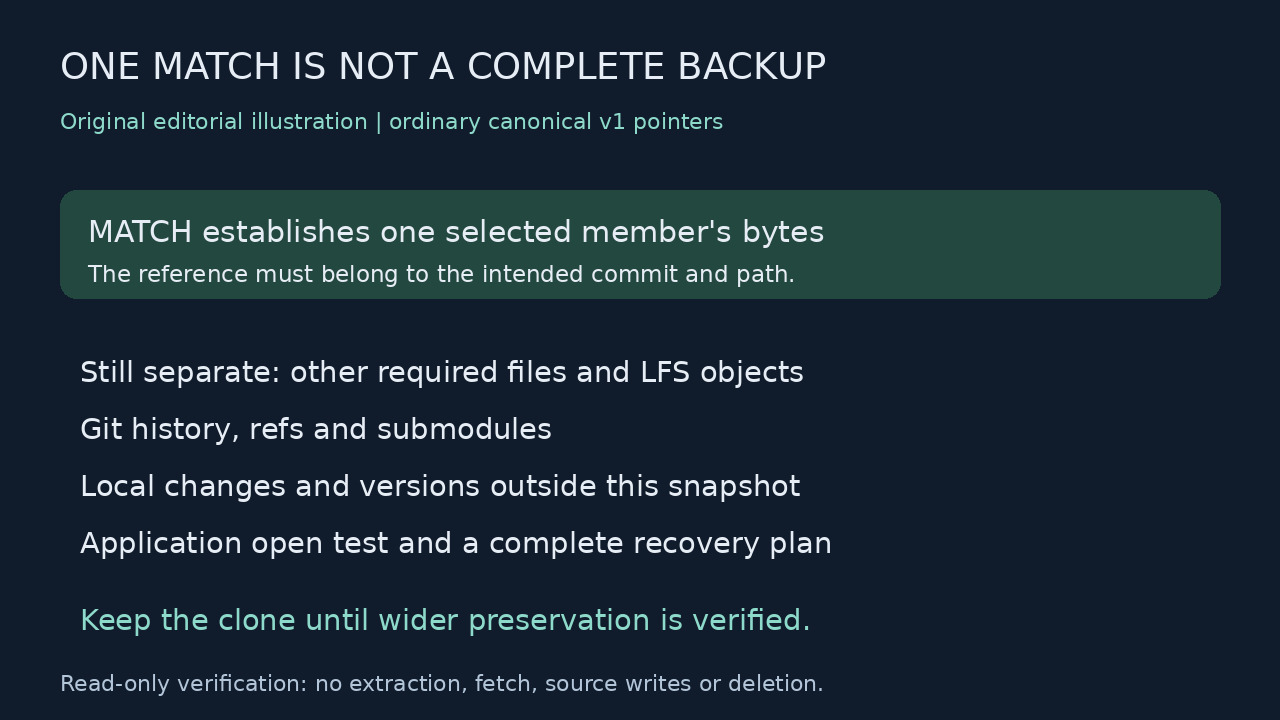
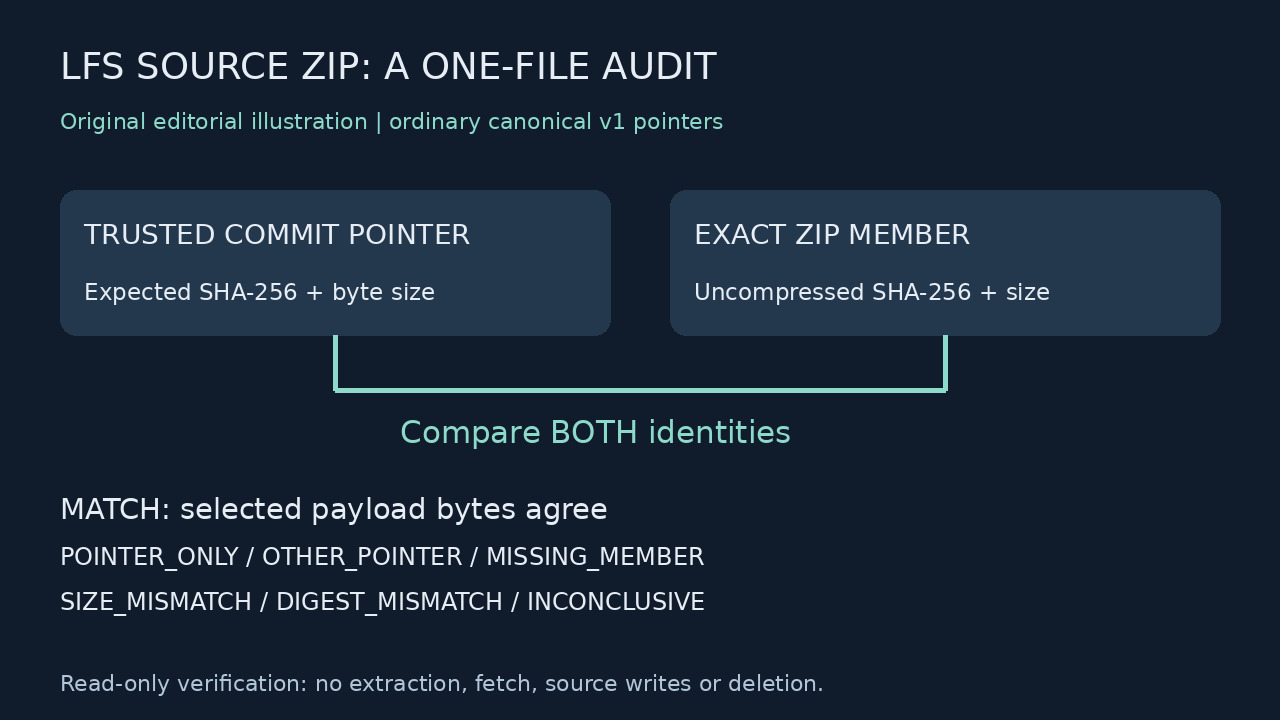
本指南回答一個較窄而實用的問題:ZIP裡這個指定檔案,是否匹配你預計使用版本所提交的普通LFS指標?唯讀Python核驗器比較解壓後大小與SHA-256,回報指標和不匹配情況,並保持兩個輸入不變。即使得到MATCH,也不能據此認定整個複本可以捨棄。
1. 將封存策略與複本故障分開
GitHub的Settings → Archives選項可將Git LFS物件納入產生的原始碼封存。追蹤規則必須已提交到.gitattributes。如果.lfsconfig指向外部LFS伺服器,該選項不會納入這些檔案。
這些是儲存庫端的封存條件。在本機安裝LFS或向複本擷取物件,不會改寫已下載的ZIP。自行上傳的發行附件,也與GitHub自動產生的原始碼快照屬於不同製品。
調查期間保留現有複本與原始ZIP。原始碼快照不保存完整Git歷史;這項單成員檢查也不涵蓋未提交檔案或你可能需要的其他版本。
2. 固定目標版本與精確成員
記錄目標完整提交ID和儲存庫相對路徑,例如assets/model.bin。會移動的分支名稱,或較新版本的工作目錄檔案,都不適合充當舊ZIP的參考。如果無法確定目標提交,結果仍未核實。
不解壓列出ZIP:python -m zipfile -l source.zip。複製精確成員名稱,包含封存頂層前綴,例如project-commit/assets/model.bin。不要假設成員前綴與儲存庫路徑相同。
核驗時固定輸入副本,不讓它們繼續變動。核驗器不會解析重新命名、在重複成員中挑選,也不會推斷封存對應哪個標籤。只有參考確屬你要的版本和檔案,位元組匹配才有意義。
3. 讀取已提交指標,而非工作目錄的大型檔案
在保留的複本中執行下面的準備程式碼。替換FULL_COMMIT、儲存庫路徑和輸出目的地;目的地父目錄必須存在,檔案必須是新的。git cat-file blob讀取已提交的原始blob。輔助程式碼等Git成功後才建立參考檔,並以排他二進位模式開啟,拒絕覆寫既有檔案。
```python import subprocess from pathlib import Path blob = subprocess.check_output([ "git", "cat-file", "blob", "FULL_COMMIT:assets/model.bin" ]) with Path("/outside-clone/expected.pointer").open("xb") as output: output.write(blob) ```
隨後執行git lfs pointer --check --strict --file=/outside-clone/expected.pointer,並檢查退出碼。有效規範指標回傳0,非指標回傳1,strict檢查下不規範指標回傳2。失敗應觸發對參考的檢查,而不是編輯它直到通過。
參考必須是普通三行v1形式:版本URL、包含完整小寫摘要的oid sha256,以及以位元組計的size,並保留LF行尾。此工具刻意排除含擴充及舊版形式。空的已提交blob也不是本工具需要的普通三行參考。
4. 執行有邊界的單檔核驗
將完整程式碼儲存為lfs_zip_audit.py。執行python lfs_zip_audit.py /outside-clone/expected.pointer source.zip "project-commit/assets/model.bin"。程式不解壓成員,只讀取指定項目,對解壓後資料流計算摘要,並將位元組長度和SHA-256都與參考比較。
預設單檔讀取預算為2 GiB。較大檔案會得到INCONCLUSIVE,除非你有足夠資源,並明確選用合適的--max-bytes值。100,000成員上限在ZIP目錄解析後檢查,是適用範圍限制,不是對惡意封存提供沙箱的保證。
```python """Read-only single-member ZIP audit against a trusted canonical v1 LFS pointer.""" import argparse import hashlib import json import re import stat import zipfile import zlib from pathlib import Path POINTER = re.compile(rb'version https://git-lfs.github.com/spec/v1\noid sha256:([0-9a-f]{64})\nsize (0|[1-9][0-9]*)\n') def parse_pointer(data): if len(data) >= 1024: raise ValueError('reference is outside the pointer-size scope') match = POINTER.fullmatch(data) if not match: raise ValueError('requires an ordinary canonical three-line v1 pointer; extensions, legacy and noncanonical forms are outside scope') return match[1].decode('ascii'), int(match[2]) def regular(path): path = Path(path) if not stat.S_ISREG(path.lstat().st_mode): raise ValueError('input must be a regular file, not a symlink or directory') return path def audit(pointer_path, archive_path, member_name, max_bytes=2*1024**3): if max_bytes < 0: raise ValueError('max_bytes must be nonnegative') pointer_path, archive_path = regular(pointer_path), regular(archive_path) with pointer_path.open('rb') as stream: reference = stream.read(1024) expected_sha, expected_size = parse_pointer(reference) if expected_size > max_bytes: raise ValueError('expected payload exceeds the selected read budget') parts = member_name.split('/') if not member_name or '\\' in member_name or '\x00' in member_name or any(p in ('', '.', '..') for p in parts): raise ValueError('use the exact safe slash-separated member name including its archive prefix') with zipfile.ZipFile(archive_path) as archive: infos = archive.infolist() if len(infos) > 100000: raise ValueError('too many ZIP members for this audit scope') matches = [i for i in infos if i.filename == member_name] if not matches: return {'status':'MISSING_MEMBER','member':member_name} if len(matches) != 1: raise ValueError('duplicate exact member name; no unambiguous selection') info = matches[0] mode = stat.S_IFMT(info.external_attr >> 16) if info.is_dir() or mode not in (0, stat.S_IFREG): raise ValueError('member must be a regular file, not a link or directory') if info.flag_bits & 1: raise ValueError('encrypted ZIP members are outside scope') if info.file_size > max_bytes: raise ValueError('ZIP member exceeds the selected read budget') digest, size, prefix = hashlib.sha256(), 0, bytearray() with archive.open(info, 'r') as stream: while True: block = stream.read(1024*1024) if not block: break size += len(block) if size > max_bytes: raise ValueError('stream exceeded the selected read budget') digest.update(block) if len(prefix) < 1024: prefix.extend(block[:1024-len(prefix)]) actual_sha = digest.hexdigest() if size == expected_size and actual_sha == expected_sha: status = 'MATCH' else: try: found = parse_pointer(bytes(prefix)) if size < 1024 else None except ValueError: found = None if found == (expected_sha, expected_size): status = 'POINTER_ONLY' elif found: status = 'OTHER_POINTER' else: status = 'SIZE_MISMATCH' if size != expected_size else 'DIGEST_MISMATCH' return {'status':status,'member':member_name,'expectedBytes':expected_size,'actualBytes':size,'expectedSha256':expected_sha,'actualSha256':actual_sha} def main(): parser = argparse.ArgumentParser(description=__doc__) parser.add_argument('pointer');parser.add_argument('zip');parser.add_argument('member') parser.add_argument('--max-bytes',type=int,default=2*1024**3) args = parser.parse_args() try: result = audit(args.pointer,args.zip,args.member,args.max_bytes) except (OSError,ValueError,RuntimeError,EOFError,zlib.error,zipfile.BadZipFile,NotImplementedError) as exc: result = {'status':'INCONCLUSIVE','reason':str(exc)} print(json.dumps(result,ensure_ascii=False)) return 0 if result['status']=='MATCH' else 2 if result['status']=='INCONCLUSIVE' else 1 if __name__=='__main__': raise SystemExit(main()) ```
核驗器沒有網路呼叫、下載、checkout、來源檔案寫入或刪除命令,只將JSON結果輸出到stdout。若儲存報告,使用來源輸入之外的新目的地;不要將私有路徑或物件身分貼到公開求助文章。
5. 先解釋全部結果,再決定下一步
MATCH:成員解壓後大小與摘要均匹配可信指標。這證明約定範圍內指定內容的位元組身分,並不證明整個封存完整、參考可信性已獨立建立,或檔案可以安全執行。
POINTER_ONLY:成員仍是同一個普通指標,而非預期內容。OTHER_POINTER:它指向另一個物件。MISSING_MEMBER:精確名稱不存在;先重查前綴與目標版本。
SIZE_MISMATCH與DIGEST_MISMATCH分別表示長度和內容不匹配。INCONCLUSIVE涵蓋不支援的參考、重複名稱、連結、加密、讀取預算及ZIP讀取錯誤;它不是零錯誤成功,也不是強制解壓指令。
結果 | 已建立的事實 | 安全下一步 MATCH | 一個指定成員匹配可信OID與大小 | 用目標應用測試檔案,另行擴展涵蓋範圍 POINTER_ONLY | ZIP仍包含預期指標 | 核查封存納入策略,或經正常授權LFS途徑取得指定內容 OTHER_POINTER | 指向不同物件 | 擷取前核對提交、路徑和封存版本 MISSING_MEMBER | 未找到精確成員名稱 | 重查前綴與版本,不悄悄替換同名檔案 SIZE_MISMATCH / DIGEST_MISMATCH | 位元組不匹配參考 | 保留兩個輸入,解決身分或完整性問題 INCONCLUSIVE | 無受支援且明確的結果 | 處理所報限制,保留輸入與複本
6. 只看大小或類似指標的文字都不夠
兩個內容不同的檔案可能有相同位元組長度,因此檔名和大小不能代替指標SHA-256所確定的身分。等長但錯誤的內容會被核驗器回報為DIGEST_MISMATCH。
反過來,真實內容本身也可能包含指標樣式文字。核驗器先比較預期大小與摘要,再判斷小型文字成員是不是指標;若這種文字內容確實匹配預期身分,結果仍為MATCH。
LFS擴充可能在clean和smudge過程中轉換儲存位元組。此時主OID可能指向經過轉換的儲存內容,而非最終工作目錄位元組。普通指標工具遇到擴充會停止,避免將有效轉換後檔案誤判為損壞。
7. 明確實際測試範圍
精確4,500位元組腳本、SHA-256 cad7c90e22c622e8e65d7d50d2a6cb7c119718978e8f00caa4e5523aa8e9a460,在Python 3.12.14/Linux通過36項合成斷言。涵蓋正確內容、指標與不同指標、大小與摘要失敗、Unicode成員、錯誤前綴、重複名稱、輸入與成員連結、不支援參考、預算、CRC損壞及加密成員拒絕。
另有本機準備檢查驗證已提交原始指標擷取、排他建立參考檔、拒絕覆寫,以及Git LFS 3.4.1的規範指標檢查。唯讀核驗前後輸入位元組未變。這些均為暫存合成樣例,不是對你的儲存庫、雲端額度或封存設定的測試。
真實交接時保留目標提交、儲存庫路徑、精確成員名稱、參考摘要與大小、實際摘要與大小、核驗狀態,以及目標應用開啟測試。涵蓋不完整或環境不同,仍屬於待核實事項。
8. 單檔核驗與備份完成分開判斷
驗證一個模型或媒體檔案是一項有用結果。刪除任何複本前,還要分別確認全部必要檔案、Git歷史與refs、子模組、本機改動及快照之外的版本。原始碼ZIP與複本具有不同保全範圍。
若ZIP只有指標,官方封存設定可能解釋原因。若正常LFS途徑無法取得物件,保留已知完好的本機副本,並與儲存庫所有者解決存取或可用性問題。反覆下載同一個只有指標的快照,不會恢復真實內容。
常見問題
啟用Include Git LFS objects會修好舊ZIP嗎? 不會。應檢查新產生封存及對應追蹤、儲存條件。已下載ZIP的位元組不變。
git lfs fetch會改變既有ZIP裡的檔案嗎? 不會。向複本擷取物件與核驗封存成員是兩項獨立操作。
可以使用從另一個分支複製的指標嗎? 只有獨立確認它指向此處預期的確切內容才行。優先使用目標完整提交中的指標,並記錄其身分。
一個MATCH就可以刪掉複本嗎? 不可以。它只證明一個成員的位元組,不涵蓋歷史、其他LFS物件、本機工作或完整復原計畫。
指標包含擴充行怎麼辦? 停止使用本核驗器。擴充感知核驗需要相關轉換和身分;不要刪除擴充行來強求匹配。