科技 · 实用指南
GitHub ZIP里只有LFS指针?丢弃克隆前先核验指定文件的真实内容
ZIP下载成功也可能只有LFS指针。用可信提交中的指针核对档案指定成员的解压后字节,并把单文件匹配与整个仓库备份完成分开判断。
GitHub源代码ZIP默认包含Git LFS指针。仓库管理员可以选择将大文件对象纳入,但已提交的跟踪规则和LFS存储位置仍会影响结果。因此,能成功打开下载档案,不等于大文件内容已经齐全。
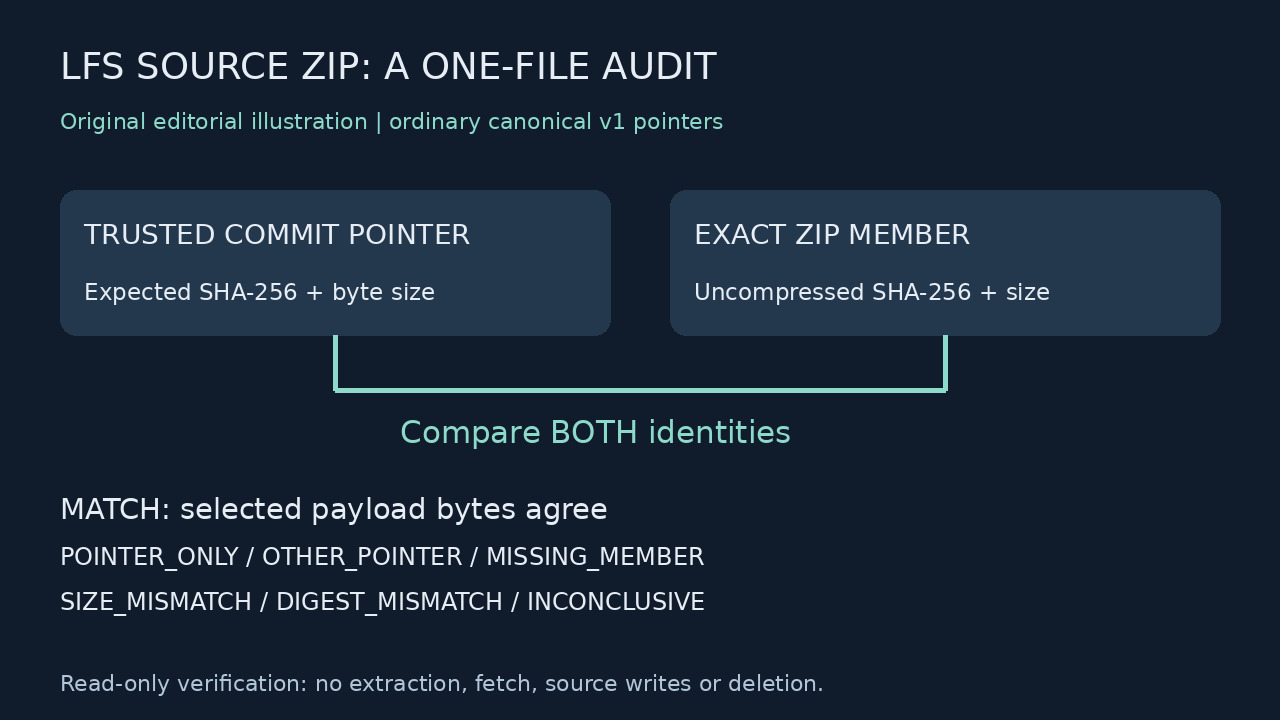
本指南回答一个更窄而实用的问题:ZIP里的这个指定文件,是否匹配你计划使用版本所提交的普通LFS指针?只读Python核验器比较解压后的大小与SHA-256,报告指针和不匹配情况,并保持两个输入不变。即使得到MATCH,也不能据此认定整个克隆可以丢弃。
1. 将档案策略与克隆故障分开
GitHub的Settings → Archives选项可将Git LFS对象纳入生成的源代码档案。跟踪规则必须已提交到.gitattributes。如果.lfsconfig指向外部LFS服务器,该选项不会纳入这些文件。
这些是仓库端的档案条件。在本机安装LFS或向克隆拉取对象,不会改写已经下载的ZIP。自行上传的发布附件,也与GitHub自动生成的源代码快照属于不同制品。
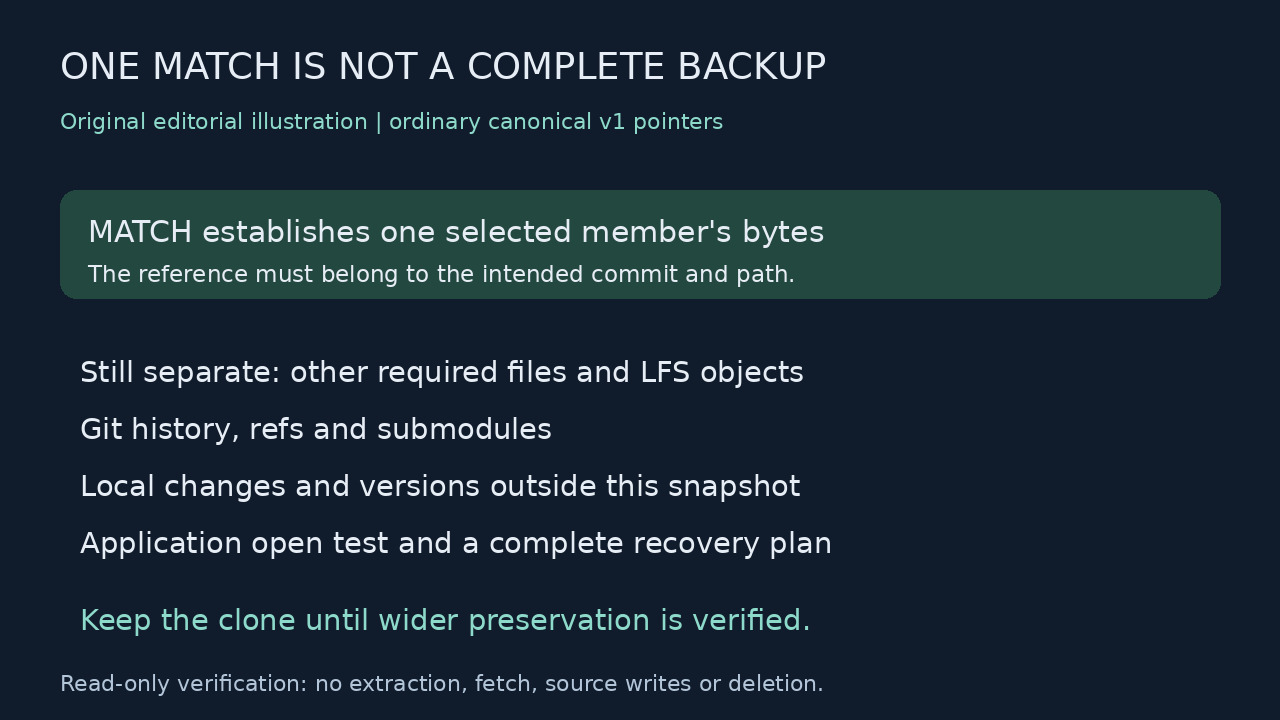
调查期间保留现有克隆和原始ZIP。源代码快照不保存完整Git历史;这项单成员检查也不涵盖未提交文件或你可能需要的其他版本。
2. 固定目标版本与精确成员
记录目标完整提交ID和仓库相对路径,例如assets/model.bin。会移动的分支名,或较新版本的工作区文件,都不适合充当旧ZIP的参考。如果无法确定目标提交,结果仍未核实。
不解压列出ZIP:python -m zipfile -l source.zip。复制精确成员名,包含档案顶层前缀,例如project-commit/assets/model.bin。不要假设成员前缀与仓库路径相同。
核验时固定输入副本,不让它们继续变化。核验器不会解析重命名、在重复成员中挑选,也不会推断档案对应哪个标签。只有参考确属你要的版本和文件,字节匹配才有意义。
3. 读取已提交指针,而非工作区的大文件
在保留的克隆中执行下面的准备代码。替换FULL_COMMIT、仓库路径和输出目的地;目的地父目录必须存在,文件必须是新的。git cat-file blob读取已提交的原始blob。辅助代码等Git成功后才创建参考文件,并以排他二进制模式打开,拒绝覆盖已有文件。
```python import subprocess from pathlib import Path blob = subprocess.check_output([ "git", "cat-file", "blob", "FULL_COMMIT:assets/model.bin" ]) with Path("/outside-clone/expected.pointer").open("xb") as output: output.write(blob) ```
随后运行git lfs pointer --check --strict --file=/outside-clone/expected.pointer,并检查退出码。有效规范指针返回0,非指针返回1,strict检查下不规范指针返回2。失败应当触发对参考的检查,而不是编辑它直到通过。
参考必须是普通三行v1形式:版本URL、包含完整小写摘要的oid sha256,以及以字节计的size,并保留LF行尾。此工具有意排除含扩展及旧版形式。空的已提交blob也不是本工具需要的普通三行参考。
4. 运行有边界的单文件核验
把完整代码保存为lfs_zip_audit.py。运行python lfs_zip_audit.py /outside-clone/expected.pointer source.zip "project-commit/assets/model.bin"。程序不解压成员,只读取指定条目,对解压后的数据流计算摘要,并将字节长度和SHA-256都与参考比较。
默认单文件读取预算为2 GiB。更大文件会得到INCONCLUSIVE,除非你有足够资源,并明确选用合适的--max-bytes值。100,000成员上限在ZIP目录解析后检查,是适用范围限制,不是对恶意档案提供沙箱的保证。
```python """Read-only single-member ZIP audit against a trusted canonical v1 LFS pointer.""" import argparse import hashlib import json import re import stat import zipfile import zlib from pathlib import Path POINTER = re.compile(rb'version https://git-lfs.github.com/spec/v1\noid sha256:([0-9a-f]{64})\nsize (0|[1-9][0-9]*)\n') def parse_pointer(data): if len(data) >= 1024: raise ValueError('reference is outside the pointer-size scope') match = POINTER.fullmatch(data) if not match: raise ValueError('requires an ordinary canonical three-line v1 pointer; extensions, legacy and noncanonical forms are outside scope') return match[1].decode('ascii'), int(match[2]) def regular(path): path = Path(path) if not stat.S_ISREG(path.lstat().st_mode): raise ValueError('input must be a regular file, not a symlink or directory') return path def audit(pointer_path, archive_path, member_name, max_bytes=2*1024**3): if max_bytes < 0: raise ValueError('max_bytes must be nonnegative') pointer_path, archive_path = regular(pointer_path), regular(archive_path) with pointer_path.open('rb') as stream: reference = stream.read(1024) expected_sha, expected_size = parse_pointer(reference) if expected_size > max_bytes: raise ValueError('expected payload exceeds the selected read budget') parts = member_name.split('/') if not member_name or '\\' in member_name or '\x00' in member_name or any(p in ('', '.', '..') for p in parts): raise ValueError('use the exact safe slash-separated member name including its archive prefix') with zipfile.ZipFile(archive_path) as archive: infos = archive.infolist() if len(infos) > 100000: raise ValueError('too many ZIP members for this audit scope') matches = [i for i in infos if i.filename == member_name] if not matches: return {'status':'MISSING_MEMBER','member':member_name} if len(matches) != 1: raise ValueError('duplicate exact member name; no unambiguous selection') info = matches[0] mode = stat.S_IFMT(info.external_attr >> 16) if info.is_dir() or mode not in (0, stat.S_IFREG): raise ValueError('member must be a regular file, not a link or directory') if info.flag_bits & 1: raise ValueError('encrypted ZIP members are outside scope') if info.file_size > max_bytes: raise ValueError('ZIP member exceeds the selected read budget') digest, size, prefix = hashlib.sha256(), 0, bytearray() with archive.open(info, 'r') as stream: while True: block = stream.read(1024*1024) if not block: break size += len(block) if size > max_bytes: raise ValueError('stream exceeded the selected read budget') digest.update(block) if len(prefix) < 1024: prefix.extend(block[:1024-len(prefix)]) actual_sha = digest.hexdigest() if size == expected_size and actual_sha == expected_sha: status = 'MATCH' else: try: found = parse_pointer(bytes(prefix)) if size < 1024 else None except ValueError: found = None if found == (expected_sha, expected_size): status = 'POINTER_ONLY' elif found: status = 'OTHER_POINTER' else: status = 'SIZE_MISMATCH' if size != expected_size else 'DIGEST_MISMATCH' return {'status':status,'member':member_name,'expectedBytes':expected_size,'actualBytes':size,'expectedSha256':expected_sha,'actualSha256':actual_sha} def main(): parser = argparse.ArgumentParser(description=__doc__) parser.add_argument('pointer');parser.add_argument('zip');parser.add_argument('member') parser.add_argument('--max-bytes',type=int,default=2*1024**3) args = parser.parse_args() try: result = audit(args.pointer,args.zip,args.member,args.max_bytes) except (OSError,ValueError,RuntimeError,EOFError,zlib.error,zipfile.BadZipFile,NotImplementedError) as exc: result = {'status':'INCONCLUSIVE','reason':str(exc)} print(json.dumps(result,ensure_ascii=False)) return 0 if result['status']=='MATCH' else 2 if result['status']=='INCONCLUSIVE' else 1 if __name__=='__main__': raise SystemExit(main()) ```
核验器没有网络调用、下载、checkout、源文件写入或删除命令,只将JSON结果输出到stdout。如果保存报告,使用源输入之外的新目的地;不要将私有路径或对象身份贴到公开求助帖。
5. 先解释全部结果,再决定下一步
MATCH:成员解压后的大小与摘要均匹配可信指针。这证明约定范围内指定内容的字节身份,并不证明整个档案完整、参考可信性已独立建立,或文件可以安全执行。
POINTER_ONLY:成员仍是同一个普通指针,并非预期内容。OTHER_POINTER:它指向另一个对象。MISSING_MEMBER:精确名称不存在;先重查前缀与目标版本。
SIZE_MISMATCH与DIGEST_MISMATCH分别表示长度和内容不匹配。INCONCLUSIVE涵盖不支持的参考、重复名、链接、加密、读取预算及ZIP读取错误;它不是零错误成功,也不是强制解压指令。
结果 | 已建立的事实 | 安全下一步 MATCH | 一个指定成员匹配可信OID与大小 | 用目标应用测试文件,另行扩展覆盖范围 POINTER_ONLY | ZIP仍包含预期指针 | 核查档案纳入策略,或经正常授权LFS路径取得指定内容 OTHER_POINTER | 指向不同对象 | 拉取前核对提交、路径和档案版本 MISSING_MEMBER | 未找到精确成员名 | 重查前缀与版本,不悄悄替换同名文件 SIZE_MISMATCH / DIGEST_MISMATCH | 字节不匹配参考 | 保留两个输入,解决身份或完整性问题 INCONCLUSIVE | 无受支持且明确的结果 | 处理所报限制,保留输入与克隆
6. 仅看大小或类似指针的文字都不够
两个内容不同的文件可能有相同字节长度,因此文件名和大小不能代替指针SHA-256所确定的身份。等长但错误的内容会被核验器报告为DIGEST_MISMATCH。
反过来,真实内容本身也可能包含指针样式的文字。核验器先比较预期大小与摘要,再判断小文本成员是不是指针;若这种文字内容确实匹配预期身份,结果仍为MATCH。
LFS扩展可能在clean和smudge过程中转换存储字节。这时主OID可能指向经过转换的存储内容,而非最终工作区字节。普通指针工具遇到扩展会停止,避免把有效的转换后文件误判为损坏。
7. 明确实际测试范围
精确4,500字节脚本、SHA-256 cad7c90e22c622e8e65d7d50d2a6cb7c119718978e8f00caa4e5523aa8e9a460,在Python 3.12.14/Linux通过36项合成断言。覆盖正确内容、指针与不同指针、大小与摘要失败、Unicode成员、错误前缀、重复名、输入与成员链接、不支持参考、预算、CRC损坏与加密成员拒绝。
另有本地准备检查验证已提交原始指针提取、排他创建参考文件、拒绝覆盖,以及Git LFS 3.4.1的规范指针检查。只读核验前后输入字节未变。这些均为临时合成样例,不是对你的仓库、云额度或档案设置的测试。
真实交接时保留目标提交、仓库路径、精确成员名、参考摘要与大小、实际摘要与大小、核验状态,以及目标应用打开测试。覆盖不完整或环境不同,仍属于待核实事项。
8. 单文件核验与备份完成分开判断
验证一个模型或媒体文件是一项有用结果。删除任何克隆前,还要分别确认全部必要文件、Git历史与refs、子模块、本地改动及快照之外的版本。源代码ZIP与克隆具有不同保全范围。
若ZIP只有指针,官方档案设置可能解释原因。若正常LFS路径无法取得对象,保留已知完好的本地副本,并与仓库所有者解决访问或可用性问题。反复下载同一个只有指针的快照,不会恢复真实内容。
常见问题
启用Include Git LFS objects会修好旧ZIP吗? 不会。应检查新生成档案及对应跟踪、存储条件。已经下载的ZIP字节不变。
git lfs fetch会改变现有ZIP里的文件吗? 不会。向克隆拉取对象与核验档案成员是两项独立操作。
可以使用从另一个分支复制的指针吗? 只有独立确认它指向此处预期的确切内容才行。优先使用目标完整提交中的指针,并记录其身份。
一个MATCH就可以删掉克隆吗? 不可以。它只证明一个成员的字节,不涵盖历史、其他LFS对象、本地工作或完整恢复计划。
指针包含扩展行怎么办? 停止使用本核验器。扩展感知核验需要相关转换和身份;不要删除扩展行来强求匹配。