기술 · 실용 가이드
GitHub ZIP에 LFS 포인터만 있나요? 클론을 버리기 전에 정확한 실체 확인
ZIP 다운로드 성공만으로 실체를 입증할 수 없습니다. 신뢰하는 커밋의 포인터로 정확한 한 멤버의 비압축 바이트를 검사하고, 한 파일의 일치와 전체 저장소 백업을 구분하세요.
GitHub 소스 ZIP에는 기본적으로 Git LFS 포인터가 들어갑니다. 관리자는 대용량 객체를 포함하도록 설정할 수 있지만 커밋된 추적 규칙과 LFS 저장 위치도 중요합니다. 다운로드한 파일이 정상적으로 열리는 것만으로는 대용량 실체가 들어 있다고 입증할 수 없습니다.
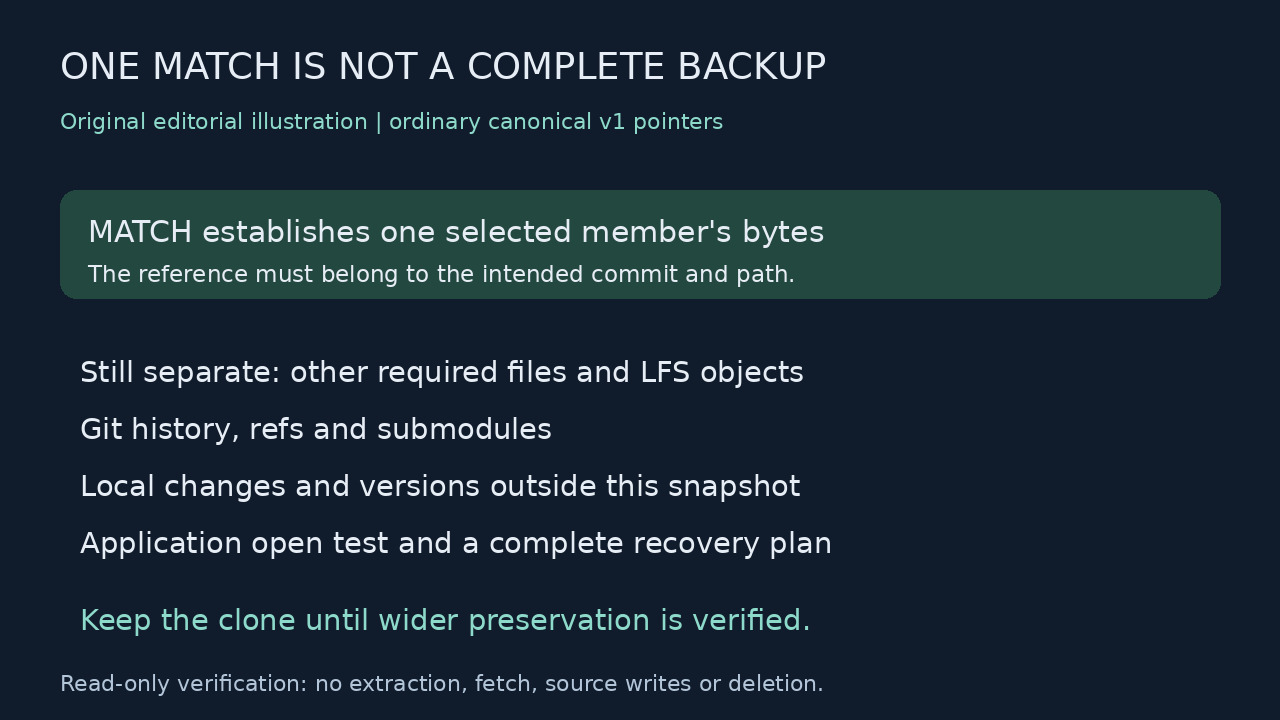
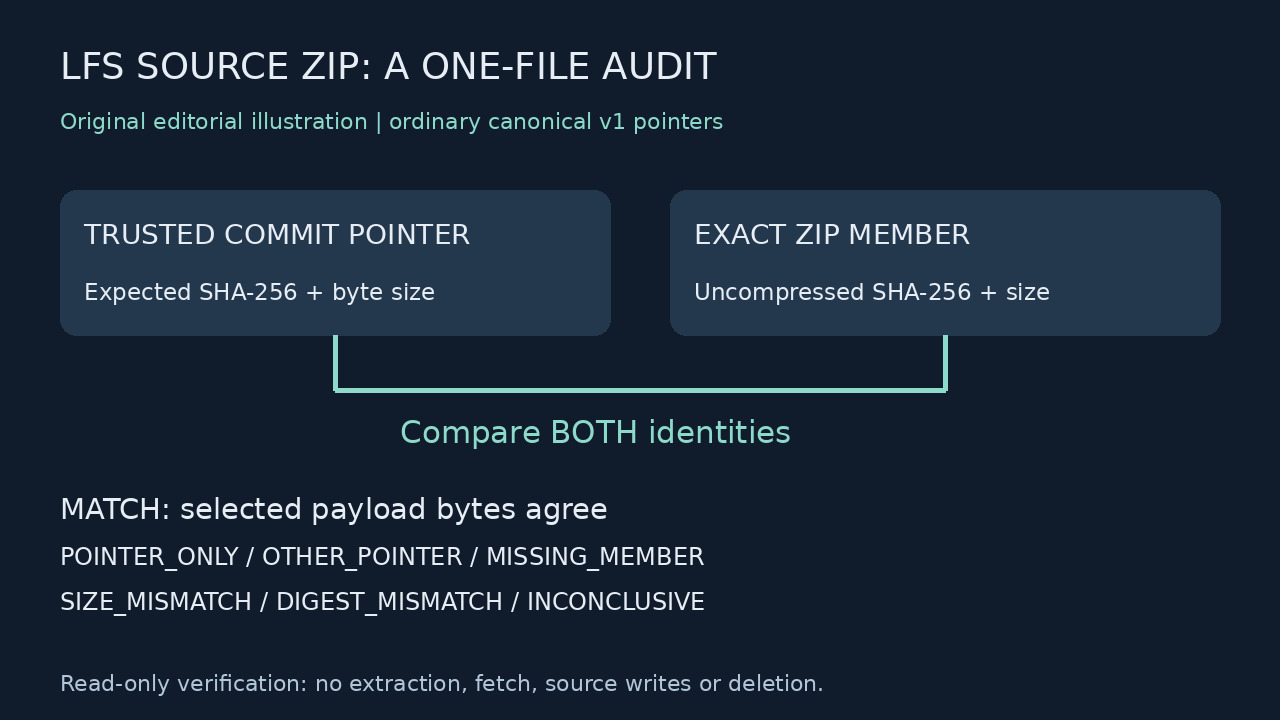
이 가이드는 더 좁고 실용적인 질문을 검사합니다. ZIP의 정확한 한 파일이 의도한 버전에 커밋된 일반 LFS 포인터와 일치하나요? 읽기 전용 Python 검증기가 비압축 크기와 SHA-256을 비교하고 포인터와 불일치를 보고하며 입력을 보존합니다. MATCH도 클론 전체를 버려도 된다는 선언이 아닙니다.
1. 아카이브 설정과 클론 문제를 구분하기
GitHub의 Settings → Archives 설정으로 생성되는 소스 아카이브에 Git LFS 객체를 포함할 수 있습니다. 추적 규칙은 .gitattributes에 커밋되어 있어야 합니다. .lfsconfig로 지정된 외부 LFS 서버의 파일은 이 설정으로 포함되지 않습니다.
이 조건들은 저장소 측 아카이브 조건입니다. 컴퓨터에 LFS를 설치하거나 클론으로 객체를 가져와도 이미 내려받은 ZIP은 바뀌지 않습니다. 별도로 업로드한 릴리스 첨부 파일도 GitHub가 자동 생성하는 소스 스냅샷과는 다른 결과물입니다.
조사하는 동안 기존 클론과 원본 ZIP을 보존하세요. 소스 스냅샷은 Git 전체 이력을 보존하지 않으며, 단일 멤버 검사로 커밋하지 않은 파일이나 필요한 다른 버전까지 확인할 수는 없습니다.
2. 대상 버전과 정확한 멤버 이름 확정하기
대상의 전체 커밋 ID와 assets/model.bin 같은 저장소 상대 경로를 기록하세요. 이동하는 브랜치 이름이나 이후 버전의 작업 트리 파일은 이전 ZIP의 기준으로 적절하지 않습니다. 대상 커밋을 확정할 수 없다면 결과는 미검증 상태입니다.
python -m zipfile -l source.zip으로 압축을 풀지 않고 목록을 확인하세요. project-commit/assets/model.bin처럼 최상위 접두사를 포함한 정확한 멤버 이름을 복사합니다. ZIP 접두사가 저장소 경로와 같다고 가정하지 마세요.
검사 중 입력 복사본을 변경하지 마세요. 이 검증기는 이름이 바뀐 경로를 해결하거나, 중복 이름 중 하나를 선택하거나, ZIP이 어떤 태그인지 추측하지 않습니다. 기준 자체가 의도한 버전과 파일에 속해야 바이트 일치가 의미 있습니다.
3. 체크아웃한 실체 대신 커밋된 포인터 읽기
보존한 클론 안에서 다음 준비를 수행합니다. FULL_COMMIT, 저장소 경로와 출력 위치를 바꾸세요. 출력의 상위 디렉터리는 존재해야 하고 파일은 새 파일이어야 합니다. 형식을 지정한 git cat-file blob은 커밋된 원시 blob을 읽습니다. 보조 코드는 Git이 성공한 후 기준 파일을 만들고 배타적 바이너리 출력을 사용하므로 기존 파일을 덮어쓰지 않습니다.
```python import subprocess from pathlib import Path blob = subprocess.check_output([ "git", "cat-file", "blob", "FULL_COMMIT:assets/model.bin" ]) with Path("/outside-clone/expected.pointer").open("xb") as output: output.write(blob) ```
이어서 git lfs pointer --check --strict --file=/outside-clone/expected.pointer를 실행하고 종료 코드를 확인하세요. 유효한 정규 포인터는 0, 포인터가 아닌 파일은 1, strict 검사에서 비정규 포인터는 2를 반환합니다. 실패하면 기준을 조사해야 하며 통과하도록 임의로 수정해서는 안 됩니다.
기준은 일반적인 v1의 3줄 형식이어야 합니다. version URL, 전체 소문자 다이제스트가 있는 oid sha256, 바이트 수인 size를 LF 줄바꿈으로 기록합니다. 이 검증기는 확장 행과 이전 형식을 의도적으로 제외합니다. 빈 커밋 blob도 이 도구의 일반 3줄 기준이 아닙니다.
4. 범위를 제한한 단일 파일 검사 실행하기
전체 코드를 lfs_zip_audit.py로 저장하고 python lfs_zip_audit.py /outside-clone/expected.pointer source.zip "project-commit/assets/model.bin"을 실행하세요. 압축을 풀지 않고 정확한 멤버를 읽으며 비압축 스트림의 해시를 구해 바이트 길이와 SHA-256을 기준과 비교합니다.
기본 파일별 읽기 한도는 2 GiB입니다. 더 큰 파일은 적절한 --max-bytes를 명시적으로 선택하고 읽을 자원을 확보하지 않으면 INCONCLUSIVE입니다. 100,000개 멤버 제한은 ZIP 디렉터리를 분석한 뒤 적용되는 범위 제한이며, 악성 아카이브용 샌드박스라는 뜻이 아닙니다.
```python """Read-only single-member ZIP audit against a trusted canonical v1 LFS pointer.""" import argparse import hashlib import json import re import stat import zipfile import zlib from pathlib import Path POINTER = re.compile(rb'version https://git-lfs.github.com/spec/v1\noid sha256:([0-9a-f]{64})\nsize (0|[1-9][0-9]*)\n') def parse_pointer(data): if len(data) >= 1024: raise ValueError('reference is outside the pointer-size scope') match = POINTER.fullmatch(data) if not match: raise ValueError('requires an ordinary canonical three-line v1 pointer; extensions, legacy and noncanonical forms are outside scope') return match[1].decode('ascii'), int(match[2]) def regular(path): path = Path(path) if not stat.S_ISREG(path.lstat().st_mode): raise ValueError('input must be a regular file, not a symlink or directory') return path def audit(pointer_path, archive_path, member_name, max_bytes=2*1024**3): if max_bytes < 0: raise ValueError('max_bytes must be nonnegative') pointer_path, archive_path = regular(pointer_path), regular(archive_path) with pointer_path.open('rb') as stream: reference = stream.read(1024) expected_sha, expected_size = parse_pointer(reference) if expected_size > max_bytes: raise ValueError('expected payload exceeds the selected read budget') parts = member_name.split('/') if not member_name or '\\' in member_name or '\x00' in member_name or any(p in ('', '.', '..') for p in parts): raise ValueError('use the exact safe slash-separated member name including its archive prefix') with zipfile.ZipFile(archive_path) as archive: infos = archive.infolist() if len(infos) > 100000: raise ValueError('too many ZIP members for this audit scope') matches = [i for i in infos if i.filename == member_name] if not matches: return {'status':'MISSING_MEMBER','member':member_name} if len(matches) != 1: raise ValueError('duplicate exact member name; no unambiguous selection') info = matches[0] mode = stat.S_IFMT(info.external_attr >> 16) if info.is_dir() or mode not in (0, stat.S_IFREG): raise ValueError('member must be a regular file, not a link or directory') if info.flag_bits & 1: raise ValueError('encrypted ZIP members are outside scope') if info.file_size > max_bytes: raise ValueError('ZIP member exceeds the selected read budget') digest, size, prefix = hashlib.sha256(), 0, bytearray() with archive.open(info, 'r') as stream: while True: block = stream.read(1024*1024) if not block: break size += len(block) if size > max_bytes: raise ValueError('stream exceeded the selected read budget') digest.update(block) if len(prefix) < 1024: prefix.extend(block[:1024-len(prefix)]) actual_sha = digest.hexdigest() if size == expected_size and actual_sha == expected_sha: status = 'MATCH' else: try: found = parse_pointer(bytes(prefix)) if size < 1024 else None except ValueError: found = None if found == (expected_sha, expected_size): status = 'POINTER_ONLY' elif found: status = 'OTHER_POINTER' else: status = 'SIZE_MISMATCH' if size != expected_size else 'DIGEST_MISMATCH' return {'status':status,'member':member_name,'expectedBytes':expected_size,'actualBytes':size,'expectedSha256':expected_sha,'actualSha256':actual_sha} def main(): parser = argparse.ArgumentParser(description=__doc__) parser.add_argument('pointer');parser.add_argument('zip');parser.add_argument('member') parser.add_argument('--max-bytes',type=int,default=2*1024**3) args = parser.parse_args() try: result = audit(args.pointer,args.zip,args.member,args.max_bytes) except (OSError,ValueError,RuntimeError,EOFError,zlib.error,zipfile.BadZipFile,NotImplementedError) as exc: result = {'status':'INCONCLUSIVE','reason':str(exc)} print(json.dumps(result,ensure_ascii=False)) return 0 if result['status']=='MATCH' else 2 if result['status']=='INCONCLUSIVE' else 1 if __name__=='__main__': raise SystemExit(main()) ```
검증기에는 네트워크 호출, 다운로드, 체크아웃, 입력 파일 쓰기나 삭제 명령이 없습니다. 표준 출력에 JSON 결과를 표시합니다. 보고서를 저장한다면 입력 밖의 새 위치를 선택하고 공개 지원 글에 비공개 경로나 객체 식별 정보를 노출하지 마세요.
5. 조작 전에 모든 결과 해석하기
MATCH는 멤버의 비압축 크기와 다이제스트가 신뢰한 포인터와 일치한다는 뜻입니다. 명시한 범위 안에서 선택한 실체의 바이트 동일성을 입증합니다. 전체 아카이브의 완전성, 기준의 진위 또는 파일 실행 안전성을 입증하지는 않습니다.
POINTER_ONLY는 기대한 실체 대신 동일한 일반 포인터가 들어 있다는 뜻입니다. OTHER_POINTER는 다른 객체를 참조합니다. MISSING_MEMBER는 정확한 이름을 찾지 못했다는 뜻이므로 먼저 아카이브 접두사와 대상 버전을 다시 확인하세요.
SIZE_MISMATCH와 DIGEST_MISMATCH는 길이와 내용의 불일치를 구분합니다. INCONCLUSIVE는 지원하지 않는 기준, 중복 이름, 링크, 암호화, 읽기 한도 및 ZIP 읽기 오류 등을 포함합니다. 오류 없는 성공도 아니고 강제 추출 지시도 아닙니다.
결과 | 확인된 사실 | 다음 안전한 단계 MATCH | 한 멤버가 신뢰한 OID 및 크기와 일치 | 사용 앱에서 파일을 확인하고 검증 범위는 별도로 확대 POINTER_ONLY | ZIP에 기대한 포인터만 남아 있음 | 아카이브 포함 정책을 검토하거나 정상적인 권한 있는 LFS 경로로 정확한 실체 확보 OTHER_POINTER | 다른 객체를 참조함 | 가져오기 전에 커밋, 경로, 아카이브 버전 대조 MISSING_MEMBER | 정확한 멤버 이름을 찾지 못함 | 접두사와 버전 재확인, 같은 이름의 파일로 몰래 대체하지 않기 SIZE_MISMATCH / DIGEST_MISMATCH | 바이트가 기준과 다름 | 두 입력을 보존하고 동일성 또는 무결성 문제 해결 INCONCLUSIVE | 지원 범위의 모호하지 않은 판정 없음 | 보고된 제한 해결, 입력과 클론 보존
6. 크기와 포인터처럼 보이는 텍스트만으로 부족한 이유
두 실체의 바이트 길이가 같아도 내용은 다를 수 있습니다. 파일명과 크기는 포인터의 SHA-256 식별 정보를 대신하지 못합니다. 검증기는 같은 크기의 잘못된 실체를 DIGEST_MISMATCH로 보고합니다.
반대로 실체 자체가 포인터처럼 보이는 텍스트일 수도 있습니다. 검증기는 작은 텍스트를 포인터로 분류하기 전에 기대한 크기와 다이제스트를 검사합니다. 따라서 기대한 동일성을 가진 실제 포인터 텍스트 실체도 MATCH를 받습니다.
LFS 확장은 clean과 smudge 과정에서 저장 바이트를 변환할 수 있습니다. 이 경우 주 OID는 최종 작업 트리 바이트가 아닌 변환된 저장 바이트를 식별할 수 있습니다. 일반 포인터용 도구는 확장에 도달하면 중단하며 유효한 변환 파일을 손상으로 판정하지 않습니다.
7. 실제로 테스트한 범위 확인하기
SHA-256이 cad7c90e22c622e8e65d7d50d2a6cb7c119718978e8f00caa4e5523aa8e9a460인 정확한 4,500바이트 스크립트는 Python 3.12.14/Linux에서 36개 합성 검증 항목을 통과했습니다. 정확한 바이트, 포인터만 있는 경우와 다른 포인터, 크기 및 해시 실패, Unicode 멤버, 잘못된 접두사, 중복 이름, 입력 및 멤버 링크, 지원하지 않는 기준, 한도, CRC 손상과 암호화 멤버 거부를 테스트했습니다.
추가 로컬 준비 검사로 커밋된 원시 포인터 추출, 배타적 기준 파일 생성, 덮어쓰기 거부와 Git LFS 3.4.1 정규 포인터 검사를 확인했습니다. 읽기 전용 검사 전후 입력 바이트는 동일했습니다. 임시 합성 데이터 테스트이며 사용자의 저장소, 클라우드 용량이나 아카이브 설정을 시험한 것은 아닙니다.
실제 인계에서는 대상 커밋, 저장소 경로, 정확한 멤버 이름, 기준과 실체의 해시 및 크기, 검사 결과와 앱에서의 열기 테스트를 기록하세요. 불완전한 범위나 다른 환경은 남은 검증 작업으로 처리하세요.
8. 한 파일 검증과 백업 완료 구분하기
모델이나 미디어 한 파일의 검증은 유용한 결과입니다. 클론을 제거하기 전에 필요한 모든 파일, Git 이력과 refs, 서브모듈, 로컬 변경 및 이 스냅샷 밖의 버전을 별도로 확인하세요. 소스 ZIP과 클론은 보존 범위가 다릅니다.
ZIP에 포인터만 있다면 공식 아카이브 설정이 이유를 설명할 수 있습니다. 정상 LFS 경로로 객체를 구할 수 없다면 정상임이 확인된 로컬 복사본을 보존하고 저장소 소유자와 접근 권한이나 가용성을 해결하세요. 같은 포인터 전용 스냅샷을 반복 다운로드해도 실체는 복구되지 않습니다.
자주 묻는 질문
Include Git LFS objects를 켜면 기존 ZIP도 고쳐지나요? 아니요. 새로 생성한 아카이브와 적용되는 추적 및 저장소 조건을 평가해야 합니다. 이미 내려받은 ZIP의 바이트는 변하지 않습니다.
git lfs fetch가 기존 ZIP 안의 파일을 바꾸나요? 아니요. 클론으로 가져오는 작업과 아카이브 멤버 검증은 별개입니다.
다른 브랜치에서 복사한 포인터를 써도 되나요? 여기서 의도한 정확한 실체를 가리킨다고 독립적으로 확인한 경우에만 가능합니다. 대상의 전체 커밋에서 얻은 포인터를 우선 사용하고 식별 정보를 기록하세요.
MATCH 하나면 클론을 삭제해도 되나요? 아니요. 한 멤버의 바이트만 입증하며 이력, 다른 LFS 객체, 로컬 작업 또는 전체 복구 계획을 입증하지 않습니다.
포인터에 확장 행이 있다면 어떻게 하나요? 이 검증기를 중단하세요. 확장을 이해하는 검증에는 적용되는 변환과 식별 정보가 필요합니다. 강제로 맞추려고 행을 제거하지 마세요.