科技 · 實用指南
將 FileZilla 的 MLSD 清單轉為 CSV,保留原檔名
保留名稱中的逗號、分號與有效空格,區分遺漏大小和零值,並在離線副本中保留目錄項目。
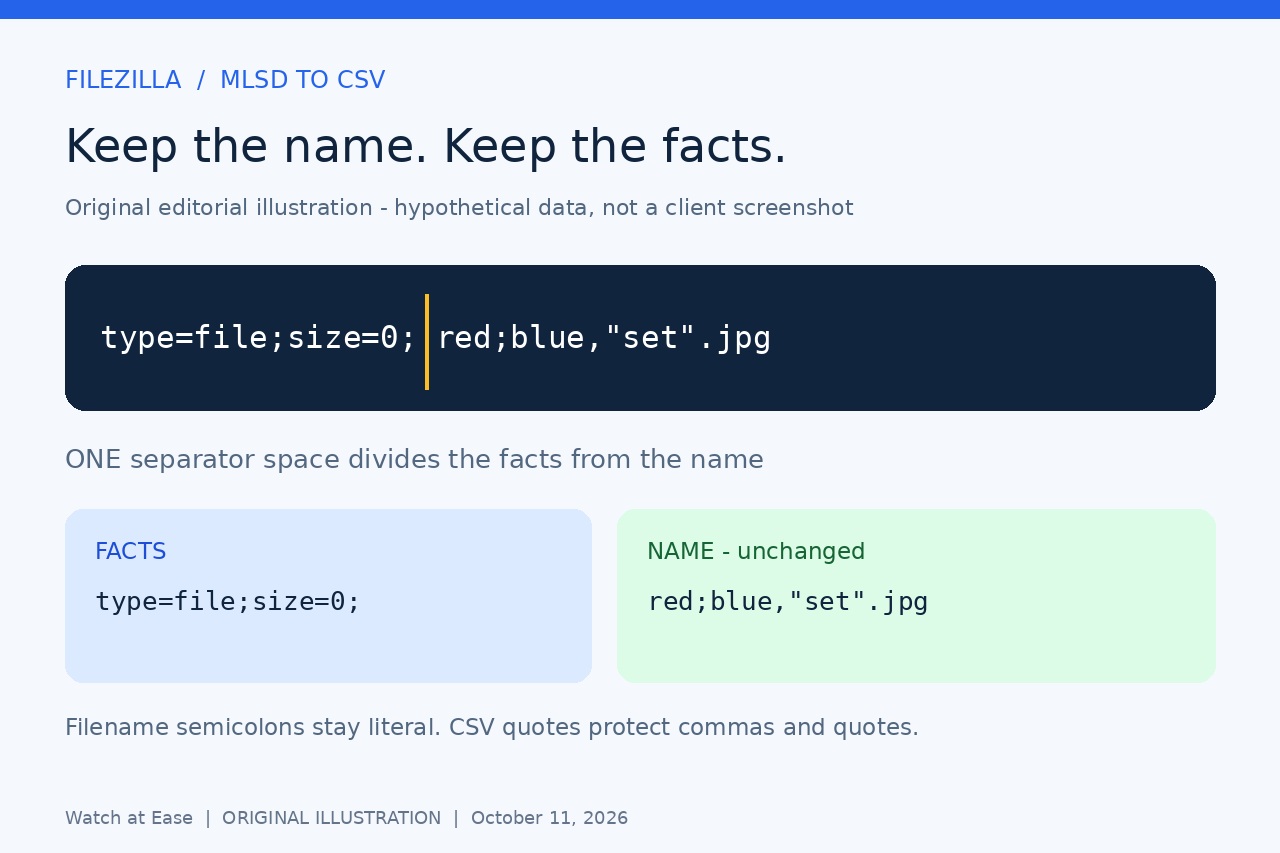
已複製 FileZilla 原始目錄清單時,把所有分號替換成逗號,不是可靠的 CSV 轉換方法。分號可能屬於檔名,而名稱中的逗號或引號需要正確的 CSV 引用處理。
本指南離線轉換單次擷取的 MLSD 資料區塊,保留顯示的名稱、項目類型與原始屬性。它不下載檔案、不更改伺服器、不建立遞迴清單,也不證明擷取清單完整。
先確認複製的是 MLSD 資料
使用已有的合法 FTP 或 FTPS 連線。FileZilla 原支援討論提到在除錯設定中顯示原始目錄清單;若你的版本提供該控制項,可啟用並只重新整理目標資料夾。在紀錄中確認 MLSD 命令及成功完成,另記遠端資料夾與擷取時間。我們未測試目前的 FileZilla 介面。
只把該次成功清單的資料項目複製到 UTF-8 純文字檔 mlsd.txt。典型項目為 type=file;size=926; image.jpg。保留名稱的所有字元,包括開頭與結尾空格。轉換器接受原始項目,或準確的英文前綴 Listing: 後接一個空格;不要混入時間戳記、翻譯後的前綴、狀態訊息或空白分隔行。
若回應是 Unix/DOS LIST 文字、SFTP 清單、CLI JSON 物件、未解碼位元組或明顯亂碼,停止轉換。不要猜測編碼或覆寫原紀錄。現代 FileZilla CLI 也提供結構化 JSON,對已有 CLI 的使用者是有效的另一條路徑,但不是本轉換器的輸入。
在 Linux Bash 終端機轉換副本
在 Linux Bash 終端機使用 Python 3.9 或更新版本,進入 mlsd.txt 所在資料夾。把下一條命令複製為一整行,保留直引號與反斜線,選擇新的輸出名稱。命令先驗證所有輸入紀錄,再獨占建立 mlsd.csv;輸入檔不變。
python3 -c "exec('import csv\\nimport sys\\n\\nrows = []\\nwith open(sys.argv[1], encoding=\"utf-8-sig\", newline=\"\") as source:\\n for number, raw in enumerate(source, 1):\\n line = raw.removesuffix(\"\\\\n\").removesuffix(\"\\\\r\")\\n if line.startswith(\"Listing: \"):\\n line = line[len(\"Listing: \"):]\\n facts, separator, name = line.partition(\" \")\\n if not separator or not name or (facts and not facts.endswith(\";\")):\\n raise ValueError(f\"Line {number}: expected one MLSD data entry\")\\n values = {}\\n for fact in facts[:-1].split(\";\") if facts else []:\\n key, equals, value = fact.partition(\"=\")\\n key = key.lower()\\n if not key or not equals or key in values or any(c.isspace() for c in fact):\\n raise ValueError(f\"Line {number}: malformed or duplicate fact\")\\n values[key] = value\\n size = values.get(\"size\", \"\")\\n if \"size\" in values and not (size.isascii() and size.isdecimal()):\\n raise ValueError(f\"Line {number}: invalid size\")\\n rows.append([name, values.get(\"type\", \"\"), size, values.get(\"modify\", \"\"), facts])\\nif not rows:\\n raise ValueError(\"No MLSD records: do not assume an empty directory\")\\nwith open(sys.argv[2], \"x\", encoding=\"utf-8-sig\", newline=\"\") as destination:\\n writer = csv.writer(destination)\\n writer.writerow([\"name\", \"type\", \"size_bytes\", \"modify_raw\", \"facts_raw\"])\\n writer.writerows(rows)\\nprint(len(rows), \"MLSD records exported; includes any directory entries\")\\n')" "mlsd.txt" "mlsd.csv"
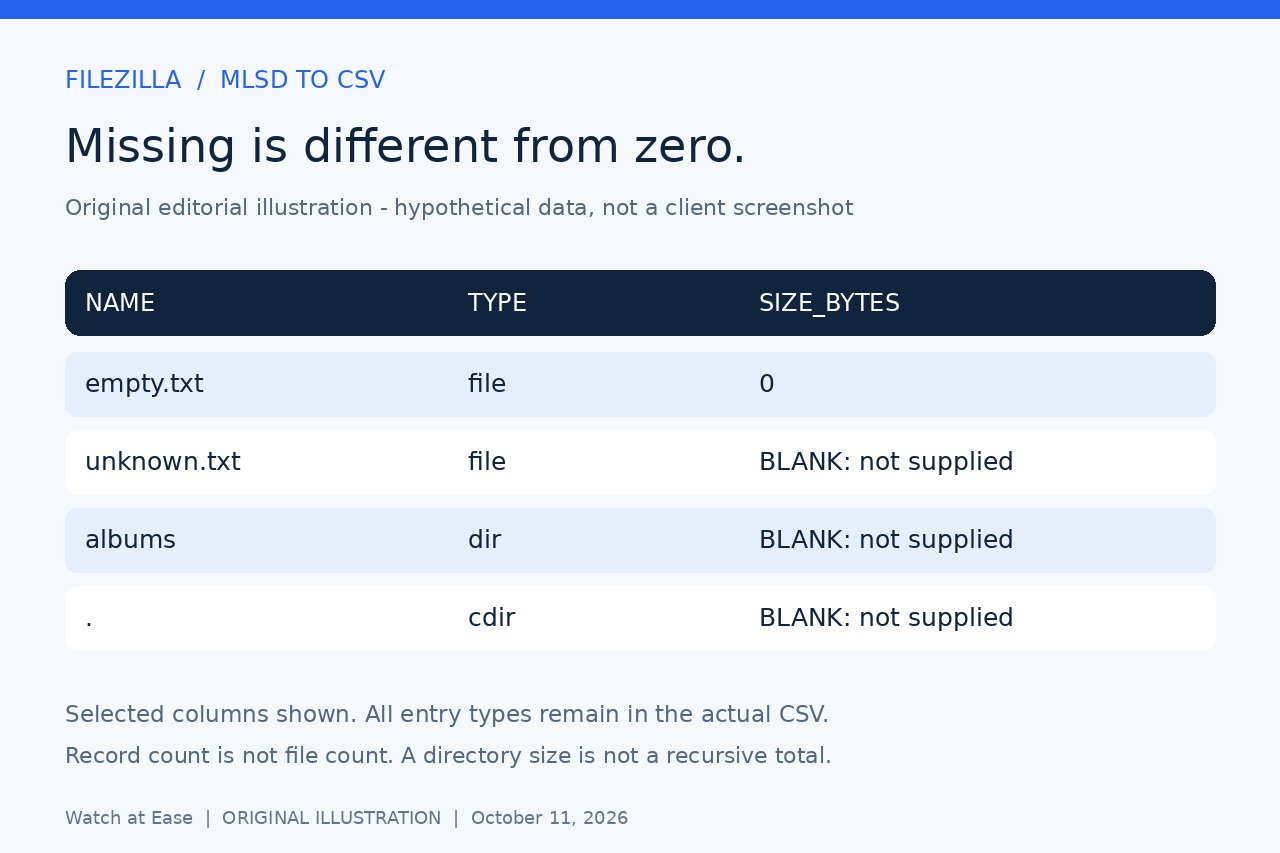
五欄依序為 name、type、size_bytes、modify_raw、facts_raw。第一個空格分開屬性和名稱;後續空格及檔名分號保持原樣。屬性名稱以不區分大小寫方式比對,facts_raw 則保留原拼寫、順序和值。遺漏的大小留空,回傳的零保留為 0。
以文字匯入並核驗擷取紀錄
在 LibreOffice Calc 開啟 CSV,選擇 UTF-8、逗號分隔和直雙引號文字分隔符號。關閉「合併分隔符號」「修剪空格」「計算公式」,五欄都設為「文字」。匯入視窗不出現時,開啟時啟用「編輯篩選器設定」。檢查以 = 開頭的名稱仍是原文字,沒有變成公式。
比較命令印出的數量與解析後的 CSV 資料列數,不含標題列,並對照保存文字核驗多個準確名稱和屬性。保留 cdir、pdir、dir 紀錄:這些描述目錄,因此紀錄數不等於檔案數。遺漏 type 仍是未知。伺服器可能為同一路徑回傳多種類型,因此重複名稱也保留,不自動去除重複。
理解錯誤及中繼資料的證明範圍
空輸入、格式錯誤、重複屬性鍵或無效的已提供大小,會在建立輸出前停止。目標已存在時換新檔名。磁碟或寫入失敗可能留下不完整 CSV;棄用該輸出,換新名稱重跑並核對解析列數。即使伺服器確實沒回傳項目,本轉換器也會主動拒絕認證空清單。
大小是伺服器回報的中繼資料,可能為近似值;遺漏大小不是零,目錄大小不是遞迴總量。modify_raw 保留未轉換的伺服器文字,不證明內容未變。解析器無法偵測複製時遺漏的語法正確列。需自行確認擷取成功、保留原紀錄,並只分享你願意揭露的中繼資料。
我們對該準確 Bash 命令實際執行了 17 項模擬子程序檢查,涵蓋標點、Unicode、有效空格、可選屬性、目錄類型、無效輸入與拒絕覆寫。未執行真實 FileZilla、FTP 伺服器或 Calc 介面,也未測試 Windows 或 macOS。兩張配圖是模擬範例,不是介面截圖。