Tecnología · GUÍA PRÁCTICA
Exportar las fechas de finalización de tareas de Excel desde el historial guardado
Si tu XLSX conserva el historial de tareas asignadas, puedes extraer los eventos de finalización efectivos y sus horas UTC. Este exportador local también indica cuándo el archivo no puede proporcionar esa información.
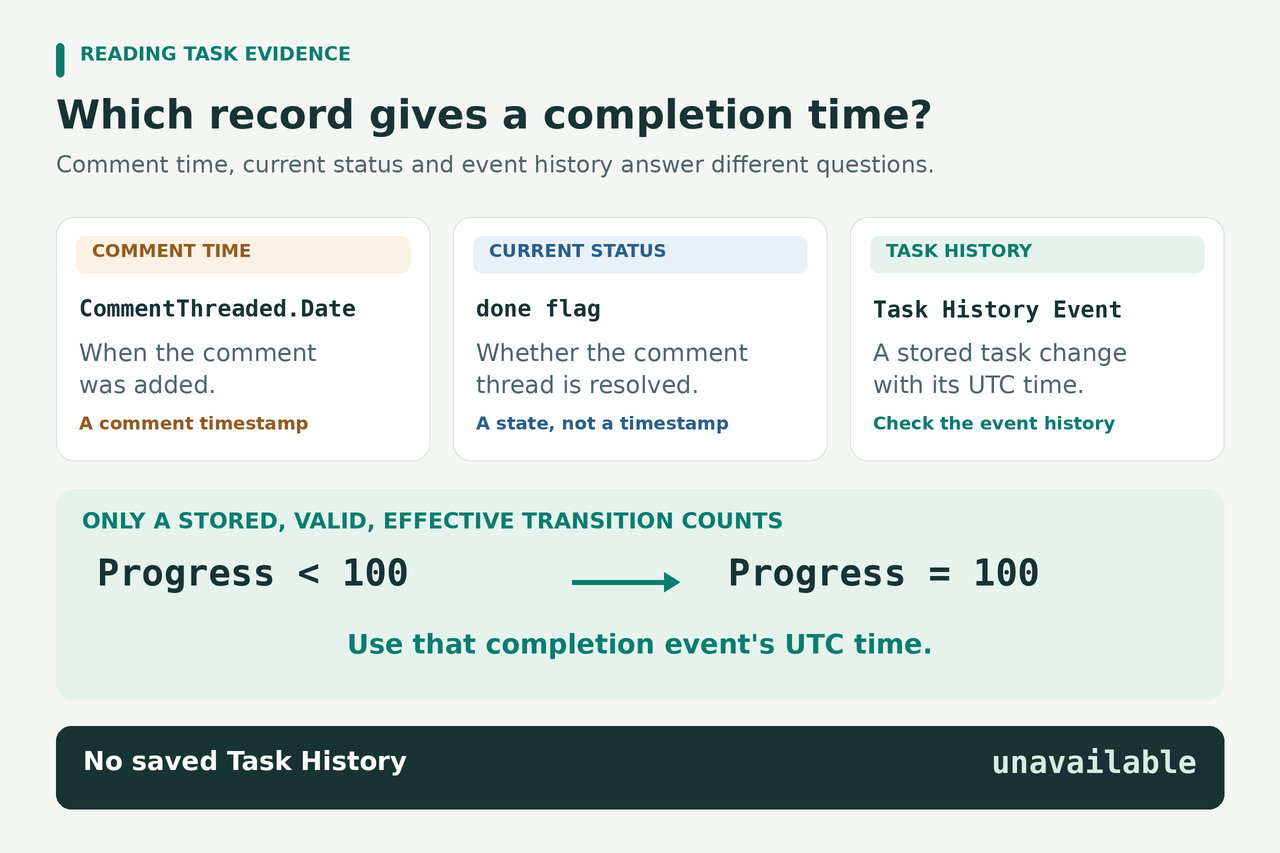
Al exportar los comentarios de Excel, puede faltar una entrada identificada como Completed Task. La hora de creación de un comentario, la de la última respuesta y la del momento en que una tarea se completó responden a preguntas distintas. Sustituir una por otra puede introducir en tu informe una fecha verosímil, pero incorrecta.
Un XLSX guardado puede contener un historial independiente de las tareas del documento. El programa que aparece a continuación examina esos datos guardados, vincula las tareas con los identificadores de los comentarios en hilo y exporta los eventos que puede verificar. Si falta el historial necesario, el resultado lo indica. No inventa una fecha de resolución a partir del indicador done de un comentario ni garantiza que todas las versiones de Excel o todos los exportadores conserven el historial de tareas.
1. Comprueba qué fecha necesitas
Usa esta guía cuando una exportación de comentarios o respuestas omita la información de finalización de una tarea asignada y quieras examinar el libro guardado. Si solo necesitas el texto, los autores, las respuestas y el estado abierto o resuelto de los comentarios normales, un exportador existente como CommentPulse quizá ya proporcione la tabla que buscas.
Microsoft define CommentThreaded.Date como la hora local en que se añadió el comentario. Las dos respuestas a la pregunta original de Stack Overflow utilizan la última respuesta como aproximación o examinan el XML de los comentarios en hilo normales y encuentran un indicador done. La última respuesta puede ser anterior a una acción posterior de finalización. Ninguno de esos resultados establece la hora de ese evento posterior de la tarea.
Este método requiere unos datos más específicos: una tarea real del documento y su History guardado. Un comentario normal resuelto que carezca de esos datos no tiene una hora de finalización de tarea recuperable mediante este método. La marca de tiempo de una tarea tampoco demuestra que se pulsara un botón concreto de la interfaz ni constituye un registro de auditoría completo de toda la cuenta.
2. Conserva una copia guardada del libro
Guarda o descarga una copia reciente del libro que tengas autorización para leer, en formato XLSX. Espera a que termine de guardarse antes de ejecutar el exportador. Conserva el original y examina la copia. El resultado refleja los datos de ese archivo; no puede incluir un cambio posterior en la nube que nunca se guardó en la copia.
No conviertas el archivo mediante otro servicio de hojas de cálculo solo para prepararlo para esta comprobación: el historial disponible será únicamente el que conserve el archivo resultante. Una exportación antigua, un archivo sin tareas asignadas o una aplicación que haya omitido el historial de tareas pueden dar como resultado, de forma legítima, la ausencia de registros de tareas utilizables.
El programa lee un paquete XLSX basado en ZIP y sigue sus relaciones internas. Los nombres de las hojas y las partes que contienen comentarios se vinculan mediante esas relaciones, sin suponer que sheet1 corresponde a threadedComment1. El programa nunca envía el libro a un sitio web ni accede a tu cuenta de Microsoft.
3. Guarda el exportador local completo
Usa Python 3.12 o posterior y un editor de texto sin formato. Guarda el programa completo que aparece a continuación como export_excel_task_events.py. Utiliza la biblioteca estándar de Python, por lo que este procedimiento no requiere ningún paquete de pip, token de API ni macro de Excel.
El siguiente bloque para copiar contiene el programa completo en una sola línea. Los saltos de línea y la sangría representados mediante secuencias de escape conservan la disposición original de Python al copiarlo desde esta página. Guárdalo como texto exactamente como aparece; no importa si el editor ajusta las líneas visualmente. No añadas comillas alrededor del bloque.
exec("#!/usr/bin/env python3\n\"\"\"Read saved XLSX document-task history; never infer completion from comments.\n\nUsage: python export_excel_task_events.py workbook.xlsx --out extracted_tasks\nOnly Python 3 standard-library modules are required. The source is never written.\n\"\"\"\nimport argparse, csv, datetime as dt, json, posixpath, re, sys, tempfile, zipfile\nfrom pathlib import Path\nfrom urllib.parse import unquote, urlsplit\nfrom xml.etree import ElementTree as ET\n\nTASK_NS = \"http://schemas.microsoft.com/office/tasks/2019/documenttasks\"\nEVENT_FIELDS = (\"source_part task_id ordinal event_id time_utc_raw event_type \"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"percent_complete undo_target undone anchor_id sheet cell \"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"actor_id actor_name actor_provider details_json is_completion_transition\").split()\nTASK_FIELDS = (\"source_part task_id anchor_id sheet cell status progress_percent \"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"completed_at_utc completed_event_id deleted\").split()\nMAX_XML = 32 * 1024 * 1024\nTIME = re.compile(r\"\\d{4}-\\d{2}-\\d{2}T\\d{2}:\\d{2}:\\d{2}(?:\\.\\d+)?(?:Z|[+-]\\d{2}:\\d{2})?\\Z\")\nOPERATIONS = {\"Create\", \"Assign\", \"Unassign\", \"UnassignAll\", \"SetTitle\",\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"Schedule\", \"Progress\", \"Priority\", \"Delete\", \"Undelete\", \"Undo\"}\n\ndef local(tag):\n\x20\x20\x20\x20return tag.rsplit(\"}\", 1)[-1]\n\ndef required(element, key, context):\n\x20\x20\x20\x20value = element.get(key, \"\")\n\x20\x20\x20\x20if not value.strip():\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"{context}: missing {key}\")\n\x20\x20\x20\x20return value\n\ndef anchor(element):\n\x20\x20\x20\x20child = element.find(f\"{{{TASK_NS}}}Anchor/{{{TASK_NS}}}Comment\")\n\x20\x20\x20\x20return child.get(\"id\", \"\") if child is not None else \"\"\n\ndef utc_time(value):\n\x20\x20\x20\x20if not TIME.fullmatch(value):\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Invalid task event datetime: {value!r}\")\n\x20\x20\x20\x20parsed = dt.datetime.fromisoformat(value.replace(\"Z\", \"+00:00\"))\n\x20\x20\x20\x20if parsed.utcoffset() not in (None, dt.timedelta(0)):\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Task event time must be UTC: {value!r}\")\n\x20\x20\x20\x20if value.endswith(\"Z\"):\n\x20\x20\x20\x20\x20\x20\x20\x20return value\n\x20\x20\x20\x20return (value[:-6] if re.search(r\"[+-]00:00$\", value) else value) + \"Z\"\n\ndef resolve(owner, target):\n\x20\x20\x20\x20uri = urlsplit(target)\n\x20\x20\x20\x20if uri.scheme or uri.netloc or uri.query:\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Invalid internal relationship target: {target!r}\")\n\x20\x20\x20\x20path = unquote(uri.path)\n\x20\x20\x20\x20if not path:\n\x20\x20\x20\x20\x20\x20\x20\x20return owner\x20\x20# A fragment-only relationship refers to this part.\n\x20\x20\x20\x20part = posixpath.normpath(path.lstrip(\"/\") if path.startswith(\"/\") else\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20posixpath.join(posixpath.dirname(owner), path))\n\x20\x20\x20\x20if part in (\".\", \"..\") or part.startswith(\"../\") or \"\\\\\" in part or \"\\x00\" in part:\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Relationship escapes the package: {target!r}\")\n\x20\x20\x20\x20return part\n\nclass Package:\n\x20\x20\x20\x20def __init__(self, archive):\n\x20\x20\x20\x20\x20\x20\x20\x20self.archive, self.names, self.graph, self.kinds = archive, set(), {}, {}\n\x20\x20\x20\x20\x20\x20\x20\x20for entry in archive.infolist():\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if entry.flag_bits \u0026 1:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(\"Encrypted ZIP entries are not supported\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if entry.is_dir():\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20name = entry.filename\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if name in self.names:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Duplicate ZIP entry: {name}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if name.startswith((\"/\", \"../\")) or name == \"..\" or posixpath.normpath(name) != name or \"\\\\\" in name:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Invalid ZIP part name: {name}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20self.names.add(name)\n\x20\x20\x20\x20\x20\x20\x20\x20pending, reached = [\"\"], set()\n\x20\x20\x20\x20\x20\x20\x20\x20while pending:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20owner = pending.pop()\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if owner in reached:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20reached.add(owner)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20relfile = (posixpath.join(posixpath.dirname(owner), \"_rels\",\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20posixpath.basename(owner) + \".rels\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if owner else \"_rels/.rels\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20relations = {}\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if relfile in self.names:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20for rel in self.xml(relfile):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if local(rel.tag) != \"Relationship\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20rid = required(rel, \"Id\", relfile)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if rid in relations:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Duplicate relationship ID in {relfile}: {rid}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20kind = required(rel, \"Type\", relfile).rsplit(\"/\", 1)[-1].lower()\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20target = required(rel, \"Target\", relfile)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if rel.get(\"TargetMode\") == \"External\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20relations[rid] = (kind, None)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20target = resolve(owner, target)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if target and target not in self.names:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Missing relationship target: {target}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20relations[rid] = (kind, target)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20self.kinds.setdefault(target, set()).add(kind)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20pending.append(target)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20self.graph[owner] = relations\n\x20\x20\x20\x20\x20\x20\x20\x20self.reached = reached\n\n\x20\x20\x20\x20def xml(self, name):\n\x20\x20\x20\x20\x20\x20\x20\x20if self.archive.getinfo(name).file_size > MAX_XML:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"XML part exceeds 32 MiB: {name}\")\n\x20\x20\x20\x20\x20\x20\x20\x20data = self.archive.read(name)\n\x20\x20\x20\x20\x20\x20\x20\x20if b\"\u003c!DOCTYPE\" in data or b\"\u003c!ENTITY\" in data:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"DTD/entity declarations are not supported: {name}\")\n\x20\x20\x20\x20\x20\x20\x20\x20try:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20return ET.fromstring(data)\n\x20\x20\x20\x20\x20\x20\x20\x20except ET.ParseError as error:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Invalid XML in {name}: {error}\") from error\n\n\x20\x20\x20\x20def comment_locations(self):\n\x20\x20\x20\x20\x20\x20\x20\x20books = [p for kind, p in self.graph[\"\"].values() if kind == \"officedocument\" and p]\n\x20\x20\x20\x20\x20\x20\x20\x20if len(books) != 1:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(\"Expected one package-root officeDocument relationship\")\n\x20\x20\x20\x20\x20\x20\x20\x20book, comments = books[0], {}\n\x20\x20\x20\x20\x20\x20\x20\x20root = self.xml(book)\n\x20\x20\x20\x20\x20\x20\x20\x20if local(root.tag) != \"workbook\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(\"The package is not an XLSX workbook\")\n\x20\x20\x20\x20\x20\x20\x20\x20for sheet in root.iter():\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if local(sheet.tag) != \"sheet\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20rid = next((v for k, v in sheet.attrib.items() if k.endswith(\"}id\")), \"\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20kind, part = self.graph[book].get(rid, (\"\", None))\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if kind != \"worksheet\" or not part:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20for relkind, target in self.graph[part].values():\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if target and relkind in (\"threadedcomment\", \"threadedcomments\"):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20for comment in self.xml(target):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if local(comment.tag) != \"threadedComment\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20cid = required(comment, \"id\", target)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if cid in comments:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Duplicate threaded-comment ID: {cid}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20comments[cid] = (sheet.get(\"name\", \"\"), comment.get(\"ref\", \"\"),\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20comment.get(\"parentId\", \"\"))\n\x20\x20\x20\x20\x20\x20\x20\x20def location(cid, seen):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if cid in seen:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Cyclic comment parent IDs: {cid}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20sheet, cell, parent = comments[cid]\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if not cell and parent in comments:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20return location(parent, seen | {cid})\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20return sheet, cell\n\x20\x20\x20\x20\x20\x20\x20\x20return {cid: location(cid, set()) for cid in comments}\n\n\x20\x20\x20\x20def task_parts(self):\n\x20\x20\x20\x20\x20\x20\x20\x20parts = {p for p in self.reached if \"documenttasks\" in self.kinds.get(p, set())}\n\x20\x20\x20\x20\x20\x20\x20\x20if \"[Content_Types].xml\" in self.names:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20for item in self.xml(\"[Content_Types].xml\"):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if local(item.tag) == \"Override\" and \"documenttasks\" in item.get(\"ContentType\", \"\").lower():\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20part = resolve(\"\", item.get(\"PartName\", \"\"))\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if part in self.reached:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20parts.add(part)\n\x20\x20\x20\x20\x20\x20\x20\x20return sorted(parts)\n\ndef parse_task(task, source, locations):\n\x20\x20\x20\x20tid = required(task, \"id\", source)\n\x20\x20\x20\x20history = task.find(f\"{{{TASK_NS}}}History\")\n\x20\x20\x20\x20nodes = [] if history is None else list(history.findall(f\"{{{TASK_NS}}}Event\"))\n\x20\x20\x20\x20aid = anchor(task)\n\x20\x20\x20\x20candidates = {anchor(e) for e in nodes if anchor(e)}\n\x20\x20\x20\x20if not aid and len(candidates) == 1:\n\x20\x20\x20\x20\x20\x20\x20\x20aid = next(iter(candidates))\n\x20\x20\x20\x20status = (\"ok\" if aid in locations else \"unmatched_anchor\" if aid else\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"ambiguous_anchor\" if candidates else \"missing_anchor\")\n\x20\x20\x20\x20sheet, cell = locations.get(aid, (\"\", \"\"))\n\x20\x20\x20\x20state = dict(zip(TASK_FIELDS, [source, tid, aid, sheet, cell, status, \"\", \"\", \"\", False]))\n\x20\x20\x20\x20if not nodes:\n\x20\x20\x20\x20\x20\x20\x20\x20state[\"status\"] = \"missing_history\"\n\x20\x20\x20\x20\x20\x20\x20\x20return [], state\n\x20\x20\x20\x20events, positions, normalized = [], {}, []\n\x20\x20\x20\x20for ordinal, node in enumerate(nodes, 1):\n\x20\x20\x20\x20\x20\x20\x20\x20eid = required(node, \"id\", f\"Task {tid} event {ordinal}\")\n\x20\x20\x20\x20\x20\x20\x20\x20if eid in positions:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Duplicate event ID in task {tid}: {eid}\")\n\x20\x20\x20\x20\x20\x20\x20\x20raw = required(node, \"time\", f\"Event {eid}\")\n\x20\x20\x20\x20\x20\x20\x20\x20normalized.append(utc_time(raw))\n\x20\x20\x20\x20\x20\x20\x20\x20actors = node.findall(f\"{{{TASK_NS}}}Attribution\")\n\x20\x20\x20\x20\x20\x20\x20\x20operations = [c for c in node if c.tag.startswith(\"{\" + TASK_NS + \"}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20and local(c.tag) in OPERATIONS]\n\x20\x20\x20\x20\x20\x20\x20\x20if len(actors) != 1 or len(operations) > 1:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Event {eid}: expected one Attribution and at most one operation\")\n\x20\x20\x20\x20\x20\x20\x20\x20actor = actors[0]\n\x20\x20\x20\x20\x20\x20\x20\x20actor_values = [required(actor, k, f\"Event {eid} Attribution\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20for k in (\"userId\", \"userName\", \"userProvider\")]\n\x20\x20\x20\x20\x20\x20\x20\x20op = operations[0] if operations else None\n\x20\x20\x20\x20\x20\x20\x20\x20kind, percent, undo = local(op.tag) if op is not None else \"Extension\", \"\", \"\"\n\x20\x20\x20\x20\x20\x20\x20\x20if kind == \"Progress\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20text = required(op, \"percentComplete\", f\"Event {eid}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if not re.fullmatch(r\"\\+?\\d+\", text) or not 0 \u003c= int(text) \u003c= 100:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Event {eid}: percentComplete must be an integer from 0 to 100\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20percent = int(text)\n\x20\x20\x20\x20\x20\x20\x20\x20if kind == \"Undo\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20undo = required(op, \"id\", f\"Event {eid} Undo\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if undo not in positions or events[positions[undo]][\"event_type\"] == \"Create\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Event {eid}: Undo must target an earlier non-Create event\")\n\x20\x20\x20\x20\x20\x20\x20\x20positions[eid] = ordinal - 1\n\x20\x20\x20\x20\x20\x20\x20\x20event_aid = anchor(node) or aid\n\x20\x20\x20\x20\x20\x20\x20\x20event_sheet, event_cell = locations.get(event_aid, (\"\", \"\"))\n\x20\x20\x20\x20\x20\x20\x20\x20detail = json.dumps({\"attributes\": node.attrib, \"xml\": ET.tostring(node, encoding=\"unicode\")}, ensure_ascii=False)\n\x20\x20\x20\x20\x20\x20\x20\x20values = [source, tid, ordinal, eid, raw, kind, percent, undo, False,\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20event_aid, event_sheet, event_cell] + actor_values + [detail, False]\n\x20\x20\x20\x20\x20\x20\x20\x20events.append(dict(zip(EVENT_FIELDS, values)))\n\x20\x20\x20\x20if events[0][\"event_type\"] != \"Create\" or sum(e[\"event_type\"] == \"Create\" for e in events) != 1:\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Task {tid}: history must start with its only Create event\")\n\x20\x20\x20\x20for event in reversed(events):\n\x20\x20\x20\x20\x20\x20\x20\x20if event[\"event_type\"] == \"Undo\" and not event[\"undone\"]:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20events[positions[event[\"undo_target\"]]][\"undone\"] = True\n\x20\x20\x20\x20progress = 0\n\x20\x20\x20\x20for event, time in zip(events, normalized):\n\x20\x20\x20\x20\x20\x20\x20\x20if event[\"undone\"]:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20continue\n\x20\x20\x20\x20\x20\x20\x20\x20kind = event[\"event_type\"]\n\x20\x20\x20\x20\x20\x20\x20\x20if kind == \"Progress\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20new = event[\"percent_complete\"]\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if progress \u003c 100 and new == 100:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20state[\"completed_at_utc\"], state[\"completed_event_id\"] = time, event[\"event_id\"]\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20event[\"is_completion_transition\"] = True\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if new \u003c 100:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20state[\"completed_at_utc\"], state[\"completed_event_id\"] = \"\", \"\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20progress = new\n\x20\x20\x20\x20\x20\x20\x20\x20elif kind in (\"Delete\", \"Undelete\"):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20state[\"deleted\"] = kind == \"Delete\"\n\x20\x20\x20\x20state[\"progress_percent\"] = progress\n\x20\x20\x20\x20return events, state\n\ndef extract(path):\n\x20\x20\x20\x20events, tasks, task_ids = [], [], set()\n\x20\x20\x20\x20try:\n\x20\x20\x20\x20\x20\x20\x20\x20with zipfile.ZipFile(path, \"r\") as archive:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20package = Package(archive)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20locations = package.comment_locations()\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20for source in package.task_parts():\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20root = package.xml(source)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if root.tag != f\"{{{TASK_NS}}}Tasks\":\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Unexpected Tasks root/namespace in {source}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20for task in root.findall(f\"{{{TASK_NS}}}Task\"):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20rows, state = parse_task(task, source, locations)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20if state[\"task_id\"] in task_ids:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Duplicate task ID: {state['task_id']}\")\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20task_ids.add(state[\"task_id\"])\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20events.extend(rows)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20tasks.append(state)\n\x20\x20\x20\x20except (zipfile.BadZipFile, RuntimeError, NotImplementedError, OSError, KeyError) as error:\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Cannot read XLSX package: {error}\") from error\n\x20\x20\x20\x20return events, tasks\n\ndef csv_safe(value):\n\x20\x20\x20\x20if isinstance(value, str) and (re.match(r\"\\s*[=+@-]\", value) or value.startswith((\"\\t\", \"\\r\", \"\\n\"))):\n\x20\x20\x20\x20\x20\x20\x20\x20return \"'\" + value\n\x20\x20\x20\x20return value\n\ndef export(path, outdir):\n\x20\x20\x20\x20events, tasks = extract(path)\n\x20\x20\x20\x20destination = Path(outdir)\n\x20\x20\x20\x20names = (\"events.csv\", \"tasks.csv\", \"data.json\", \"summary.txt\")\n\x20\x20\x20\x20if destination.exists():\n\x20\x20\x20\x20\x20\x20\x20\x20raise ValueError(f\"Output directory already exists: {destination}; choose a new --out directory\")\n\x20\x20\x20\x20destination.mkdir(parents=True)\n\x20\x20\x20\x20summary = (f\"Tasks: {len(tasks)}\\nEvents: {len(events)}\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"Source workbook opened read-only. Only package-root-reachable task parts included.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"No completion time inferred from done flags, replies or last-edit timestamps.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"completed_at_utc is the current effective task progress transition to 100%; deletion is separate.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"undone reflects the final saved history, not every past UI state.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"is_completion_transition marks each effective progress change from below 100 to 100.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"Missing history/anchors are explicit; unmatched tasks can still have task event times.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"CSV formula-like text is prefixed with an apostrophe; data.json preserves original field values.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"Raw event datetime is preserved; timezone-free task times are interpreted as UTC per MS-OTASKXML.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"No task rows means no reachable stored task records, not that no comments were resolved.\\n\"\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\"Limits: XML parts \u003c=32 MiB; encrypted files and malformed/ambiguous histories fail.\\n\")\n\x20\x20\x20\x20with tempfile.TemporaryDirectory(dir=destination) as temporary:\n\x20\x20\x20\x20\x20\x20\x20\x20temporary = Path(temporary)\n\x20\x20\x20\x20\x20\x20\x20\x20for name, fields, rows in ((\"events.csv\", EVENT_FIELDS, events), (\"tasks.csv\", TASK_FIELDS, tasks)):\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20with (temporary / name).open(\"w\", newline=\"\", encoding=\"utf-8-sig\") as stream:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20writer = csv.DictWriter(stream, fieldnames=fields)\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20writer.writeheader()\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20writer.writerows({k: csv_safe(v) for k, v in row.items()} for row in rows)\n\x20\x20\x20\x20\x20\x20\x20\x20(temporary / \"data.json\").write_text(json.dumps({\"events\": events, \"tasks\": tasks}, ensure_ascii=False, indent=2), encoding=\"utf-8\")\n\x20\x20\x20\x20\x20\x20\x20\x20(temporary / \"summary.txt\").write_text(summary, encoding=\"utf-8\")\n\x20\x20\x20\x20\x20\x20\x20\x20for name in names:\n\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20\x20(temporary / name).replace(destination / name)\n\x20\x20\x20\x20return events, tasks\n\ndef main(argv=None):\n\x20\x20\x20\x20parser = argparse.ArgumentParser(description=__doc__)\n\x20\x20\x20\x20parser.add_argument(\"workbook\", help=\"Saved .xlsx workbook (read-only)\")\n\x20\x20\x20\x20parser.add_argument(\"--out\", required=True, help=\"New directory for the four output files\")\n\x20\x20\x20\x20args = parser.parse_args(argv)\n\x20\x20\x20\x20try:\n\x20\x20\x20\x20\x20\x20\x20\x20events, tasks = export(args.workbook, args.out)\n\x20\x20\x20\x20except (ValueError, OSError) as error:\n\x20\x20\x20\x20\x20\x20\x20\x20parser.exit(2, f\"Error: {error}\\n\")\n\x20\x20\x20\x20print(f\"Exported {len(events)} events and {len(tasks)} tasks to {args.out}\")\n\x20\x20\x20\x20return 0\n\nif __name__ == \"__main__\":\n\x20\x20\x20\x20sys.exit(main())\n")
La entrada es un libro que ya tienes permiso para leer. El script solo lee ese archivo y escribe sus propios informes. Conserva los informes junto con la copia guardada original para que los identificadores de la parte de origen, la tarea y el evento sigan siendo útiles al comprobar el resultado.
4. Ejecútalo con una carpeta de salida nueva
Coloca el programa junto al libro guardado o utiliza rutas completas. Abre una terminal en esa carpeta. Si en tu sistema Python 3 está disponible mediante python3, ejecuta el siguiente comando; en Windows, sustituye python3 por py -3 si ese es tu lanzador de Python.
python3 export_excel_task_events.py "review-copy.xlsx" --out "task-report"
Usa un nombre de carpeta de salida nuevo para cada versión guardada del libro. Espera a que aparezca el resumen de finalización correcta antes de dar los informes por completos. Si el programa indica que hay datos no válidos o no compatibles, atiende ese error en lugar de considerar un resultado parcial o vacío como una exportación completada.
La nueva carpeta contiene events.csv, tasks.csv, data.json y summary.txt. Los dos archivos CSV son las tablas de eventos y tareas; summary.txt ofrece los recuentos y los límites de interpretación. data.json conserva las cadenas originales de los campos para su uso por otros programas. Las siguientes secciones explican qué fechas tienen significado y cómo distinguir entre una fecha ausente y una tarea incompleta.
5. Lee el resultado de la tarea antes de copiar una fecha
Empieza por tasks.csv. Cada fila identifica source_part y task_id, y muestra anchor_id, sheet y cell cuando está disponible la asociación con el comentario. Comprueba primero status: ok significa que se encontró una asociación. Los estados missing_history, missing_anchor, unmatched_anchor o ambiguous_anchor requieren atención antes de atribuir una marca de tiempo a un comentario concreto de una hoja.
En una tarea vinculada correctamente, progress_percent describe el estado obtenido al reproducir su historial efectivo. completed_at_utc y completed_event_id identifican el evento Progress efectivo que inició su estado completado actual. Un valor de progreso efectivo posterior inferior a 100 vacía ese campo de finalización actual. Repetir 100 sin pasar antes a un estado incompleto no crea una nueva transición de finalización.
deleted es un indicador independiente. Una tarea puede conservar su historial de finalización y, a la vez, estar marcada como eliminada. No omitas ese indicador sin explicarlo ni presentes una tarea eliminada como una asignación activa. Del mismo modo, un campo de finalización actual vacío no significa que la tarea nunca se completara antes.
Conserva los identificadores originales de la parte de origen, la tarea y el evento junto a la fecha en los informes posteriores. Esos identificadores permiten rastrear el resultado hasta el paquete guardado y evitan que un identificador de evento reutilizado en el historial de otra tarea se interprete como el mismo evento.
6. Examina los eventos efectivos en el orden del XML
events.csv conserva ordinal, la cadena original time_utc_raw y event_id, junto con event_type, la atribución del actor y las referencias a la tarea y al comentario. is_completion_transition=True identifica un cambio efectivo de Progress de un valor inferior a 100 a 100. undone=True marca los registros excluidos del historial efectivo final; esas filas siguen visibles para poder comprobarlas. El CSV escribe estos valores booleanos como True/False; JSON utiliza true/false.
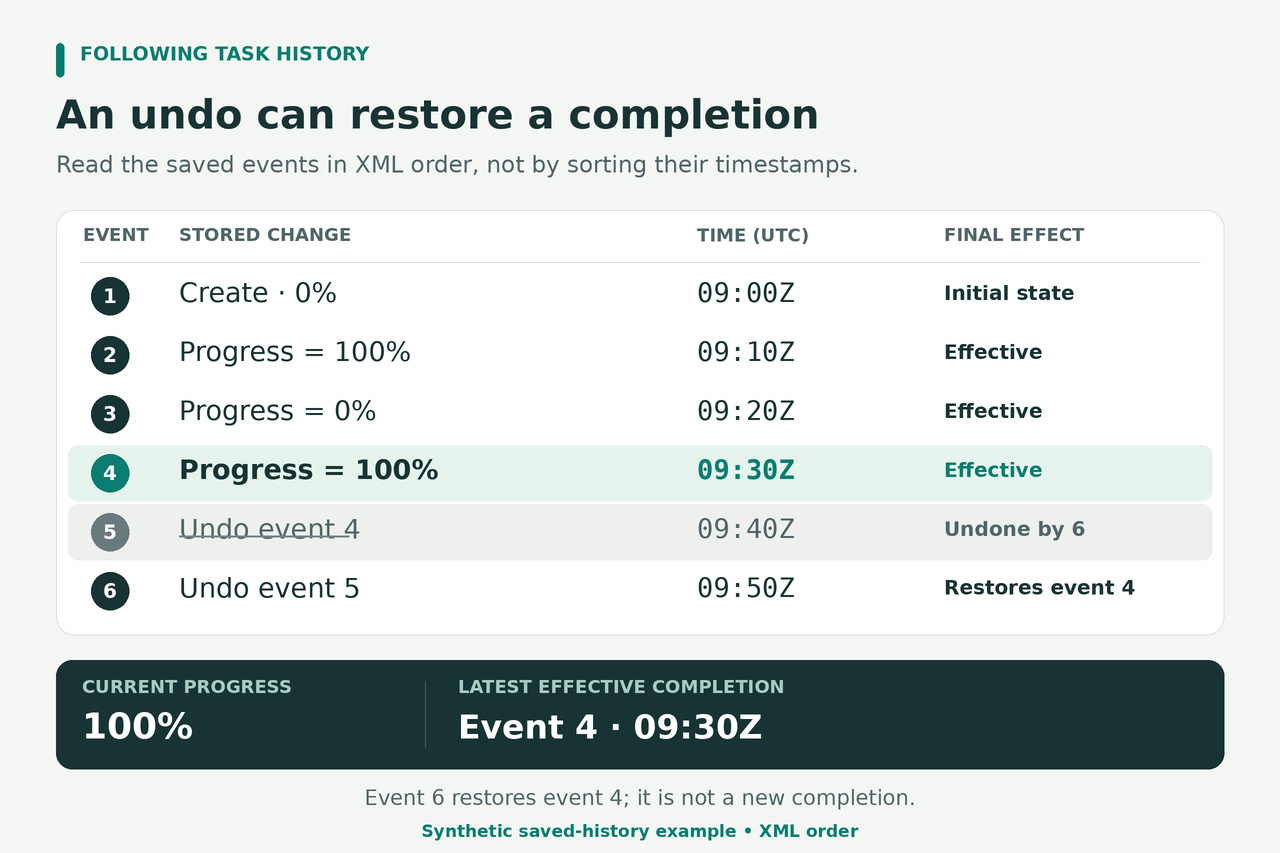
Evalúa la secuencia del XML, sin ordenarla por marca de tiempo. Microsoft especifica que un Undo efectivo posterior puede excluir un evento anterior y que un Undo también puede deshacerse. Tras esas exclusiones, los eventos restantes se reproducen en el orden en que están guardados. La fecha más reciente o la última respuesta no pueden sustituir ese proceso.
Considera esta secuencia sintética: Create; Progress 100; Progress 0; Progress 100; Undo de la segunda finalización; Undo de ese Undo. El historial efectivo final vuelve a incluir la segunda finalización. Su evento Progress aporta la hora del evento de finalización que se conserva. La hora posterior del Undo que deshace el otro Undo no se reclasifica como una nueva finalización de Progress.
Este informe describe el historial efectivo final del archivo guardado. No reconstruye todos los momentos en los que la interfaz pudo mostrar la tarea como completada ni identifica cada reducción del progreso como una pulsación de Reopen. Esas son afirmaciones distintas.
7. Interpreta los resultados no disponibles o no válidos
No hay un historial de tareas accesible: el archivo puede contener comentarios normales, no tener tareas asignadas, reflejar un estado guardado antiguo o proceder de una exportación que omitió los datos de tareas. Examina una copia actual del XLSX original, si existe. El exportador no puede recuperar eventos ausentes a partir de un indicador done.
missing_history: existe una tarea, pero su secuencia de eventos utilizable está ausente o vacía. missing_anchor: no se encontró una referencia de comentario utilizable. unmatched_anchor: existe una referencia, pero no se encontró el comentario en hilo correspondiente a través de las relaciones del libro. ambiguous_anchor: no hay una referencia en el nivel de la tarea y las referencias de los eventos no coinciden. Una tarea sin vincular puede seguir teniendo horas de eventos; eso no permite identificar a qué comentario de la hoja pertenecen.
Cuando no hay una referencia de comentario en el nivel de la tarea y todas las referencias disponibles en los eventos coinciden, el programa usa esa referencia única para establecer la asociación. En caso contrario, conserva el resultado de referencia ausente o ambigua. No intentes deducir una hoja a partir de coincidencias en el texto de los comentarios o de los números de los nombres de archivo.
Los datos de eventos no válidos constituyen un error aparte. Los identificadores duplicados dentro del historial de una misma tarea, un Undo que no apunta a un evento anterior permitido, una marca de tiempo mal formada o un valor de progreso fuera de rango no deben dar lugar a una fecha estimada. Conserva la copia y el error comunicado. Obtén otro archivo guardado válido, si está disponible; editar el historial a mano solo para superar la comprobación alteraría la evidencia.
Si el historial no está disponible y necesitas un registro fiable de finalización para trabajos futuros, registra las próximas horas de finalización en un campo explícito o en otro flujo de trabajo que controles. Eso crea registros nuevos; no reconstruye las horas pasadas que faltan.
8. Importa como texto y comprueba la exportación
Importa los archivos CSV en tu hoja de cálculo tratando las columnas de identificadores y marcas de tiempo como texto. Así se conservan las cadenas guardadas sin conversiones automáticas a fechas o números. Un campo CSV entrecomillado puede contener una coma o un salto de línea; por eso debes contar los registros interpretados por un lector CSV, no las líneas físicas de texto.
Los informes CSV anteponen un apóstrofo al texto que parece una fórmula, incluidos los valores que empiezan por =, +, - o @ después de espacios en blanco. data.json conserva los valores originales de los campos sin ese prefijo. Utiliza esos valores JSON cuando necesites el texto original exacto; no elimines el prefijo para después abrir texto no fiable como si fuera una fórmula. Dentro de details_json, el XML del evento se analiza y se vuelve a serializar, por lo que los prefijos de los espacios de nombres y el formato del XML no son copias de los bytes originales.
Compara los recuentos de tareas y eventos del resumen con las tablas interpretadas. Comprueba al menos una tarea conocida mediante su hoja, celda e identificadores de eventos; después, revisa todos los estados que indiquen datos ausentes o referencias sin correspondencia antes de usar las fechas. Filtra las transiciones de finalización teniendo en cuenta tanto el indicador de transición como el estado efectivo o deshecho del registro.
Conserva juntos el libro guardado original, todos los archivos del informe y el programa exacto. Si el libro cambia más adelante, ejecuta una nueva exportación en una carpeta nueva y compara ambas copias del estado guardado. No sobrescribas un informe anterior para después describirlo como el registro del archivo anterior.
9. Qué se verificó
En Python 3.12.14, el programa en su formato normal superó 26 pruebas con archivos ZIP y libros sintéticos. Un revisor independiente ejecutó 8 pruebas escritas por separado, incluida una comparación con un método recursivo de Undo a lo largo de 64 historiales generados. El bloque de una sola línea mostrado arriba se decodificó y se comprobó que reproducía exactamente el código fuente normal; después volvió a superar la batería de 26 casos, incluida la comprobación de su interfaz de línea de comandos. Los archivos de prueba utilizaban el URI oficial de la relación de tareas del documento. Son pruebas con archivos sintéticos, no pruebas de la interfaz gráfica de Excel, de Windows/macOS ni de libros reales de usuarios.
Las comprobaciones abarcaron la vinculación de hojas y comentarios mediante relaciones, el ámbito de los identificadores de eventos, los resultados de historial ausente y de referencias de comentario, Undo de Undo, finalizaciones repetidas, progreso posterior incompleto, eliminación, tratamiento del texto en CSV/JSON, conservación de los bytes de entrada y rechazo de la sobrescritura de una carpeta de salida existente. El script limita a 32 MiB cada parte XML que lee, mantiene en memoria los datos analizados y no admite paquetes de libros cifrados. No se realizó ninguna prueba de capacidad con un libro de producción de gran tamaño.
La documentación de Microsoft sobre el formato de tareas respalda la semántica de los identificadores, las horas, el progreso y Undo guardados. CommentPulse documenta por su parte su exportador existente y su limitación respecto a los datos de tareas. El programa y sus comprobaciones reúnen esas piezas en un proceso de extracción local que depende de los datos disponibles; no demuestran que todas las instalaciones de Excel escriban el mismo historial ni que estén presentes los eventos que le faltaban al autor de la pregunta original.