Tecnología · GUÍA PRÁCTICA
¿Docker dice que la red tiene active endpoints? Mapea cada propietario antes de borrarla
Fija el ID exacto, incluye contenedores detenidos y relaciona etiquetas con el proyecto Compose o servicio Swarm propietario. Cambia al propietario y verifica el mismo ID.
“Network has active endpoints” significa que Docker aún ve una conexión al objeto de red exacto. Puede pertenecer a un contenedor activo o detenido, otro proyecto Compose o un servicio Swarm que recrea tareas.
No empieces con prune, desconexión forzada ni reinicio del daemon. Registra ID, driver, scope y etiquetas; enumera propietarios; cambia el propietario y verifica el mismo ID.
Fija la identidad exacta de la red
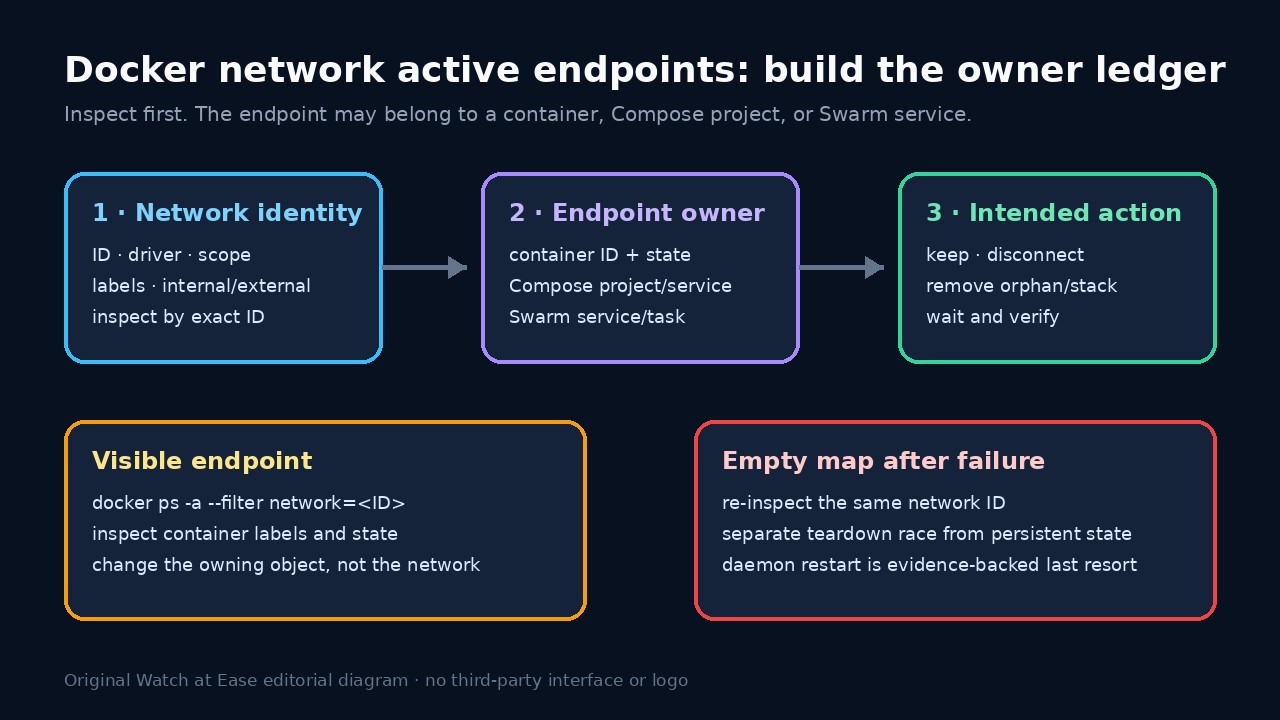
Guarda el error y resuelve el nombre a un ID con docker network inspect. Registra Name, ID, Driver, Scope, Internal, Attachable y Labels, y reutiliza ese ID.
Exporta inspect antes de limpiar. Distingue nombres similares con ID y etiquetas Compose; un overlay de producción y un bridge local tienen propietarios distintos.
Construye el libro de propietarios
Lee Containers y ejecuta docker ps -a --filter network=<ID> con ID, nombre, estado, etiquetas y redes. Detener un contenedor no prueba que desapareció su endpoint.
Registra las etiquetas de proyecto, servicio y one-off de Compose. Sin ellas, investiga cómo se creó el contenedor; no desconectes un endpoint desconocido sin acuerdo.
Cambia el propietario, no el síntoma
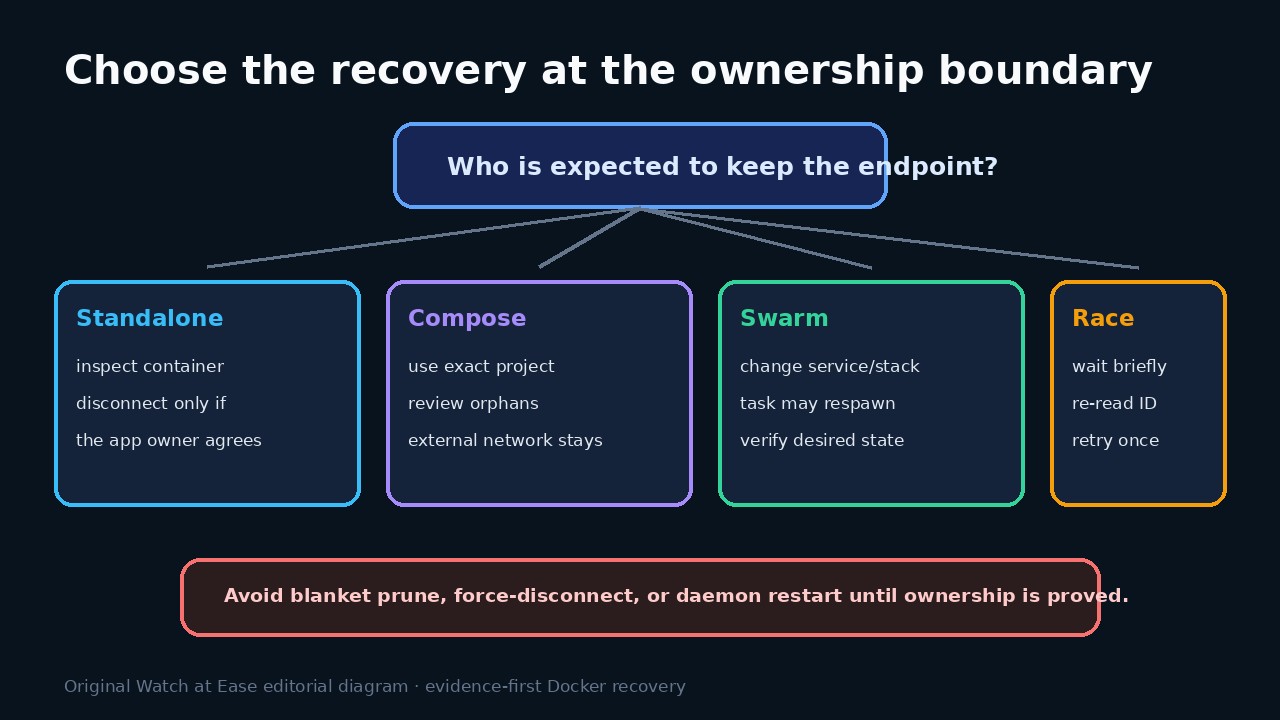
En Compose usa la identidad de proyecto y archivos que crearon los contenedores. Revisa --remove-orphans; ausente del modelo no significa desechable. Una red external tiene propietario aparte.
En Swarm localiza el servicio o stack que declara el overlay y actualízalo, escálalo o elimínalo. Borrar una tarea no cierra el caso porque el orquestador puede reemplazarla.
Separa carrera y estado persistente
Si el mismo ID está vacío tras el fallo, espera brevemente, confirma que no aparecen tareas y reintenta una vez la eliminación estrecha. Un ID nuevo con el mismo nombre requiere otra auditoría.
Si el mismo ID sigue vacío pero falla, reúne logs, versión, driver y reproducción. Solo entonces considera un reinicio controlado según la política del host.
Verifica salud y cierra la causa
Tras retirar al propietario, inspecciona el mismo ID. Borra solo con ledger vacío y plan que lo permita; confirma conexiones de redes compartidas y servicios restantes.
Registra contenedor detenido, proyecto incorrecto, orphan, external compartida, Swarm, carrera o daemon/driver, y corrige el runbook específico.