科技 · 實用指南
將 digiKam 關鍵字匯出 CSV,保留標籤清單邊界
標籤詞彙表不同於逐檔關鍵字表。先保留 ExifTool JSON 陣列、輸入檔名與命名空間,再轉成 CSV。
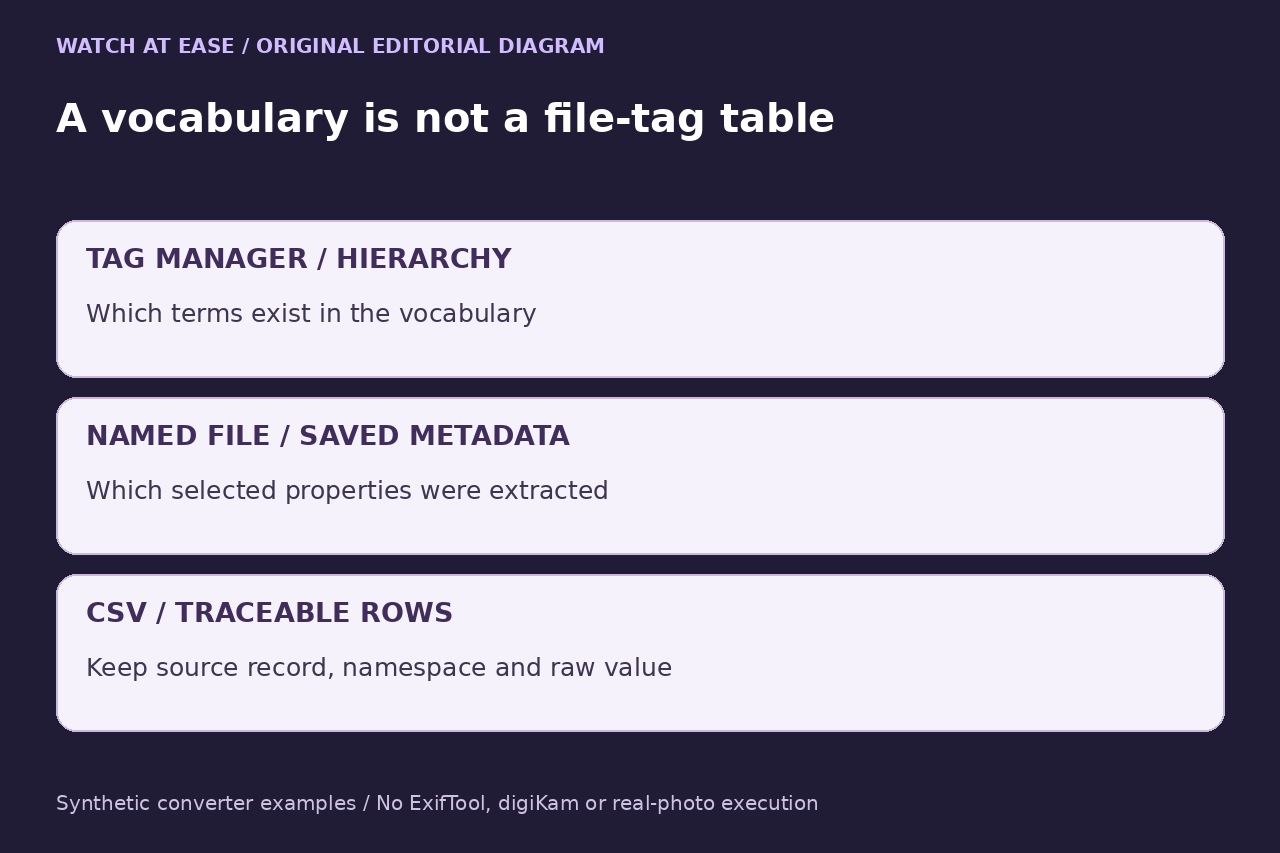
若要知道已存關鍵字來自哪個檔案,應讀取檔案中繼資料,而不是截圖標籤樹。目前 digiKam 標籤管理員可匯出階層,但詞彙表不是逐檔標籤指派表;僅存於資料庫的變更不在以下方法範圍。
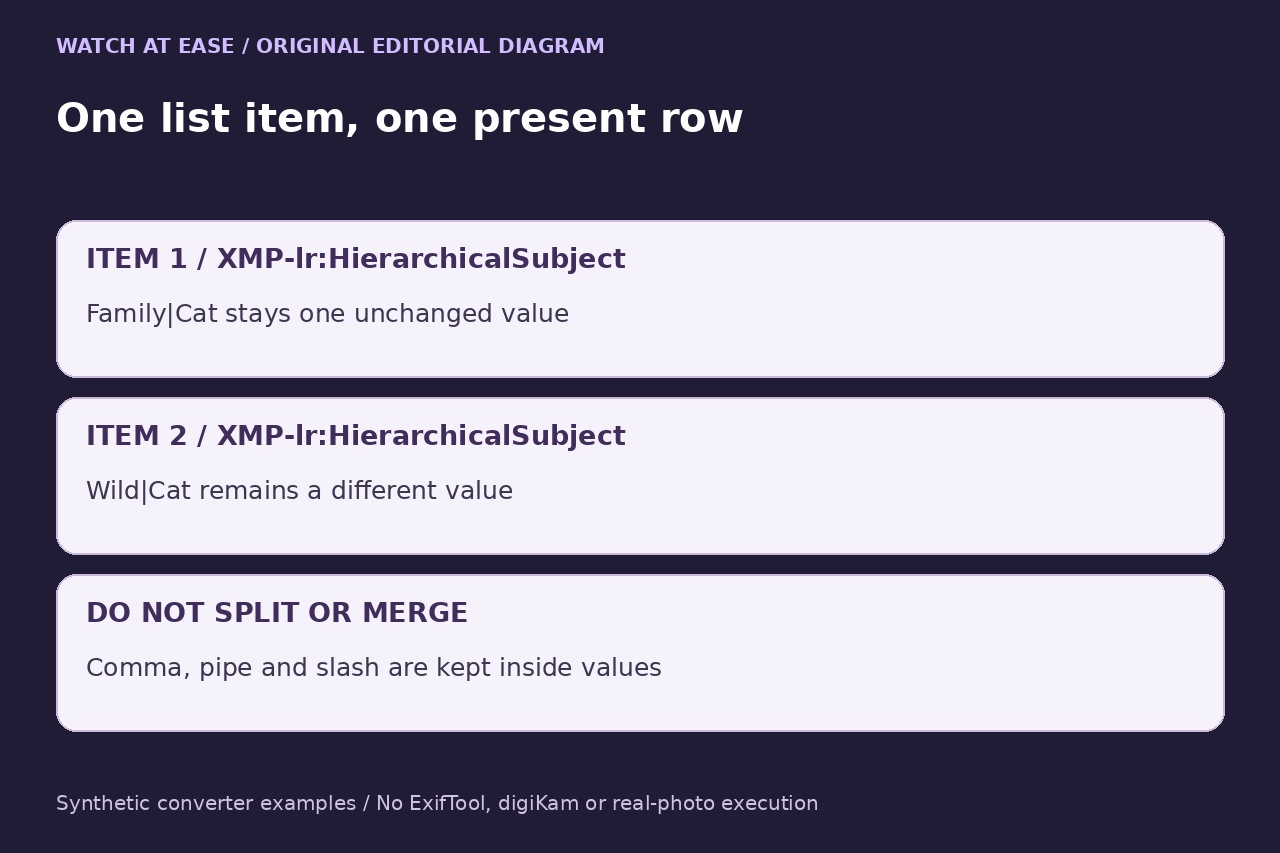
轉換器為每個擷取的清單項目建立一列並保留命名空間,不以逗號、直線或斜線拆值、不合併不同欄位、不修改照片。這是檢查用匯出,不是完整備份或自動修復。
先確認要讀取哪份證據
擴大範圍前,先將已知檔案與 digiKam 顯示對照。若關鍵字只在資料庫,先停下;讀檔無法匯出那些資料。依既有備份與同步流程處理差異,本文不會自動寫入中繼資料或修改資料庫。
明確指定 .xmp 時,SourceFile 指該邊車檔,不是自動配對照片。同時匯出照片與邊車時保留兩筆紀錄比較,不默默合併或取捨。另存的選取清單 XML 也不提供這些關鍵字值。
使用唯讀 ExifTool 命令擷取陣列
使用已安裝的 ExifTool,先選已知輸入副本。在 Linux Bash 中於照片資料夾外選新輸出名稱,替換輸入路徑後執行以下命令。它只要求兩個 XMP 屬性,不賦值或匯入 CSV、JSON。
exiftool -j -G1 -struct -XMP-lr:HierarchicalSubject -XMP-digiKam:TagsList -- "/path/to/input.jpg" > metadata.json 2> metadata-errors.txt
轉換前檢查結束狀態、標準錯誤與 JSON,調查警告或錯誤;正常檔案計數摘要本身不是錯誤。保留 -j -G1 -struct,不加會串接清單的 -sep。現行文件說明 -struct 也使單項 XMP 清單維持陣列。兩欄可能不同,缺欄不代表照片沒標籤。
逐項轉換並保留 JSON 值
將下方完整程式存為 metadata_to_tag_rows.py。程式是一個實體行,以反斜線跳脫保留內部換行,請完整保留引號及跳脫字元。它唯讀 JSON,先檢查所有紀錄再新建輸出,拒絕覆寫並回讀 CSV 逐欄比較。未知欄位、重複鍵、非陣列或非字串會停止。
exec('"""Convert a bounded ExifTool JSON export to traceable tag rows; no image writes."""\nimport csv\nimport json\nimport sys\nfrom pathlib import Path\n\nGROUPS = (\'XMP-lr:HierarchicalSubject\', \'XMP-digiKam:TagsList\')\nHEADER = [\'source_record\', \'SourceFile\', \'tag_group\', \'status\', \'item_index\', \'tag_value\']\n\ndef unique_object(pairs):\n result = {}\n for key, value in pairs:\n if key in result:\n raise ValueError(\'Duplicate JSON key; retain the original export\')\n result[key] = value\n return result\n\ndef convert(input_path, output_path):\n data = json.loads(Path(input_path).read_text(encoding=\'utf-8-sig\'), object_pairs_hook=unique_object)\n if not isinstance(data, list):\n raise ValueError(\'Expected the JSON array from the stated ExifTool command\')\n rows = []\n present = 0\n for record_number, record in enumerate(data, 1):\n if not isinstance(record, dict) or not set(record) <= {\'SourceFile\', *GROUPS}:\n raise ValueError(\'Unexpected fields, warning or error; inspect the JSON and stderr\')\n source = record.get(\'SourceFile\')\n if not isinstance(source, str) or not source:\n raise ValueError(\'Expected a nonempty SourceFile string\')\n for group in GROUPS:\n if group not in record:\n rows.append([str(record_number), source, group, \'absent\', \'\', \'\'])\n continue\n values = record[group]\n if not isinstance(values, list) or any(not isinstance(value, str) for value in values):\n raise ValueError(\'Expected string arrays; recheck -j -G1 -struct without -sep\')\n if not values:\n rows.append([str(record_number), source, group, \'empty\', \'\', \'\'])\n for index, value in enumerate(values, 1):\n rows.append([str(record_number), source, group, \'present\', str(index), value])\n present += 1\n with open(output_path, \'x\', encoding=\'utf-8-sig\', newline=\'\') as output:\n writer = csv.writer(output)\n writer.writerow(HEADER)\n writer.writerows(rows)\n with open(output_path, encoding=\'utf-8-sig\', newline=\'\') as output:\n if list(csv.reader(output)) != [HEADER] + rows:\n raise ValueError(\'Readback mismatch; discard this output, retain the JSON\')\n print(f\'{len(data)} source records; {present} present list items; {len(rows)} data rows checked\')\n\nif __name__ == \'__main__\':\n if len(sys.argv) != 3:\n raise SystemExit(\'Usage: python3 metadata_to_tag_rows.py metadata.json tags.csv\')\n convert(sys.argv[1], sys.argv[2])\n')
以新檔名執行 python3 metadata_to_tag_rows.py metadata.json tags.csv。六欄為 source_record、SourceFile、tag_group、status、item_index、tag_value。present 各列保留一個原始項目,absent、empty 佔位保留檔案與屬性界線。不刪除重複檔名、清單值或空字串;順序只代表這次 JSON 擷取次序,不保證 XMP Bag 的語義順序。
核對表格與適用範圍
以 UTF-8、逗號與雙引號限定符匯入,六欄設為文字,關閉公式計算及日期、數字自動轉換。對照 JSON 檢查含逗號的值、不同階層下同名末級標籤、兩個欄位及預期缺欄。數解析後紀錄,不數實體行;值可含換行。
程式在 Python 3.12.14 通過六個有效合成 JSON、八個無效案例及六次拒絕覆寫,涵蓋 Unicode、引號、換行、重複值、檔名及缺失/空清單差異。未執行 ExifTool、digiKam、真實影像中繼資料、Windows 或 macOS。寫入或回讀失敗時丟棄不完整 CSV,保留 JSON;不保證完整圖庫、臉部區域、影像與邊車對帳或大型集合。