기술 · 실용 가이드
digiKam 키워드를 CSV로 내보내며 태그 목록 경계 보존하기
용어 계층과 파일별 키워드 표는 다르다. ExifTool JSON 배열·입력 파일명·네임스페이스를 유지한 뒤 행으로 바꾸자.
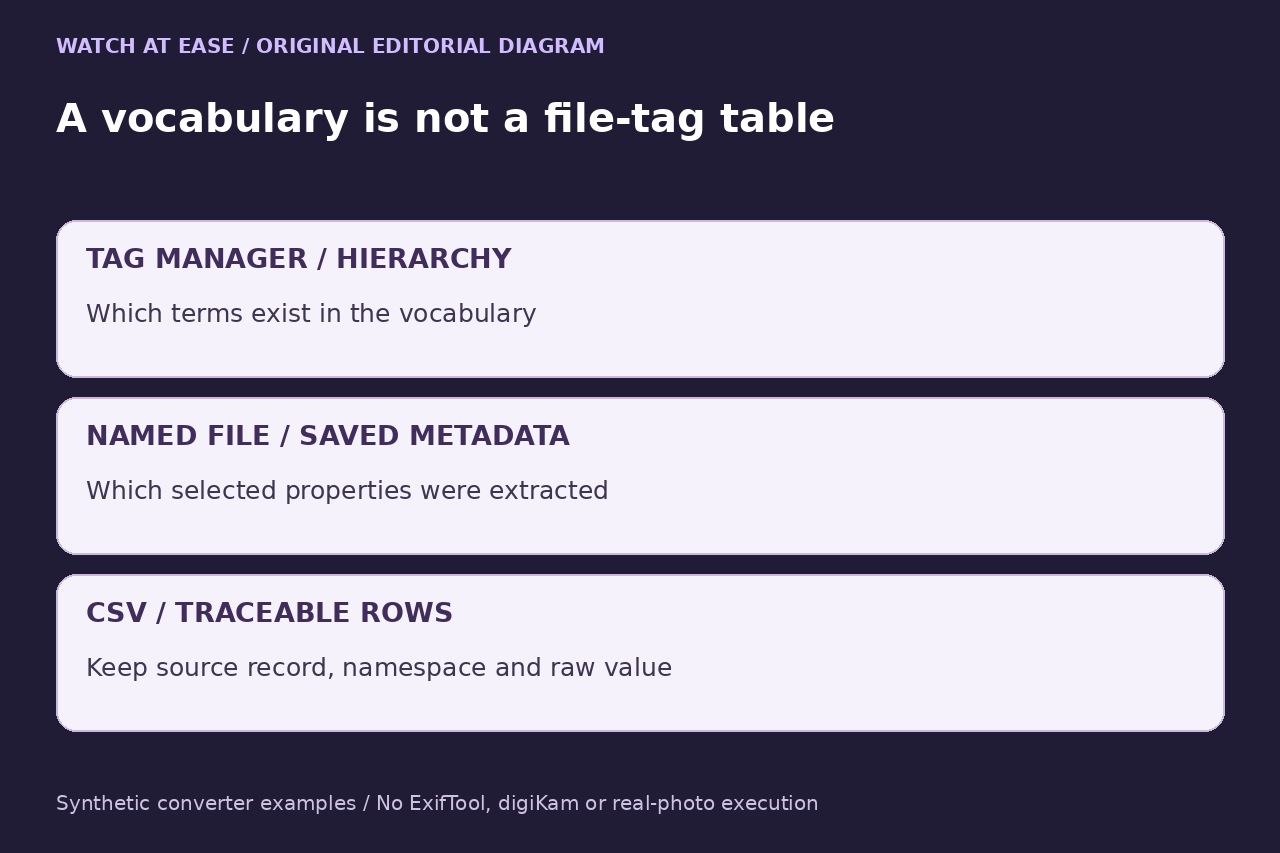
저장된 키워드가 어느 파일에서 왔는지 표로 만들려면 태그 트리 화면 대신 파일 메타데이터를 읽는다. 현재 digiKam은 태그 계층을 내보낼 수 있지만 이는 파일별 할당 표가 아니다. 데이터베이스에만 있는 변경은 아래 방법의 대상이 아니다.
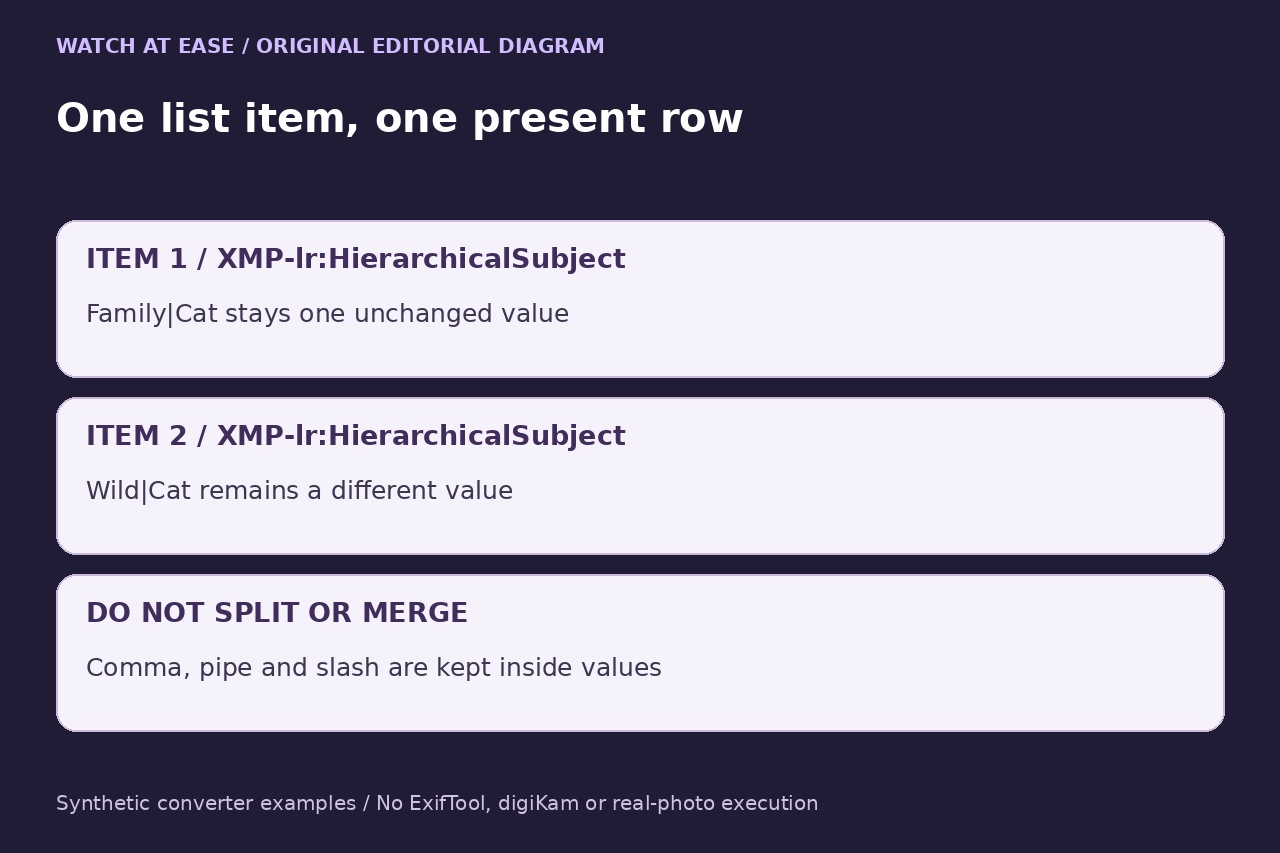
변환기는 추출 목록 항목마다 CSV 행을 만들고 네임스페이스를 보존한다. 값 안의 쉼표·파이프·슬래시를 나누거나 다른 필드를 합치거나 사진을 수정하지 않는다. 검토용 내보내기이며 전체 백업이나 자동 복구가 아니다.
어떤 증거를 읽을지 정하기
알려진 파일 하나와 digiKam 표시부터 비교한다. 필요한 키워드가 DB에만 있으면 멈춘다. 파일 읽기로는 얻을 수 없다. 기존 백업·동기화 절차로 차이를 해결하며 이 방법으로 자동 메타데이터 기록이나 DB 변경을 하지 않는다.
.xmp를 지정하면 SourceFile은 그 사이드카이며 자동 연결한 사진이 아니다. 사진과 사이드카를 모두 내보내면 두 레코드를 보존해 비교하고 임의로 합치지 않는다. 저장된 선택 목록 XML도 다른 증거이며 이 키워드 값을 제공하지 않는다.
읽기 전용 명령으로 배열 추출
설치한 ExifTool과 알려진 입력 사본 하나로 시작한다. Linux Bash에서 사진 폴더 밖에 새 출력 이름을 정하고 입력 경로를 바꿔 다음 명령을 실행한다. 지정한 두 XMP 속성을 읽을 뿐 값을 쓰거나 CSV·JSON을 가져오지 않는다.
exiftool -j -G1 -struct -XMP-lr:HierarchicalSubject -XMP-digiKam:TagsList -- "/path/to/input.jpg" > metadata.json 2> metadata-errors.txt
변환 전에 종료 상태·표준 오류·JSON을 확인한다. 경고·오류를 조사하되 일반 파일 수 요약은 오류와 구분한다. -j -G1 -struct를 유지하고 항목을 합치는 -sep는 빼자. 현재 문서는 -struct가 단일 XMP 항목도 배열로 유지한다고 설명한다. 두 필드는 다를 수 있고 누락됐다고 태그가 없다는 뜻은 아니다.
JSON 목록 항목을 그대로 행으로
다음 전체 프로그램을 metadata_to_tag_rows.py로 저장한다. 한 물리적 줄이며 내부 줄바꿈을 백슬래시 이스케이프로 표현하므로 따옴표와 이스케이프를 그대로 보존한다. JSON만 읽고 전체 검증 후 새 CSV를 만들며 기존 출력 덮어쓰기를 거부하고 모든 필드를 다시 비교한다. 알 수 없는 필드·중복 키·비배열·비문자열은 중단한다.
exec('"""Convert a bounded ExifTool JSON export to traceable tag rows; no image writes."""\nimport csv\nimport json\nimport sys\nfrom pathlib import Path\n\nGROUPS = (\'XMP-lr:HierarchicalSubject\', \'XMP-digiKam:TagsList\')\nHEADER = [\'source_record\', \'SourceFile\', \'tag_group\', \'status\', \'item_index\', \'tag_value\']\n\ndef unique_object(pairs):\n result = {}\n for key, value in pairs:\n if key in result:\n raise ValueError(\'Duplicate JSON key; retain the original export\')\n result[key] = value\n return result\n\ndef convert(input_path, output_path):\n data = json.loads(Path(input_path).read_text(encoding=\'utf-8-sig\'), object_pairs_hook=unique_object)\n if not isinstance(data, list):\n raise ValueError(\'Expected the JSON array from the stated ExifTool command\')\n rows = []\n present = 0\n for record_number, record in enumerate(data, 1):\n if not isinstance(record, dict) or not set(record) <= {\'SourceFile\', *GROUPS}:\n raise ValueError(\'Unexpected fields, warning or error; inspect the JSON and stderr\')\n source = record.get(\'SourceFile\')\n if not isinstance(source, str) or not source:\n raise ValueError(\'Expected a nonempty SourceFile string\')\n for group in GROUPS:\n if group not in record:\n rows.append([str(record_number), source, group, \'absent\', \'\', \'\'])\n continue\n values = record[group]\n if not isinstance(values, list) or any(not isinstance(value, str) for value in values):\n raise ValueError(\'Expected string arrays; recheck -j -G1 -struct without -sep\')\n if not values:\n rows.append([str(record_number), source, group, \'empty\', \'\', \'\'])\n for index, value in enumerate(values, 1):\n rows.append([str(record_number), source, group, \'present\', str(index), value])\n present += 1\n with open(output_path, \'x\', encoding=\'utf-8-sig\', newline=\'\') as output:\n writer = csv.writer(output)\n writer.writerow(HEADER)\n writer.writerows(rows)\n with open(output_path, encoding=\'utf-8-sig\', newline=\'\') as output:\n if list(csv.reader(output)) != [HEADER] + rows:\n raise ValueError(\'Readback mismatch; discard this output, retain the JSON\')\n print(f\'{len(data)} source records; {present} present list items; {len(rows)} data rows checked\')\n\nif __name__ == \'__main__\':\n if len(sys.argv) != 3:\n raise SystemExit(\'Usage: python3 metadata_to_tag_rows.py metadata.json tags.csv\')\n convert(sys.argv[1], sys.argv[2])\n')
새 이름으로 python3 metadata_to_tag_rows.py metadata.json tags.csv를 실행한다. 여섯 열은 source_record·SourceFile·tag_group·status·item_index·tag_value다. present 행은 원래 항목 하나, absent·empty 행은 파일과 속성 경계를 유지한다. 반복 파일명·값·빈 문자열을 제거하지 않는다. 번호는 이번 추출 순서일 뿐 의미상 우선순위나 XMP Bag 고정 순서가 아니다.
표와 실제 시험 범위 확인
UTF-8·쉼표·큰따옴표로 가져오고 여섯 열을 텍스트로 설정하며 수식 평가와 날짜·숫자 자동 변환을 끈다. 쉼표 포함 값·다른 계층의 같은 말단 이름·두 필드·누락 필드를 JSON과 비교한다. 값에 줄바꿈이 있을 수 있으므로 물리적 줄이 아닌 파싱된 레코드를 센다.
Python3.12.14에서 유효 합성 JSON 여섯 건·무효 여덟 건·덮어쓰기 거부 여섯 건을 확인했다. Unicode·따옴표·줄바꿈·반복 값과 파일명·누락과 빈 목록을 포함한다. ExifTool·digiKam·실제 이미지·Windows·macOS는 실행하지 않았다. 기록·재읽기 실패 시 불완전 CSV를 버리고 JSON을 보관한다. 전체 라이브러리·얼굴 영역·사진과 사이드카 대조·대규모 처리를 보장하지 않는다.