テクノロジー · 実用ガイド
digiKamのキーワードをCSVへ タグ配列の区切りを失わずに出力
語彙の階層とファイル別キーワード表は別物。ExifToolのJSON配列、入力ファイル名、名前空間を保って行に変換する。
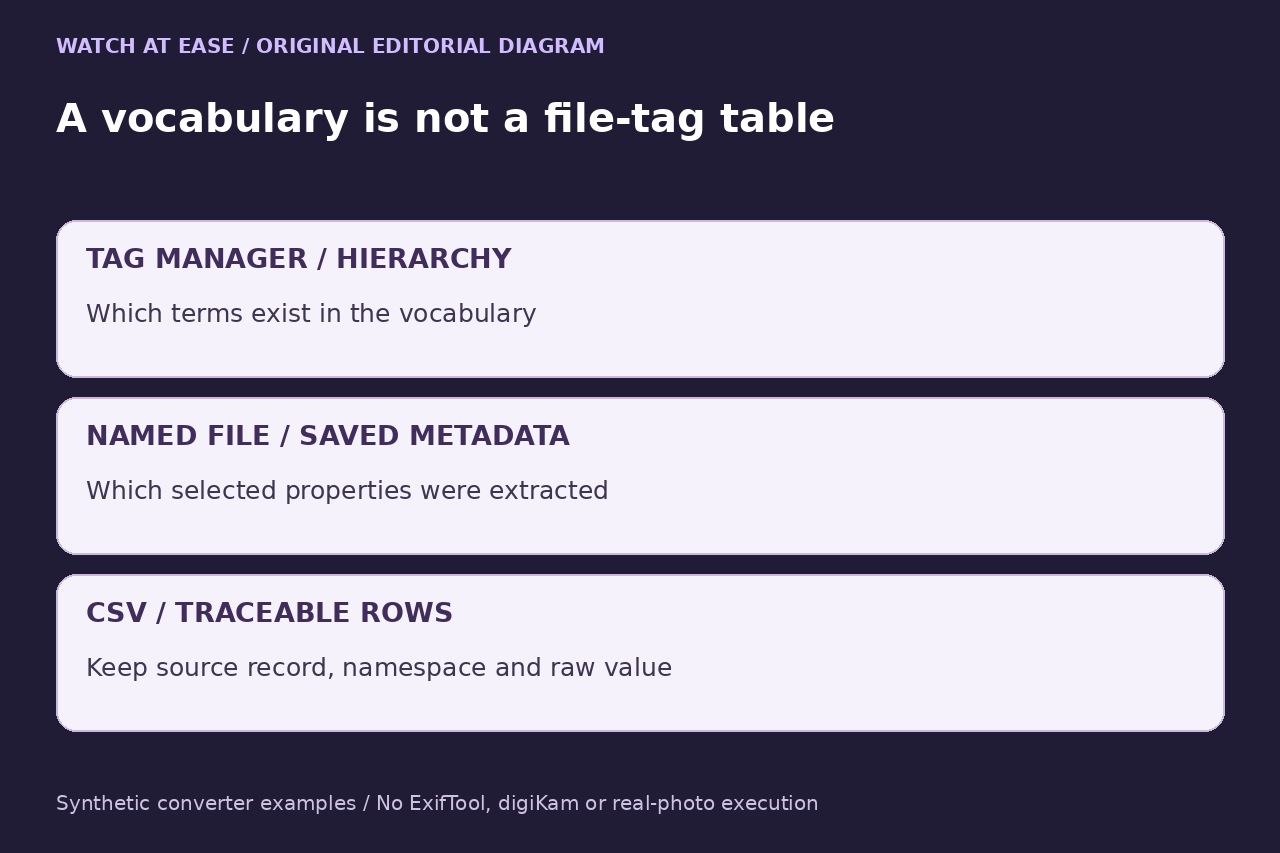
保存されたキーワードがどのファイル由来か表にするなら、タグツリーの画像ではなくファイルのメタデータを読む。現在のdigiKamはタグ階層をエクスポートできるが、その語彙は全ファイルの割り当て表ではない。データベースだけの変更は以下の対象外だ。
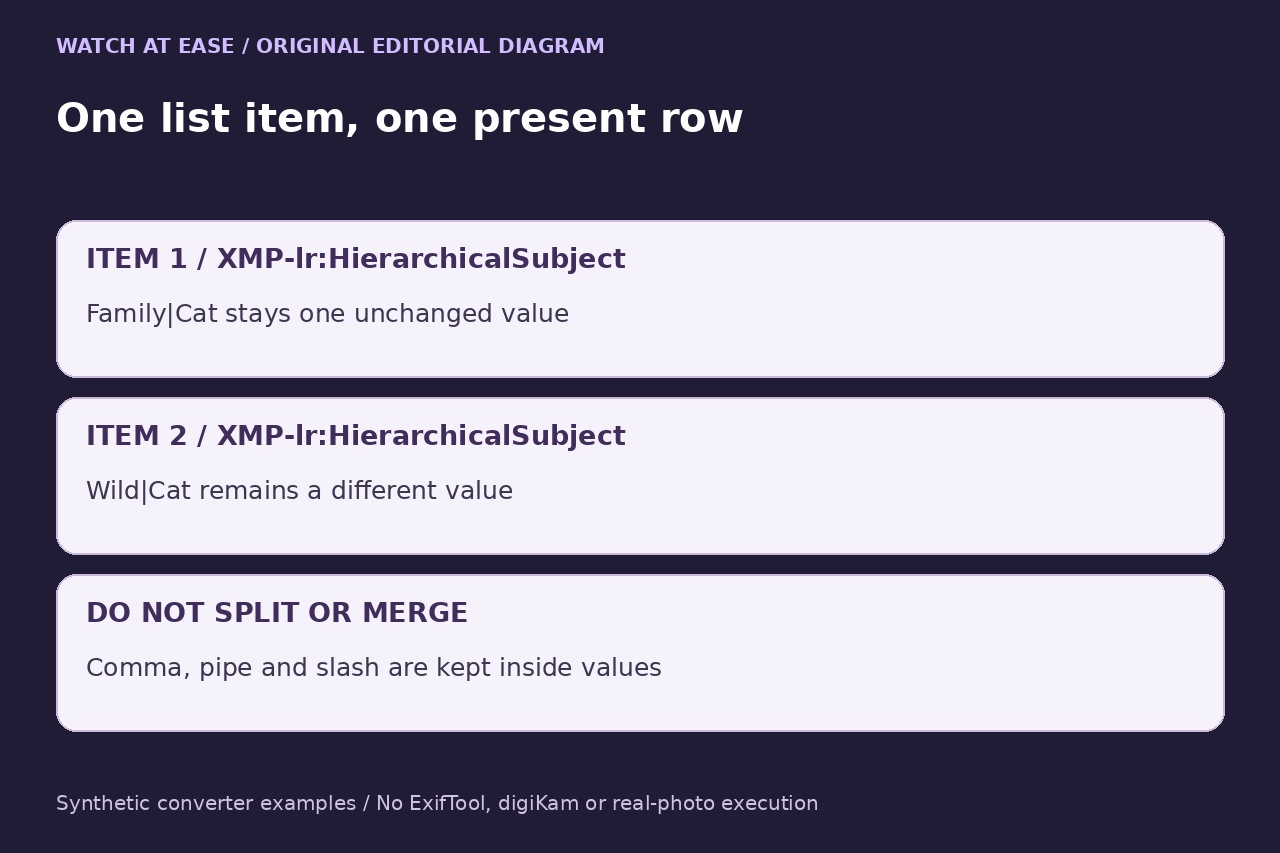
変換器は抽出したリスト項目ごとにCSV行を作り、名前空間を残す。値のカンマ、縦線、スラッシュを分割せず、別フィールドを統合せず、写真を変更しない。検査用出力であり完全バックアップや自動修復ではない。
読む証拠の範囲を決める
まず既知のファイルとdigiKam表示を比較する。必要な値がデータベースだけなら止める。ファイル読み取りでは取得できない。既存のバックアップ・同期手順で差を解決し、この方法で自動的に書き込んだりデータベースを変更したりしない。
.xmpを指定した場合SourceFileはそのサイドカーであり自動対応した写真ではない。写真とサイドカーを両方出力したら両レコードを比較し、勝手に統合しない。選択リストXMLも別の証拠で、このキーワード値は含まない。
読み取り専用コマンドで配列を抽出
導入済みExifToolを使い、既知の入力コピー一つから始める。Linux Bashで写真フォルダー外の新規出力名を選び、入力パスを置き換えて以下を実行する。二つのXMP属性を要求するだけで、値の設定やCSV・JSONの取り込みはしない。
exiftool -j -G1 -struct -XMP-lr:HierarchicalSubject -XMP-digiKam:TagsList -- "/path/to/input.jpg" > metadata.json 2> metadata-errors.txt
終了状態、標準エラー、JSONを確認してから変換する。警告やエラーは調査し、通常のファイル件数表示と区別する。-j -G1 -structを残し、項目を結合する-sepを付けない。現行文書では-structは単一項目も配列にする。両フィールドは異なり得て、欠落だけでタグなしとは判断できない。
JSONの各項目をそのまま行へ
以下の完全なプログラムをmetadata_to_tag_rows.pyに保存する。一つの物理行で、内部の改行をバックスラッシュのエスケープで表す。引用符とエスケープをそのまま保持する。JSONだけを読み、全件検証後に新規CSVを作り、既存出力を拒否して全フィールドを再読込比較する。不明フィールド、重複キー、非配列、非文字列は停止する。
exec('"""Convert a bounded ExifTool JSON export to traceable tag rows; no image writes."""\nimport csv\nimport json\nimport sys\nfrom pathlib import Path\n\nGROUPS = (\'XMP-lr:HierarchicalSubject\', \'XMP-digiKam:TagsList\')\nHEADER = [\'source_record\', \'SourceFile\', \'tag_group\', \'status\', \'item_index\', \'tag_value\']\n\ndef unique_object(pairs):\n result = {}\n for key, value in pairs:\n if key in result:\n raise ValueError(\'Duplicate JSON key; retain the original export\')\n result[key] = value\n return result\n\ndef convert(input_path, output_path):\n data = json.loads(Path(input_path).read_text(encoding=\'utf-8-sig\'), object_pairs_hook=unique_object)\n if not isinstance(data, list):\n raise ValueError(\'Expected the JSON array from the stated ExifTool command\')\n rows = []\n present = 0\n for record_number, record in enumerate(data, 1):\n if not isinstance(record, dict) or not set(record) <= {\'SourceFile\', *GROUPS}:\n raise ValueError(\'Unexpected fields, warning or error; inspect the JSON and stderr\')\n source = record.get(\'SourceFile\')\n if not isinstance(source, str) or not source:\n raise ValueError(\'Expected a nonempty SourceFile string\')\n for group in GROUPS:\n if group not in record:\n rows.append([str(record_number), source, group, \'absent\', \'\', \'\'])\n continue\n values = record[group]\n if not isinstance(values, list) or any(not isinstance(value, str) for value in values):\n raise ValueError(\'Expected string arrays; recheck -j -G1 -struct without -sep\')\n if not values:\n rows.append([str(record_number), source, group, \'empty\', \'\', \'\'])\n for index, value in enumerate(values, 1):\n rows.append([str(record_number), source, group, \'present\', str(index), value])\n present += 1\n with open(output_path, \'x\', encoding=\'utf-8-sig\', newline=\'\') as output:\n writer = csv.writer(output)\n writer.writerow(HEADER)\n writer.writerows(rows)\n with open(output_path, encoding=\'utf-8-sig\', newline=\'\') as output:\n if list(csv.reader(output)) != [HEADER] + rows:\n raise ValueError(\'Readback mismatch; discard this output, retain the JSON\')\n print(f\'{len(data)} source records; {present} present list items; {len(rows)} data rows checked\')\n\nif __name__ == \'__main__\':\n if len(sys.argv) != 3:\n raise SystemExit(\'Usage: python3 metadata_to_tag_rows.py metadata.json tags.csv\')\n convert(sys.argv[1], sys.argv[2])\n')
新規名でpython3 metadata_to_tag_rows.py metadata.json tags.csvを実行する。列はsource_record、SourceFile、tag_group、status、item_index、tag_value。presentは原文項目一つ、absentとemptyはファイル・属性境界を残す行だ。同名ファイル、重複値、空文字列を削除しない。項目番号は今回の抽出順であり、意味上の優先順位やXMP Bagの固定順ではない。
表と実証範囲を確認する
UTF-8、カンマ区切り、二重引用符で取り込み、全六列を文字列にして式評価や日付・数値自動変換を無効にする。カンマ入り値、別階層の同名末端、両属性、欠落属性をJSONと照合する。値に改行があり得るため物理行ではなく解析レコードを数える。
Python3.12.14で有効合成JSON六件、無効八件、上書き拒否六件を確認した。Unicode、引用符、改行、重複値・ファイル名、欠落と空配列を含む。ExifTool、digiKam、実画像、Windows、macOSは実行していない。書込み・再読込失敗時は不完全CSVを破棄しJSONを残す。全ライブラリ、顔領域、写真とサイドカーの照合、大量処理を保証しない。