Tecnología · GUÍA PRÁCTICA
Exporta palabras clave de digiKam a CSV sin aplanar las listas
Un vocabulario y una tabla por archivo son resultados distintos. Conserva las matrices JSON de ExifTool, el archivo de origen y el espacio de nombres al crear filas.
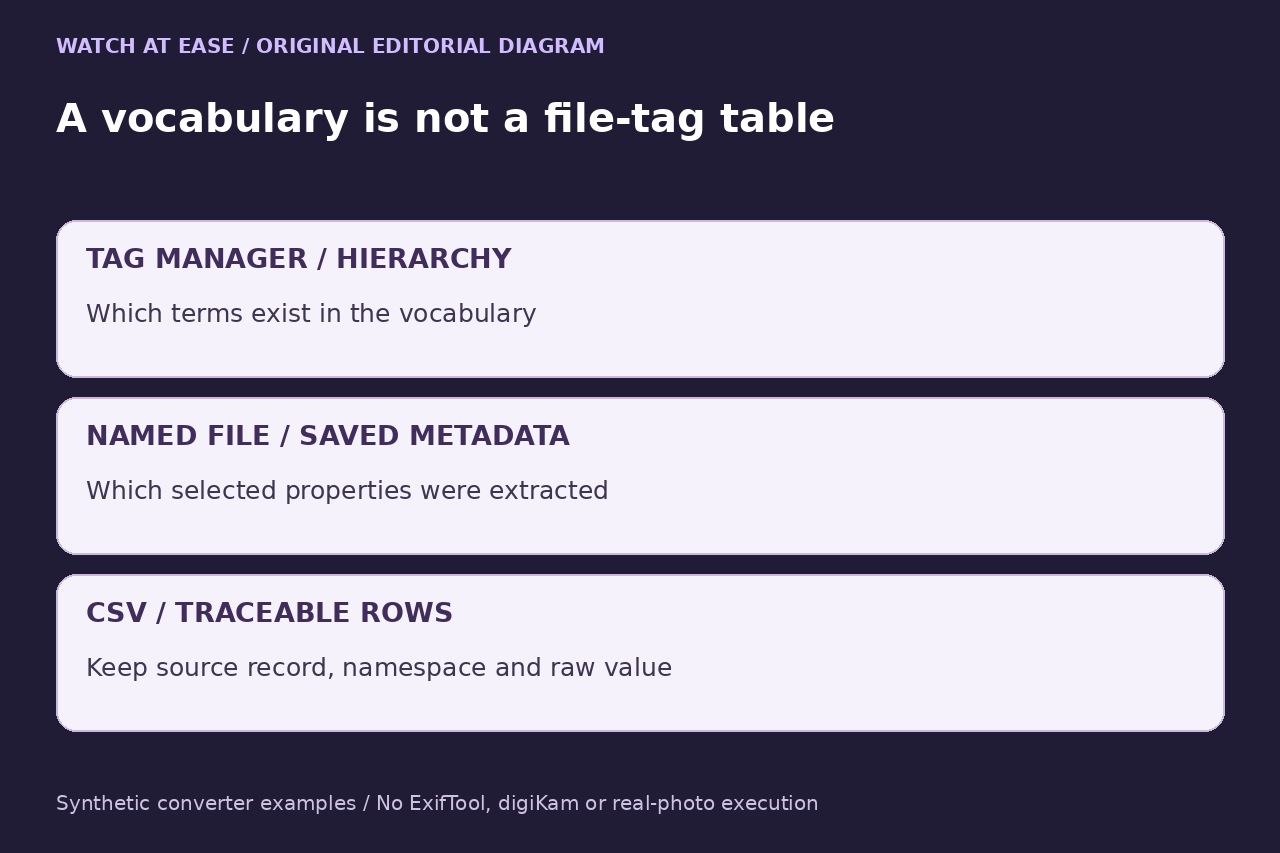
Para saber qué palabras clave guardadas proceden de cada archivo, lee sus metadatos en lugar de capturar el árbol de etiquetas. El gestor actual de digiKam puede exportar una jerarquía, pero ese vocabulario no es la tabla de asignaciones de todos los archivos. Los cambios que solo están en la base de datos quedan fuera de este método.
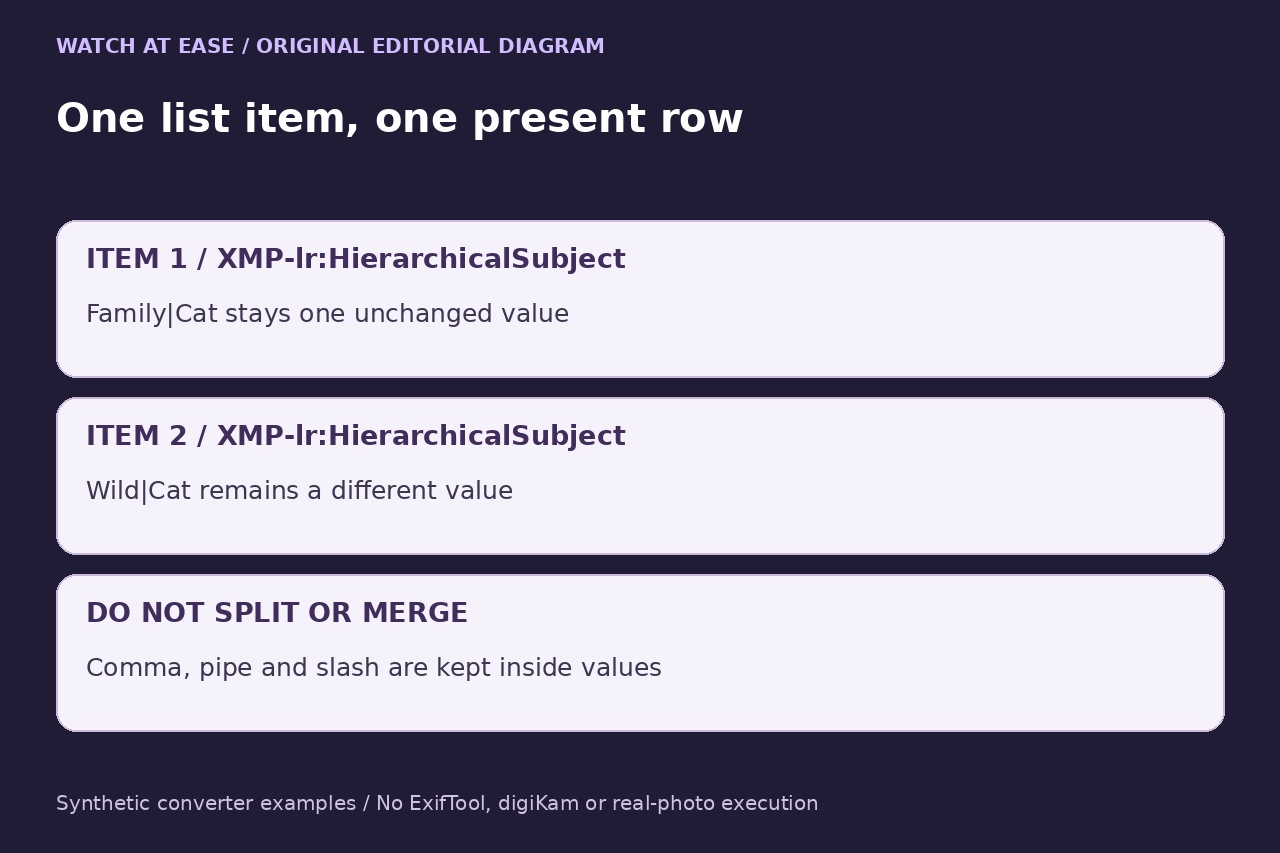
El conversor crea una fila por elemento extraído y conserva su espacio de nombres. No divide comas, barras verticales o inclinadas dentro del valor, no combina propiedades ni modifica fotos. Es una exportación para inspección, no una copia completa de digiKam ni una reparación automática.
Elige qué evidencia quieres leer
Compara primero un archivo conocido con digiKam. Si las palabras esperadas solo existen en la base de datos, detente: leer el archivo no las exportará. Resuelve esa diferencia mediante tu proceso habitual de copia y sincronización; esta receta no escribe metadatos ni modifica la base automáticamente.
Si nombras un .xmp, SourceFile identifica ese archivo lateral, no una foto emparejada automáticamente. Si exportas imagen y XMP, conserva ambos registros y compáralos sin fusionarlos ni elegir un ganador. El XML de una lista de selección es otra evidencia y no proporciona estos valores de palabras clave.
Extrae matrices con un comando de solo lectura
Usa ExifTool instalado y empieza con una copia conocida. En Linux Bash, elige nombres nuevos fuera de la carpeta fotográfica, sustituye la ruta y ejecuta lo siguiente. Solo solicita dos propiedades XMP: no asigna valores ni importa CSV o JSON.
exiftool -j -G1 -struct -XMP-lr:HierarchicalSubject -XMP-digiKam:TagsList -- "/path/to/input.jpg" > metadata.json 2> metadata-errors.txt
Comprueba estado de salida, stderr y JSON antes de convertir. Investiga errores o advertencias; un resumen normal de archivos no es por sí mismo un error. Conserva -j -G1 -struct y omite -sep, que uniría elementos. La documentación actual indica que -struct mantiene también listas XMP de un elemento como matrices. Las propiedades pueden diferir y una ausente no demuestra que la foto carezca de etiquetas.
Convierte cada elemento sin modificarlo
Guarda el programa completo siguiente como metadata_to_tag_rows.py. Es una sola línea física con escapes de barra inversa para los saltos internos; conserva comillas y escapes intactos. Solo lee JSON, valida todos los registros antes de crear un CSV nuevo, rechaza destinos existentes y relee cada campo. Propiedades desconocidas, claves duplicadas, listas no matriciales o elementos no textuales detienen la conversión.
exec('"""Convert a bounded ExifTool JSON export to traceable tag rows; no image writes."""\nimport csv\nimport json\nimport sys\nfrom pathlib import Path\n\nGROUPS = (\'XMP-lr:HierarchicalSubject\', \'XMP-digiKam:TagsList\')\nHEADER = [\'source_record\', \'SourceFile\', \'tag_group\', \'status\', \'item_index\', \'tag_value\']\n\ndef unique_object(pairs):\n result = {}\n for key, value in pairs:\n if key in result:\n raise ValueError(\'Duplicate JSON key; retain the original export\')\n result[key] = value\n return result\n\ndef convert(input_path, output_path):\n data = json.loads(Path(input_path).read_text(encoding=\'utf-8-sig\'), object_pairs_hook=unique_object)\n if not isinstance(data, list):\n raise ValueError(\'Expected the JSON array from the stated ExifTool command\')\n rows = []\n present = 0\n for record_number, record in enumerate(data, 1):\n if not isinstance(record, dict) or not set(record) <= {\'SourceFile\', *GROUPS}:\n raise ValueError(\'Unexpected fields, warning or error; inspect the JSON and stderr\')\n source = record.get(\'SourceFile\')\n if not isinstance(source, str) or not source:\n raise ValueError(\'Expected a nonempty SourceFile string\')\n for group in GROUPS:\n if group not in record:\n rows.append([str(record_number), source, group, \'absent\', \'\', \'\'])\n continue\n values = record[group]\n if not isinstance(values, list) or any(not isinstance(value, str) for value in values):\n raise ValueError(\'Expected string arrays; recheck -j -G1 -struct without -sep\')\n if not values:\n rows.append([str(record_number), source, group, \'empty\', \'\', \'\'])\n for index, value in enumerate(values, 1):\n rows.append([str(record_number), source, group, \'present\', str(index), value])\n present += 1\n with open(output_path, \'x\', encoding=\'utf-8-sig\', newline=\'\') as output:\n writer = csv.writer(output)\n writer.writerow(HEADER)\n writer.writerows(rows)\n with open(output_path, encoding=\'utf-8-sig\', newline=\'\') as output:\n if list(csv.reader(output)) != [HEADER] + rows:\n raise ValueError(\'Readback mismatch; discard this output, retain the JSON\')\n print(f\'{len(data)} source records; {present} present list items; {len(rows)} data rows checked\')\n\nif __name__ == \'__main__\':\n if len(sys.argv) != 3:\n raise SystemExit(\'Usage: python3 metadata_to_tag_rows.py metadata.json tags.csv\')\n convert(sys.argv[1], sys.argv[2])\n')
Ejecuta python3 metadata_to_tag_rows.py metadata.json tags.csv con un nombre nuevo. Las seis columnas son source_record, SourceFile, tag_group, status, item_index y tag_value. Cada fila present conserva un elemento intacto; absent y empty retienen la frontera archivo/propiedad. No se deduplican nombres, valores o cadenas vacías. El índice representa el orden de esta extracción, no una prioridad semántica ni un orden garantizado de XMP Bag.
Verifica la tabla y sus límites
Importa como UTF-8, separado por comas y con comillas dobles. Configura las seis columnas como Texto y desactiva fórmulas y conversiones automáticas de fechas/números. Compara con JSON un valor con coma, hojas iguales de jerarquías diferentes, ambas propiedades y una ausencia esperada. Cuenta registros analizados, no líneas físicas: un valor puede contener saltos de línea.
El programa mostrado pasó seis casos JSON sintéticos válidos, ocho inválidos y seis negativas a sobrescribir en Python 3.12.14. Incluyeron Unicode, comillas, saltos, valores y nombres repetidos, y ausencia frente a lista vacía. No ejecutamos ExifTool, digiKam, metadatos reales, Windows ni macOS. Si falla la escritura o relectura, descarta el CSV parcial y conserva JSON. No se garantiza toda la biblioteca, regiones faciales, reconciliación de imagen/XMP ni grandes colecciones.