科技 · 新闻解读
DeepSeek V4.1-Flash-1017 已上线:变化与开发者核验清单
DeepSeek 10 月 17 日的检查点已进入网站、应用和 API,Hugging Face 提供 MIT 许可权重,Search 与 Fetch API 也向开发者开放。基准提升来自厂商自报,团队仍应在自身负载上测试提示编码、工具行为、延迟和总成本。
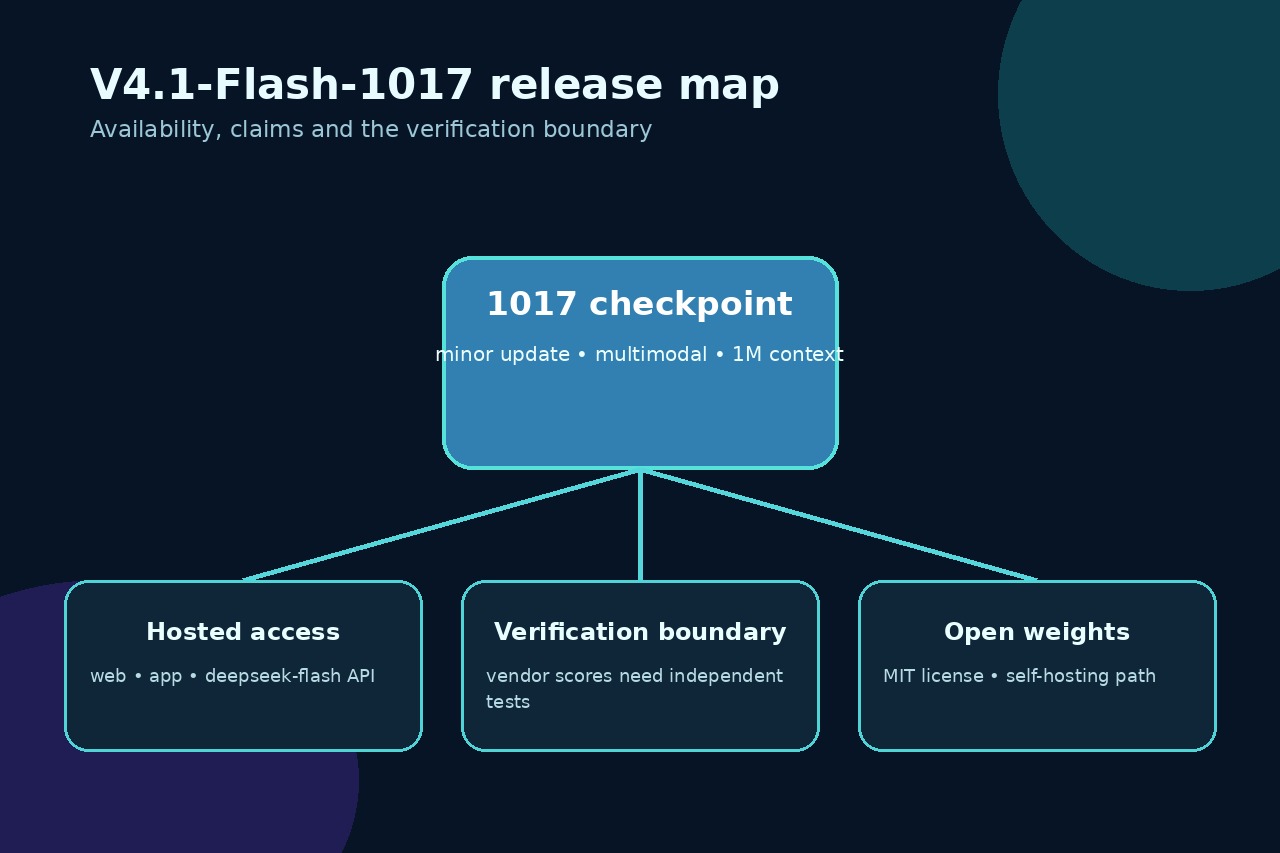
DeepSeek 于 10 月 17 日发布 V4.1-Flash-1017,称其为 V4.1-Flash 的小幅检查点更新。官方称推理、编程、代理与视觉基准有所提升,同时任务耗时和输出长度下降。更新通过网站、应用及现有 deepseek-flash API 名称提供,模型卡还给出 MIT 许可权重。Search 与 Fetch API 同时向开发者开放。
实际发布了什么
官方模型卡把 1017 称为检查点更新,而非新架构。它列出文本和图像输入、文本输出、100 万 token 上下文,并给出 temperature 1.0、top-p 1.0 的建议设置。仓库含权重及 Transformers、vLLM、SGLang 部署说明;独立报道指出托管端继续使用 deepseek-flash 名称。
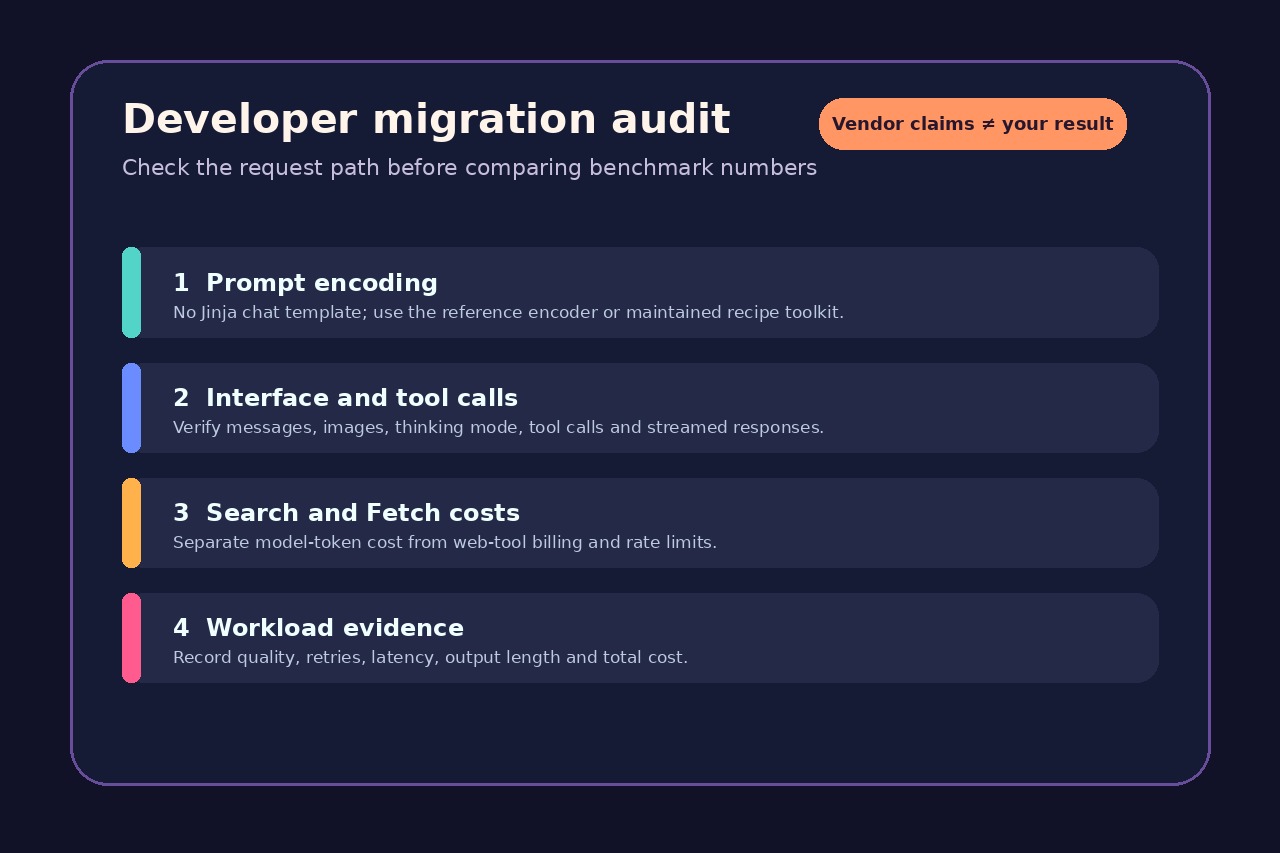
Search 返回排序结果,Fetch 把指定页面转成 Markdown。二者与模型推理分开,因此必须分别记录 token 费用、工具请求费、限速和临时优惠。
基准表是声明,不是独立结论
DeepSeek 自报 11 项基准均优于 9 月检查点,其中 DeepSWE v1.1 从 74.2 升至 77.0,Terminal-Bench 4.0 从 31.2 升至 42.3。表格也显示 Claude Opus 5 在 HLE、Terminal-Bench、ProgramBench 和 NL2Repo-Bench 领先。两家独立报道均明确把数字归因于 DeepSeek。
基准会受运行框架、提示、工具和通过规则影响。模型卡说明 Terminal-Bench 使用 Claude Code 框架,DeepSWE 使用 Mini-SWE-V2。77.0 不能自动等于你的代码库任务更好、重试更少或总成本更低。
先核提示编码
模型卡说明本次没有 Jinja 聊天模板,encoding 目录提供 Python 参考实现,覆盖多轮、工具调用、思考模式、推理强度、会话中系统消息和交错图像。生产环境还可使用带 Python 绑定的 deepseek-recipe。
比较质量前,要确认旧新路径序列化一致,并记录系统消息位置、图像顺序、工具参数与结果、思考设置、停止条件和流式解析。请求层差异可能被误判为模型退步。
托管与自托管回答不同问题
托管测试适合观察现有接入的质量、延迟和 token 使用;自托管测试则回答硬件、内存、量化和吞吐可行性。Hugging Face 页面显示这是大型检查点,且当前未列出直接托管该仓库的推理提供商,因此不能在没有硬件证据时称其为普通笔记本可用。
用真实任务构建小型评估集,记录成功标准、质量、重试、输入输出 token、工具调用、耗时和失败。编程任务应包含查库、修改、测试及命令失败后的恢复。
实用迁移清单
先确认账户里的 deepseek-flash 是否已表现为 1017;需要复现时固定仓库版本;测试工具和图像前验证编码器;把 token 与 Search/Fetch 请求费分开;保存原始输出供复核。
不要直接把发布表格变成采购结论。安全试运行应限定负载、保留回滚、审查托管隐私并设置成本上限。真正优势要等你的工作负载独立复现。