科技 · 实用指南
Calibre 的 CSV 目录漏掉阅读器独有书籍?导出设备缓存清单
电脑书库目录可能漏掉只在阅读器上的书。先复制设备缓存,再核对导出行数、存储位置和表格导入设置。
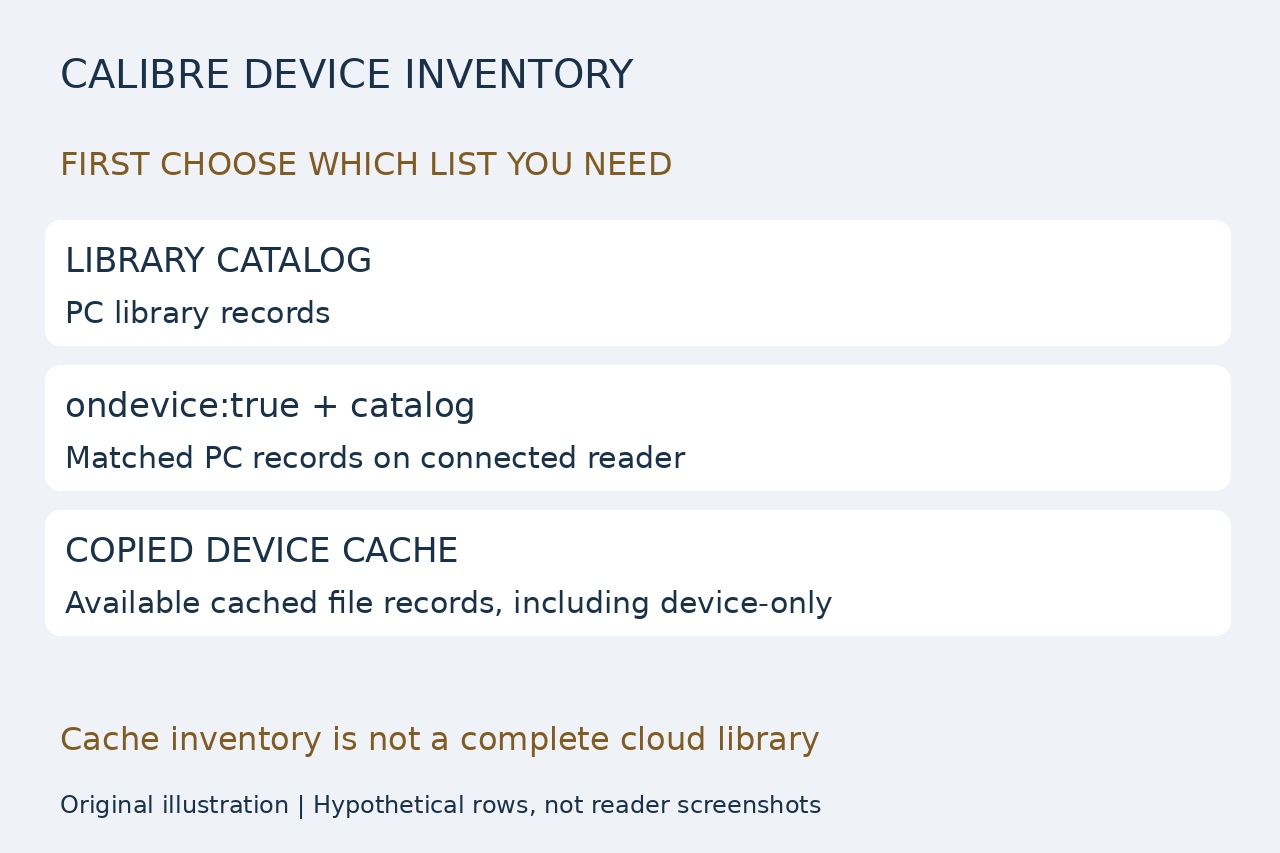
想把阅读器上的书列成 CSV,电脑书库的目录可能不是你需要的清单。在书库中使用 ondevice:true,仍从书库已有记录开始,不会补入只存在于设备上的书。
如果已有可读取的 metadata.calibre 或 .metadata.calibre,下述只处理副本的方法能导出其中的缓存记录,无须把电子书内容导入电脑书库。它是缓存清单,不能保证列出全部云端购买项目或所有阅读器上的全部文件。
记录存储位置,再复制缓存
仅在设备或受管理文件夹提供本地 Calibre 格式 JSON 缓存时使用。让当前 Calibre 设备扫描和任务结束,记录所列存储位置,并在清除筛选后记录 Device 视图的数量,再关闭可能改写缓存的应用。正常扫描可能更新缓存;转换命令只读取电脑上的副本。这不是取证用的全程只读采集流程。
把缓存复制到电脑的新文件夹,命名为 metadata-copy.json,原文件留在原处。记录原目录、存储标签和复制时间。主内存和存储卡可能各有缓存,要分别处理并使用不同输出名。没有可读缓存就停止本方法,不要把电脑书库的导出冒充完整设备清单。不要用这个 JSON 替换 metadata.db。
每条缓存记录导出一行 CSV
已安装 Python 3 时,在副本文件夹打开终端;Windows 把 python3 改成 py -3。将下面命令作为一整行复制,保留直引号,并选择新的输出文件名。它要求输入为 JSON 数组,且每条记录的 lpath 是字符串;所有记录都会保留,已有 CSV 不会被覆盖。
python3 -c "import csv,json,sys; r=json.load(open(sys.argv[1],encoding='utf-8-sig')); assert isinstance(r,list) and all(isinstance(b,dict) and isinstance(b.get('lpath'),str) for b in r), 'Expected an array of records with lpath'; f=open(sys.argv[2],'x',encoding='utf-8-sig',newline=''); w=csv.writer(f); w.writerow(['row','lpath','title','authors_json','series','series_index']); w.writerows([[i,b['lpath'],b.get('title'),json.dumps(b.get('authors'),ensure_ascii=False),b.get('series'),b.get('series_index')] for i,b in enumerate(r,1)]); f.close(); print(len(r),'cache rows exported')" "metadata-copy.json" "device-cache.csv"
六列依次为 row、lpath、title、authors_json、series、series_index。作者作为一个 JSON 值放在同一单元格,多名作者不会扩成多行;null 表示缓存没有值。row 只是当前快照中的位置,不是永久书籍编号。缺失的系列字段保持空白,小数系列序号也保留。输入不合要求或目标文件已存在会报错:检查输入或另选输出名,不要靠删除源缓存解决。
按文本导入并核对清单
在 LibreOffice Calc 选择“文件 > 打开”和“文本 CSV”。文本导入窗口选择 UTF-8、逗号分隔及直双引号作为文本分隔符。关闭“合并分隔符”“修剪空格”和“计算公式”,把预览中的六列都设为“文本”后确认。窗口未出现时,在打开文件窗口启用“编辑筛选器设置”。这样能保留元数据字符串,避免以 = 开头的书名变成公式。
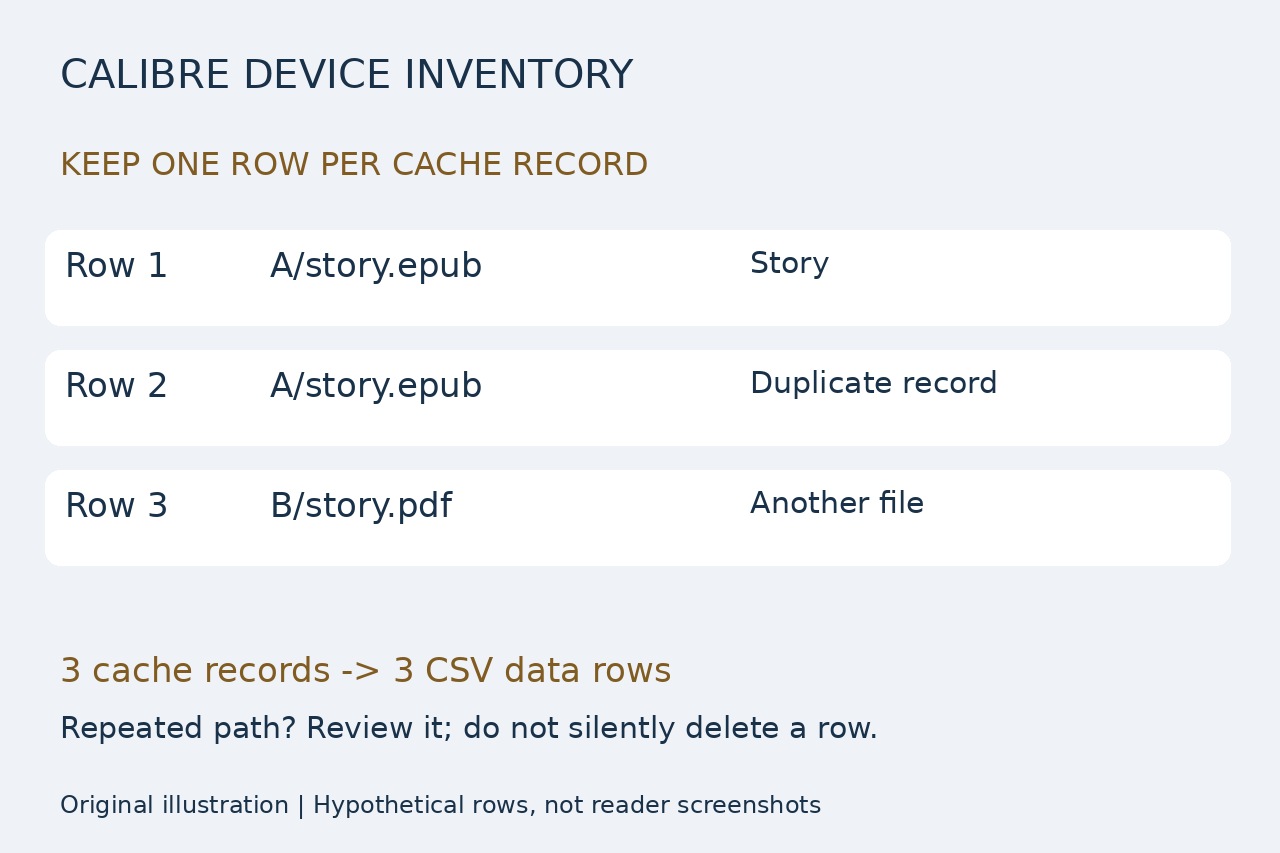
把命令打印的缓存行数与 CSV 数据行数对照,不包含表头。图示的模拟样本有三条缓存记录,即使两条路径相同,也必须得到三行。不要数文本文件的物理行:带引号的书名可能包含换行。先保留重复记录,再调查原因。核对熟悉的书名、完整 lpath,以及该路径在记录的原存储位置中的实际文件;复制缓存不会改变路径的起点。
明确清单无法证明什么
Device 视图中有条目未列出或数量不符时,检查筛选、所选存储、扫描是否结束及缓存时间。USB 大容量存储驱动只扫描配置的目录和支持的格式,并不是通用全盘扫描。旧缓存可能还记着已删除文件。同一书名的两种格式是两个文件记录;书名相同不能证明是同一本书,也不能证明已在当前电脑书库中。
KOReader 也能写入并精简这些缓存,所以自定义元数据缺失不代表电子书消失。保留原 JSON 和 CSV,注明存储位置与复制时间。我们实际测试了这条转换命令,模拟样本覆盖 Unicode、逗号、多行书名、空作者、小数序号、重复路径、空数组、无效输入和拒绝覆盖;没有测试实体阅读器或 Calc 界面。需要电子书备份或云端书库清单时,仅凭这张表不够。