Tecnología · GUÍA PRÁCTICA
¿Faltan libros del lector en el CSV de Calibre? Exporta un inventario de la caché
El catálogo del PC puede omitir libros que solo están en el lector. Convierte una copia de la caché y comprueba filas, almacenamiento e importación.
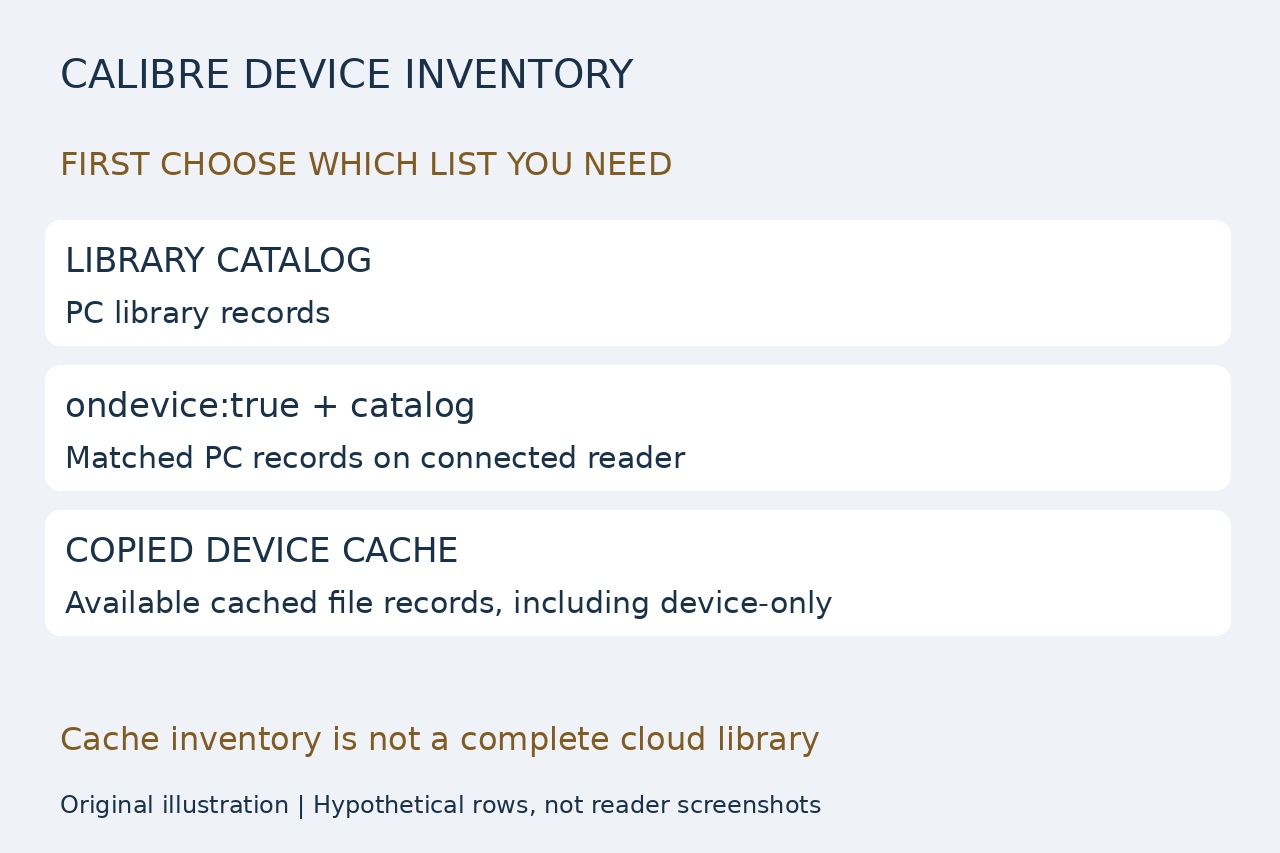
Si quieres una lista CSV de los libros del lector, el catálogo de la biblioteca del ordenador puede ser la lista equivocada. Filtrar esa biblioteca con ondevice:true sigue partiendo de sus propios registros: no añade los libros que solo existen en el dispositivo.
Si tienes un archivo metadata.calibre o .metadata.calibre existente y legible, el método siguiente procesa una copia y exporta los registros disponibles sin importar el contenido de los libros al PC. Es un inventario de la caché; no garantiza enumerar todas las compras en la nube ni todos los archivos de cualquier lector.
Anota el almacenamiento y copia la caché
Usa esta vía solo si el dispositivo o una carpeta gestionada ofrece una caché JSON local con el formato de Calibre. Espera a que termine el escaneo del dispositivo y los trabajos existentes, anota el almacenamiento elegido y el recuento de la vista Device sin filtros; después cierra las aplicaciones que puedan reescribir la caché. Un escaneo normal puede actualizarla; el conversor solo lee tu copia del ordenador. No es una adquisición forense enteramente de solo lectura.
Copia la caché a una carpeta nueva del PC como metadata-copy.json y conserva el original en su sitio. Anota su directorio original, la etiqueta del almacenamiento y la hora de la copia. La memoria principal y una tarjeta pueden tener cachés separadas: procésalas por separado con nombres de salida distintos. Si no hay caché legible, detén este método; no llames inventario completo del lector a una exportación de la biblioteca del PC. No sustituyas metadata.db por este JSON.
Exporta una fila CSV por registro de la caché
Con Python 3 ya instalado, abre una terminal en la carpeta de la copia. En Windows sustituye python3 por py -3. Copia el siguiente comando en una sola línea, conserva las comillas rectas y elige un nombre de salida nuevo. Exige un array JSON con registros cuyo lpath sea una cadena, conserva todos los registros y rechaza sobrescribir un CSV existente.
python3 -c "import csv,json,sys; r=json.load(open(sys.argv[1],encoding='utf-8-sig')); assert isinstance(r,list) and all(isinstance(b,dict) and isinstance(b.get('lpath'),str) for b in r), 'Expected an array of records with lpath'; f=open(sys.argv[2],'x',encoding='utf-8-sig',newline=''); w=csv.writer(f); w.writerow(['row','lpath','title','authors_json','series','series_index']); w.writerows([[i,b['lpath'],b.get('title'),json.dumps(b.get('authors'),ensure_ascii=False),b.get('series'),b.get('series_index')] for i,b in enumerate(r,1)]); f.close(); print(len(r),'cache rows exported')" "metadata-copy.json" "device-cache.csv"
Las columnas son row, lpath, title, authors_json, series y series_index. Los autores quedan como un valor JSON en una celda; varios autores no multiplican las filas y null indica que no hay valor en la caché. row es una posición en esta instantánea, no un identificador permanente del libro. Los campos de serie ausentes quedan vacíos y se conserva un índice fraccionario. Una caché inválida o un destino existente produce un error: revisa la entrada o elige otro nombre; no borres la caché original para arreglarlo.
Importa texto y verifica la lista
En LibreOffice Calc, elige Archivo > Abrir y Texto CSV. En Importación de texto selecciona UTF-8, coma como separador y comillas dobles rectas como delimitador de texto. Desactiva Combinar delimitadores, Recortar espacios y Evaluar fórmulas; configura las seis columnas de la vista previa como Texto antes de aceptar. Si no aparece el diálogo, activa Editar configuración de filtros al abrir. Así conservas las cadenas y evitas convertir un título que empiece por = en una fórmula.
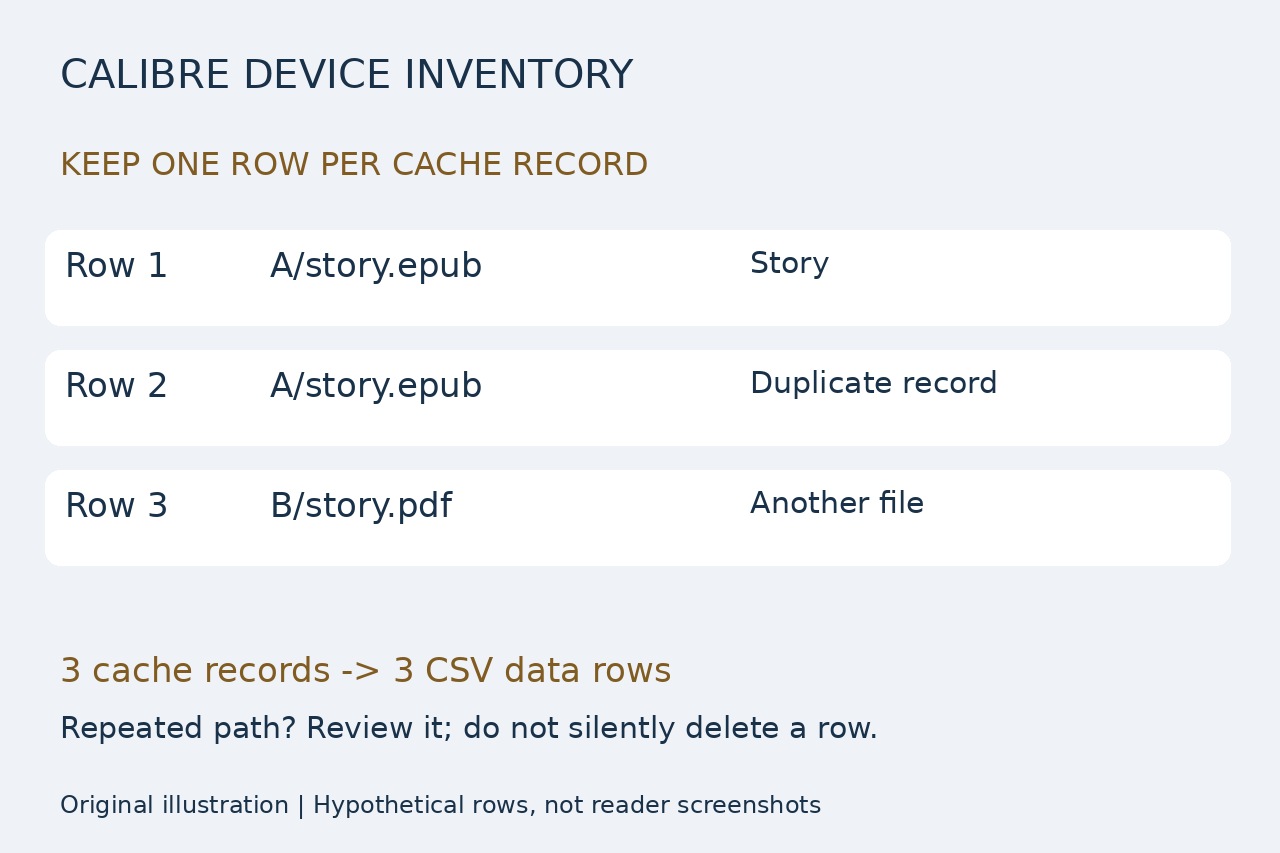
Compara el recuento impreso de registros con las filas de datos del CSV, sin la cabecera. En el ejemplo sintético ilustrado, tres registros deben producir tres filas, aunque dos rutas se repitan. No cuentes líneas físicas del archivo: un título entrecomillado puede contener un salto de línea. Conserva los duplicados hasta investigarlos. Comprueba un título conocido, su lpath completo y el archivo real en el almacenamiento original registrado; copiar la caché no cambia el origen de esa ruta.
Qué no demuestra este inventario
Si falta una entrada de Device o no coinciden los recuentos, investiga filtros, almacenamiento elegido, finalización del escaneo y antigüedad de la caché. El controlador USB de almacenamiento masivo escanea directorios configurados y formatos admitidos; no es un escaneo universal del disco. Una caché antigua puede guardar archivos eliminados. Dos formatos del mismo título son registros de archivo distintos; títulos iguales no prueban que sean el mismo libro ni que estén en tu biblioteca actual del PC.
KOReader también puede escribir y simplificar estas cachés; que falten metadatos personalizados no demuestra que desapareciera el libro. Conserva el JSON original junto al CSV y etiqueta el resultado con almacenamiento y hora de copia. Probamos este comando exacto con datos sintéticos: Unicode, comas, títulos multilínea, autores null, índices fraccionarios, rutas duplicadas, arrays vacíos, entradas inválidas y rechazo de sobrescritura. No probamos un lector físico ni la interfaz de Calc. Para una copia de los libros o un inventario de la nube, esta lista no basta.