科技 · 新聞解讀
Cadence Maestro 可在本地執行晶片設計 AI,但最大效能提升仍是廠商主張
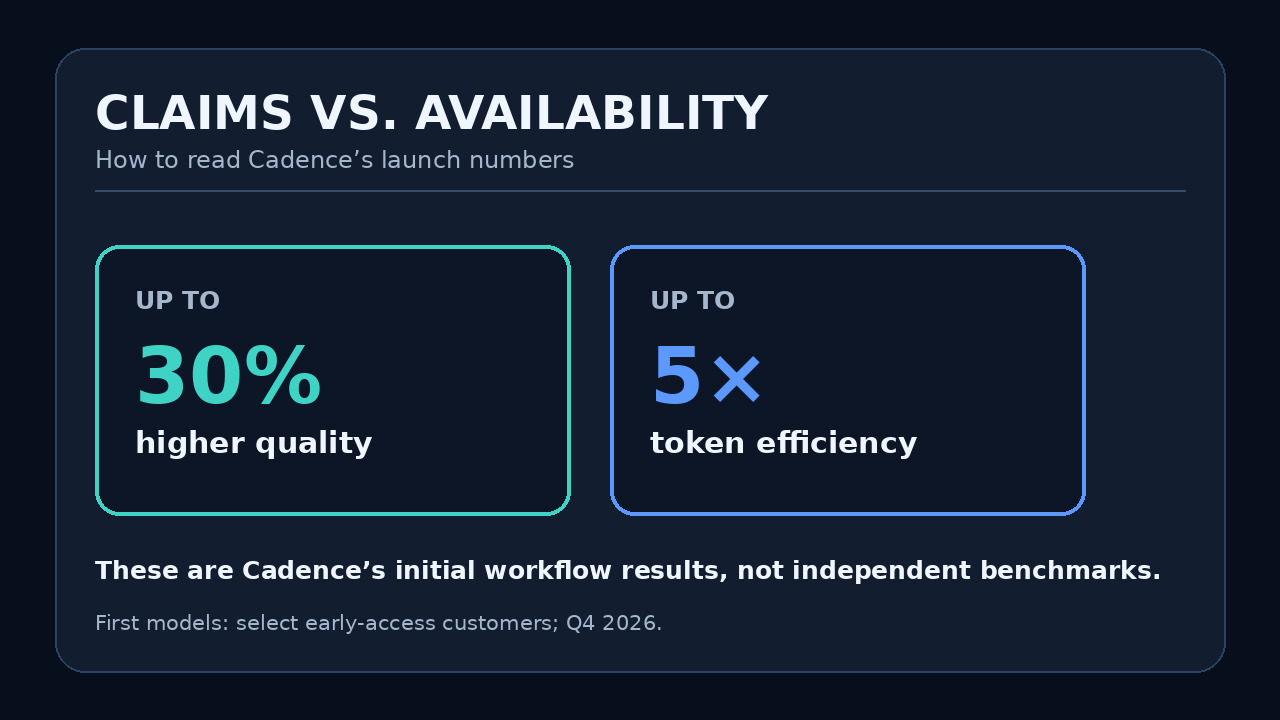
Cadence 稱 Maestro 可部署在客戶自控資料中心,並帶來最高30%品質提升與5倍 token 效率;目前僅限早期客戶,獨立基準尚未公開。
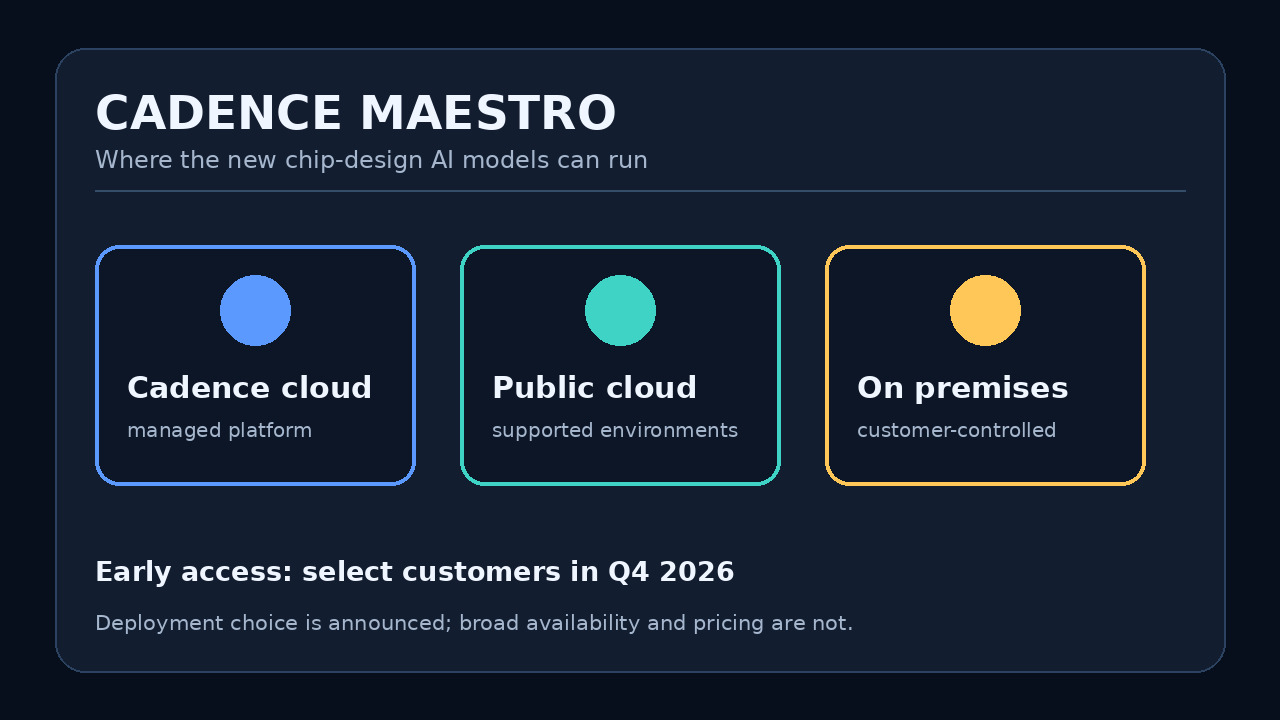
Cadence 推出 Maestro 專用 AI 模型組合,服務半導體與系統設計,可在雲端或客戶自有基礎設施內執行。部署選項已明確,但首批只向部分早期客戶開放。
最醒目的效能數字需要標明來源:它們是 Cadence 的初始工作流程結果,不是廣泛獨立基準。買方仍需核實模型、定價、安全與自身工作負載資料。
Cadence 發布了什麼
Maestro 是面向晶片與系統設計的專用模型組合,包含後訓練語言模型、決策模型與自我改進代理技能。
客戶可以在哪裡執行
完整環境可執行於 Cadence 雲、公有雲或客戶自控本地基礎設施;客戶也可用自有晶片設計進行微調。
Nvidia 扮演什麼角色
組合採用 Nvidia Nemotron 與 OpenShell 安全架構,但 Cadence 將其描述為模型無關方案,而非只綁定單一供應商。
效能數字怎麼讀
最高30%品質提升與5倍 token 效率來自 Cadence 初始工作流程;發布資料沒有獨立基準套件、逐客戶結果或價格。
可用性比發布範圍更窄
首批模型僅計畫在第四季向部分早期客戶開放,這不是全面上市日期,也沒有統一價格或完整資格清單。
工程團隊接下來應核實什麼
應核實實際交付模型、部署配置、資料保留、微調邊界、授權、基準定義及自有工作流程結果。