科技 · 新闻解读
Cadence Maestro 可在本地运行芯片设计 AI,但最大性能提升仍是厂商主张
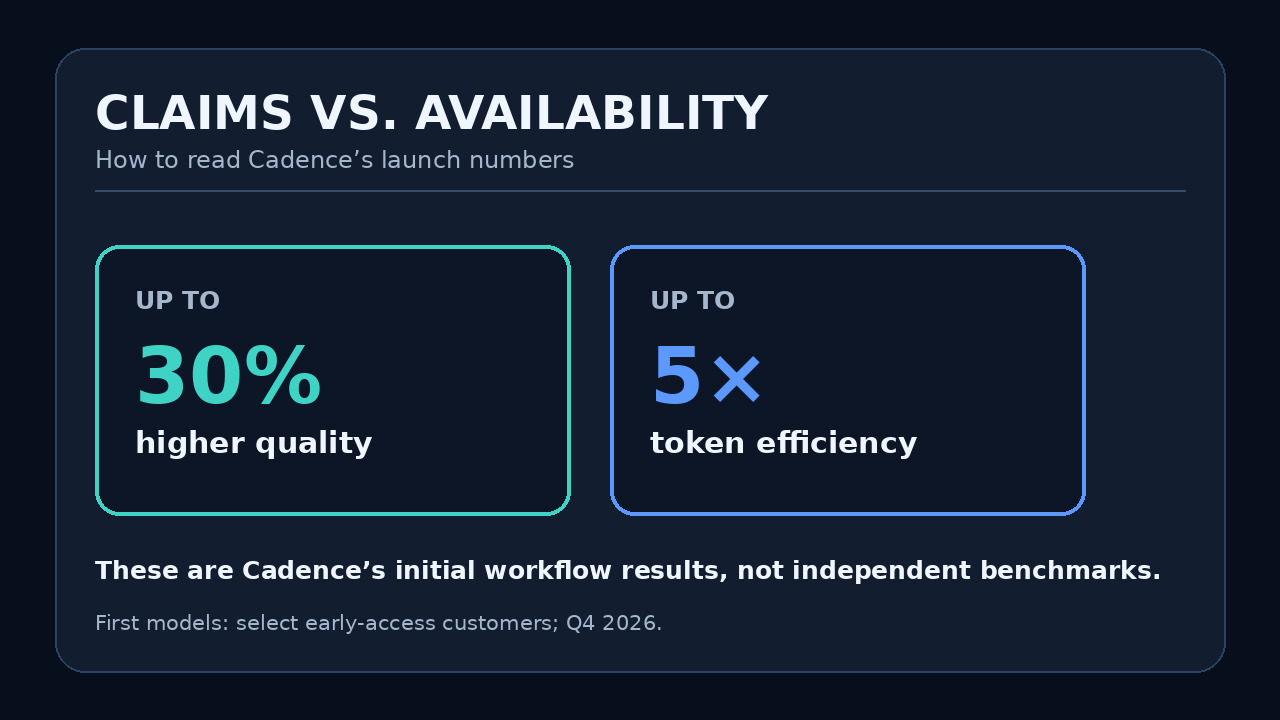
Cadence 称 Maestro 可部署在客户自控数据中心,并带来最高30%质量提升和5倍 token 效率;目前仅限早期客户,独立基准尚未公开。
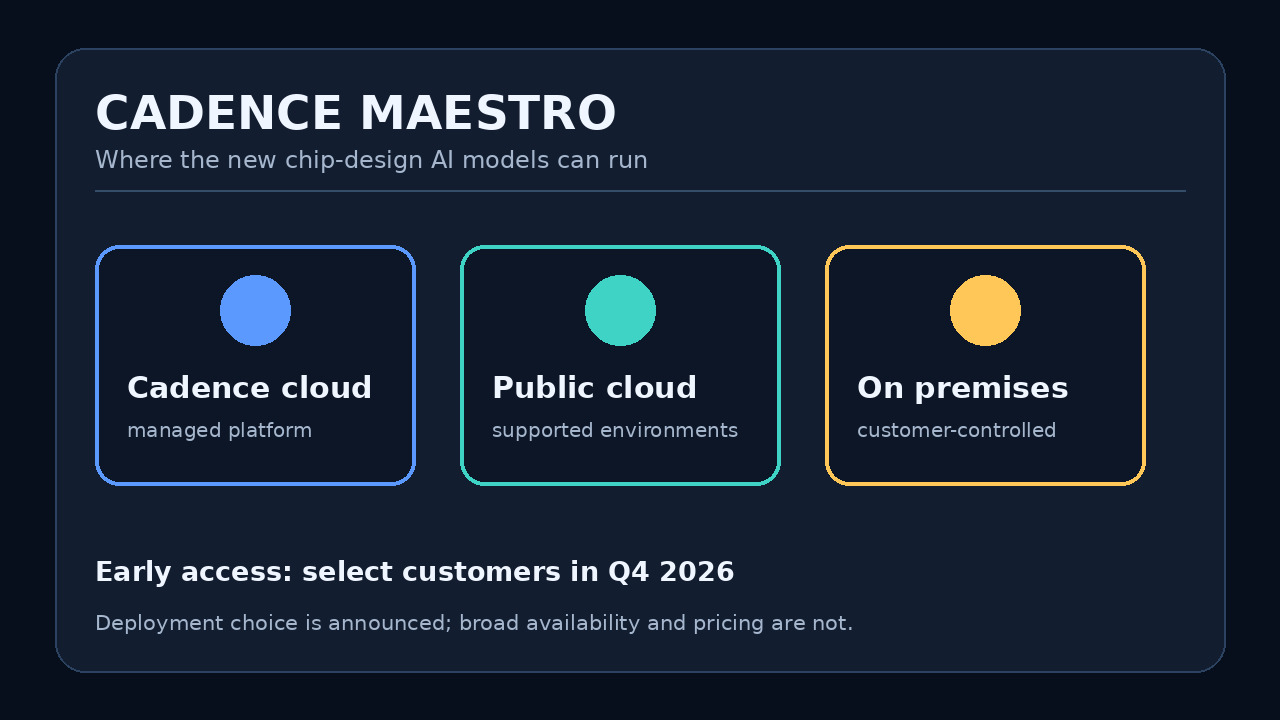
Cadence 推出 Maestro 专用 AI 模型组合,服务于半导体与系统设计,可在云端或客户自有基础设施内运行。部署选项已经明确,但首批只向部分早期客户开放。
最醒目的性能数字需要注明来源:它们是 Cadence 的初始工作流结果,不是广泛独立基准。买方仍需核实模型、定价、安全与自身负载数据。
Cadence 发布了什么
Maestro 是面向芯片与系统设计的专用模型组合,含后训练语言模型、决策模型和自改进代理技能。
客户可以在哪里运行
完整环境可运行于 Cadence 云、公有云或客户自控本地基础设施;客户还可用自有芯片设计进行微调。
Nvidia 扮演什么角色
组合采用 Nvidia Nemotron 与 OpenShell 安全架构,但 Cadence 将其描述为模型无关方案,而非只绑定一家提供商。
性能数字怎么读
最高30%质量提升与5倍 token 效率来自 Cadence 初始工作流;发布材料没有独立基准套件、逐客户结果或价格。
可用性比发布范围更窄
首批模型仅计划在第四季度向部分早期客户开放,这不是全面上市日期,也没有统一价格或完整资格清单。
工程团队接下来应核实什么
应核实实际交付模型、部署配置、数据保留、微调边界、许可、基准定义及自有工作流结果。