기술 · 뉴스 해설
Cadence Maestro, 칩 설계 AI를 온프레미스로…최대 성능 향상은 아직 업체 주장
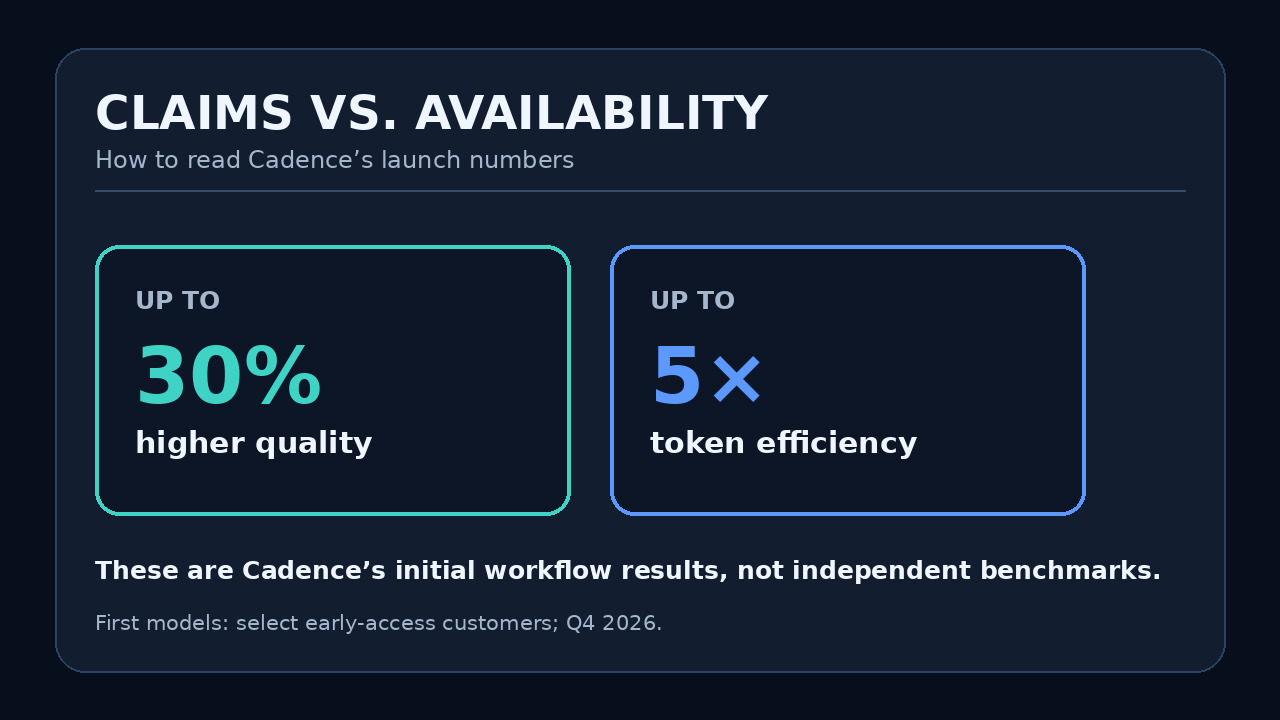
Cadence는 고객 통제 데이터센터 배포와 품질 최대30%·토큰 효율 최대5배를 제시했지만 초기 접근은 제한적이고 독립 벤치마크는 공개되지 않았다.
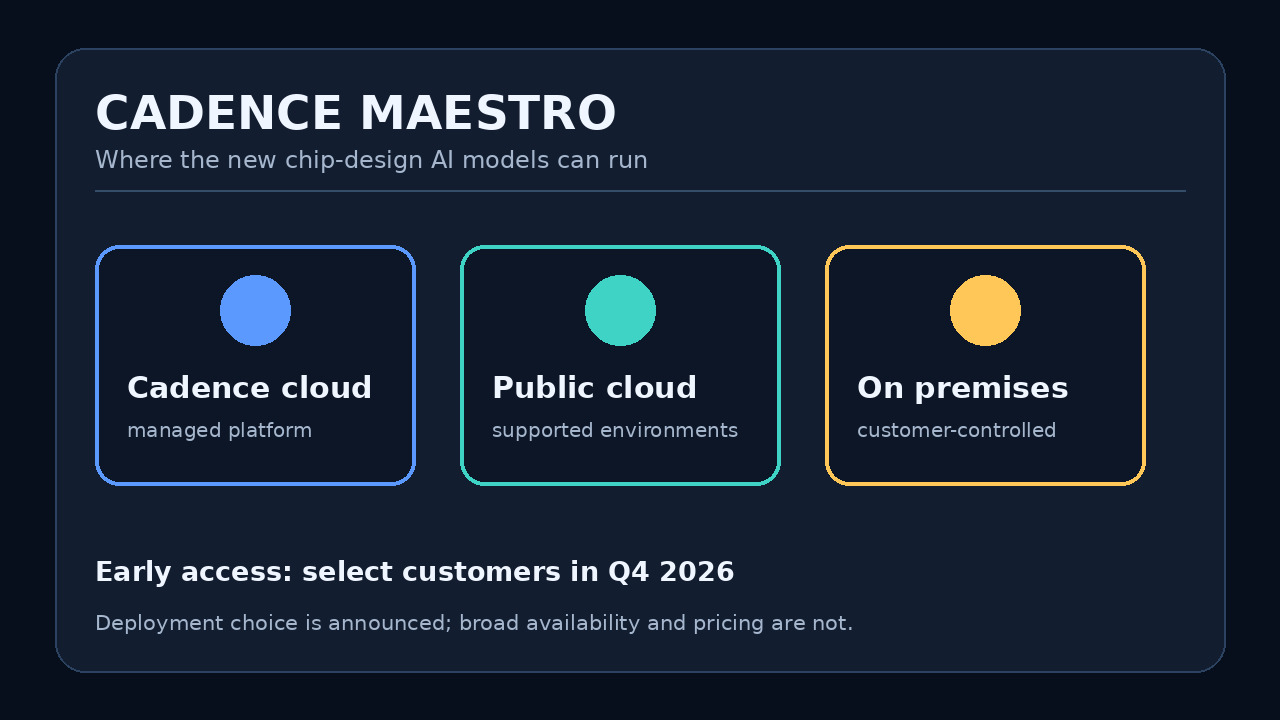
Cadence가 반도체·시스템 설계용 특화 AI 모델 포트폴리오 Maestro를 공개했다. 클라우드뿐 아니라 고객 인프라에서도 실행할 수 있지만 첫 제공은 일부 고객의 조기 접근이다.
핵심 성능 수치는 Cadence의 초기 워크플로 결과이며 광범위한 독립 검증이 아니다. 구매자는 모델, 가격, 보안, 자체 작업 결과를 확인해야 한다.
무엇을 출시했나
Maestro는 사후 학습 언어 모델, 의사결정 모델, 자기개선 에이전트 기술을 결합한 설계용 포트폴리오다.
어디서 실행할 수 있나
Cadence 클라우드, 공용 클라우드, 고객 온프레미스에서 실행하고 고객 설계로 추가 학습할 수 있다고 한다.
Nvidia의 역할
Nemotron과 OpenShell을 쓰지만 Cadence는 한 공급자에 묶이지 않는 모델 중립 구상이라고 설명한다.
성능 수치 읽는 법
최대30%와 5배는 초기 워크플로 결과다. 독립 시험 세트, 고객별 결과, 가격은 공개되지 않았다.
가용성은 제한적
4분기 일부 고객 조기 접근이며 일반 출시일, 공통 가격, 전체 자격 목록은 없다.
다음 확인 항목
실제 모델, 배포 구성, 데이터 보존, 추가 학습 경계, 라이선스, 평가 정의, 자체 흐름 결과를 확인해야 한다.